
Python RegEx: re.match(), re.search(), re.findall() พร้อมตัวอย่าง
 แอนนา เบลค
⚡ สรุปอย่างชาญฉลาด
Python บทเรียนเรื่องนิพจน์ปกติ (Regular Expressions Tutorial) จะครอบคลุมการใช้งาน re.match, re.search, re.findall และ re.split พร้อมตัวอย่างเชิงปฏิบัติ Lessอธิบายเกี่ยวกับอักขระพิเศษ คลาสอักขระ กลุ่ม แฟล็ก การแทนที่ และรูปแบบทั่วไปสำหรับการแยกวิเคราะห์และการตรวจสอบความถูกต้องของข้อความ
Regular Expression คืออะไร Python?
A นิพจน์ทั่วไป (RE) ในภาษาโปรแกรมมิ่ง สตริงข้อความพิเศษนี้ใช้สำหรับอธิบายรูปแบบการค้นหา มันมีประโยชน์อย่างมาก เช่นtracดึงข้อมูลจากข้อความ เช่น โค้ด ไฟล์ บันทึก สเปรดชีต หรือแม้แต่เอกสาร
ในขณะที่ใช้ Python นิพจน์ทั่วไป สิ่งแรกที่ต้องจดจำคือทุกสิ่งโดยพื้นฐานแล้วคืออักขระ และเรากำลังเขียนรูปแบบเพื่อให้ตรงกับลำดับอักขระเฉพาะที่เรียกว่าสตริง ตัวอักษร Ascii หรือละตินคือตัวอักษรที่อยู่บนคีย์บอร์ดของคุณ และใช้ Unicode เพื่อจับคู่ข้อความภาษาต่างประเทศ ประกอบด้วยตัวเลข เครื่องหมายวรรคตอน และอักขระพิเศษทั้งหมด เช่น $#@!% เป็นต้น
ตัวอย่างเช่น Python นิพจน์ทั่วไปสามารถบอกให้โปรแกรมค้นหาข้อความเฉพาะจากสตริงแล้วพิมพ์ผลลัพธ์ตามนั้น นิพจน์อาจรวมถึง
- การจับคู่ข้อความ
- การทำซ้ำ
- การแตกแขนง
- ลวดลาย-องค์ประกอบ ฯลฯ
นิพจน์ทั่วไปหรือ RegEx ใน Python แสดงว่าเป็น RE (REs, regexes หรือรูปแบบ regex) ที่นำเข้าผ่าน โมดูลอีกครั้ง. Python รองรับการแสดงออกปกติผ่านไลบรารี RegEx ใน Python รองรับสิ่งต่าง ๆ เช่น ตัวแก้ไข ตัวระบุ และอักขระช่องว่าง.
| ตัวบ่งชี้ | ตัวปรับเปลี่ยน | อักขระช่องว่าง | จำเป็นต้องหลบหนี |
|---|---|---|---|
| \d= ตัวเลขใดๆ (ตัวเลข) | \d แสดงถึงตัวเลข เช่น \d{1,5} มันจะประกาศตัวเลขระหว่าง 1,5 เช่น 424,444,545 เป็นต้น | \n = ขึ้นบรรทัดใหม่ | - - - - |
| \D= อะไรก็ได้ที่ไม่ใช่ตัวเลข (ไม่ใช่ตัวเลข) | + = ตรงกับ 1 หรือมากกว่า | \s= ช่องว่าง | |
| \s = ช่องว่าง (แท็บ ช่องว่าง ขึ้นบรรทัดใหม่ ฯลฯ) |
- = ตรงกับ 0 หรือ 1 | \t =แท็บ | |
| \S= อะไรก็ได้ยกเว้นช่องว่าง | * = 0 หรือมากกว่า | \e = หลบหนี | |
| \w = ตัวอักษร ( จับคู่ตัวอักษรและตัวเลข รวมถึง “_”) | $ จับคู่จุดสิ้นสุดของสตริง | \r = การคืนรถ | |
| \W =อะไรก็ได้ยกเว้นตัวอักษร ( จับคู่อักขระที่ไม่ใช่ตัวอักษรและตัวเลข ยกเว้น “_”) | ^ จับคู่จุดเริ่มต้นของสตริง | \f= ฟีดแบบฟอร์ม | |
| - = อะไรก็ได้ยกเว้นตัวอักษร (จุด) | - ตรงกับอย่างใดอย่างหนึ่งหรือ x/y | ------ | |
| \b = อักขระใดๆ ยกเว้นบรรทัดใหม่ | [] = พิสัยหรือ “ความแปรปรวน” | ------ | |
| \. | {x} = จำนวนโค้ดก่อนหน้านี้ | ------ |
ไวยากรณ์นิพจน์ทั่วไป (RE)
import re
- มีโมดูล “re” รวมอยู่ด้วย Python ใช้เป็นหลักในการค้นหาและจัดการสตริง
- ยังใช้บ่อยสำหรับหน้าเว็บ”สคราping" (อดีตtrac(ข้อมูลจำนวนมากจากเว็บไซต์)
เราจะเริ่มบทเรียนเกี่ยวกับนิพจน์ด้วยแบบฝึกหัดง่ายๆ นี้โดยใช้นิพจน์ (w+) และ (^)
ตัวอย่างของนิพจน์ w+ และ ^
- - นิพจน์นี้ตรงกับจุดเริ่มต้นของสตริง
- “ว+“: นิพจน์นี้ตรงกับอักขระตัวอักษรและตัวเลขในสตริง
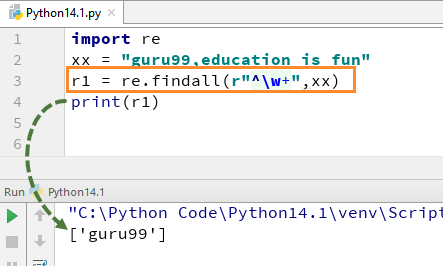
ที่นี่เราจะเห็นก Python RegEx ตัวอย่างวิธีที่เราสามารถใช้นิพจน์ w+ และ ^ ในโค้ดของเรา เราพูดถึงฟังก์ชัน re.findall() ใน Pythonในบทช่วยสอนนี้ในภายหลัง แต่ในขณะนี้เราจะเน้นเฉพาะนิพจน์ \w+ และ \^ เท่านั้น
ตัวอย่างเช่น สำหรับสตริงของเรา “guru99, educational is fun” ถ้าเรารันโค้ดด้วย w+ และ^ มันจะให้ผลลัพธ์เป็น “guru99”
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+",xx)
print(r1)
โปรดจำไว้ว่า หากคุณลบเครื่องหมาย + ออกจาก w+ ผลลัพธ์จะเปลี่ยน และจะให้เฉพาะอักขระตัวแรกของตัวอักษรตัวแรก เช่น [g]
ตัวอย่างนิพจน์ \s ในฟังก์ชัน re.split
- “s”: สำนวนนี้ใช้สำหรับสร้างช่องว่างในสตริง
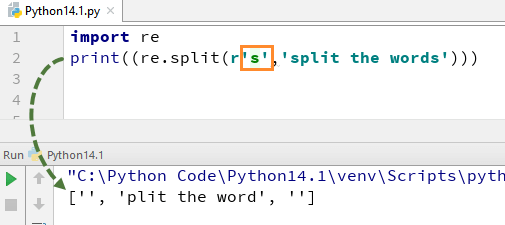
เพื่อทำความเข้าใจว่า RegEx นี้เข้ามาได้อย่างไร Python งานเราเริ่มต้นด้วยความเรียบง่าย Python RegEx ตัวอย่างของฟังก์ชันแยก ในตัวอย่าง เราได้แยกแต่ละคำโดยใช้ฟังก์ชัน "re.split" และในขณะเดียวกัน เราก็ใช้นิพจน์ \s ที่ช่วยให้แยกแต่ละคำในสตริงแยกกัน

เมื่อคุณรันโค้ดนี้ มันจะให้ผลลัพธ์ ['we', 'are', 'splitting', 'the', 'words']
ตอนนี้มาดูว่าจะเกิดอะไรขึ้นถ้าคุณลบ “\” ออกจาก s ไม่มีตัวอักษร 's' ในเอาต์พุต เนื่องจากเราได้ลบ '\' ออกจากสตริงแล้ว และจะประเมิน "s" เป็นอักขระปกติ และด้วยเหตุนี้จึงแยกคำทุกที่ที่พบ "s" ในสตริง
ในทำนองเดียวกันก็มีซีรีส์อื่นๆ Python นิพจน์ทั่วไปที่คุณสามารถนำมาใช้ในรูปแบบต่างๆ ได้ Python เช่น \d,\D,$,\.,\b เป็นต้น
นี่คือรหัสที่สมบูรณ์
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+", xx)
print((re.split(r'\s','we are splitting the words')))
print((re.split(r's','split the words')))
ต่อไปเราจะมาดูประเภทของวิธีการที่ใช้กับนิพจน์ทั่วไปค่ะ Python.
การใช้วิธีการแสดงออกปกติ
แพ็คเกจ “re” มีหลายวิธีในการสืบค้นข้อมูลในสตริงอินพุต เราจะมาดูวิธีการรีอินกัน Python:
- รีแมตช์()
- วิจัย()
- อีกครั้งค้นหา()
หมายเหตุ: ตามนิพจน์ทั่วไป Python มีการดำเนินการพื้นฐานสองแบบที่แตกต่างกัน วิธีการจับคู่จะตรวจสอบการจับคู่เฉพาะที่จุดเริ่มต้นของสตริงเท่านั้น ในขณะที่การค้นหาจะตรวจสอบการจับคู่ในทุกที่ของสตริง
รีแมตช์()
รีแมตช์() ฟังก์ชันของรีอิน Python จะค้นหารูปแบบนิพจน์ทั่วไปและส่งคืนรายการแรก ที่ Python วิธีการจับคู่ RegEx จะตรวจสอบการจับคู่เฉพาะที่จุดเริ่มต้นของสตริงเท่านั้น ดังนั้น หากพบรายการที่ตรงกันในบรรทัดแรก ก็จะส่งคืนออบเจ็กต์การจับคู่ แต่หากพบการแข่งขันในบรรทัดอื่น Python ฟังก์ชันการจับคู่ RegEx ส่งคืนค่าว่าง
ตัวอย่างเช่น พิจารณาโค้ดต่อไปนี้ Python ฟังก์ชัน re.match() นิพจน์ “w+” และ “\W” จะจับคู่คำที่ขึ้นต้นด้วยตัวอักษร 'g' และหลังจากนั้น สิ่งใดก็ตามที่ไม่ได้ขึ้นต้นด้วย 'g' จะไม่ถูกระบุ ในการตรวจสอบการจับคู่สำหรับแต่ละองค์ประกอบในรายการหรือสตริง เราจะเรียกใช้ forloop ในสิ่งนี้ Python re.match() ตัวอย่าง

re.search(): ค้นหารูปแบบในข้อความ
วิจัย() ฟังก์ชั่นจะค้นหารูปแบบนิพจน์ทั่วไปและส่งคืนรายการแรก ไม่เหมือน Python re.match() มันจะตรวจสอบทุกบรรทัดของสตริงอินพุต ที่ Python ฟังก์ชัน re.search() ส่งคืนวัตถุที่ตรงกันเมื่อพบรูปแบบ และส่งคืน "null" หากไม่พบรูปแบบ
จะใช้การค้นหา() ได้อย่างไร?
หากต้องการใช้ฟังก์ชัน search() คุณต้องนำเข้า Python re module ก่อนแล้วจึงรันโค้ด ที่ Python ฟังก์ชัน re.search() ใช้ "รูปแบบ" และ "ข้อความ" เพื่อสแกนจากสตริงหลักของเรา
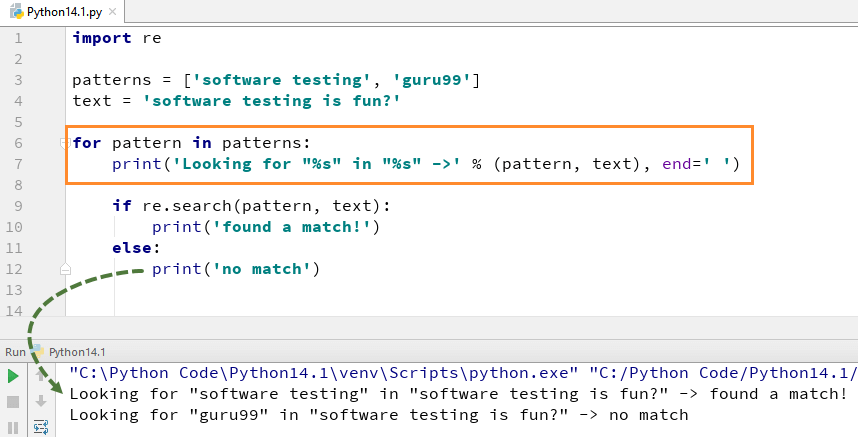
ตัวอย่างเช่นที่นี่ เรามองหาสตริงตัวอักษรสองสตริง “การทดสอบซอฟต์แวร์” “guru99” ในสตริงข้อความ “ซอฟต์แวร์ การทดสอบ มันสนุก” สำหรับ "การทดสอบซอฟต์แวร์" เราพบการจับคู่ดังนั้นจึงส่งคืนผลลัพธ์ของ Python re.search() ตัวอย่างเป็น “found a match” ในขณะที่สำหรับคำว่า “guru99” เราไม่พบในสตริง ดังนั้นจึงส่งคืนผลลัพธ์เป็น “No match”
อีกครั้งค้นหา()
ค้นหาทั้งหมด () โมดูลนี้ใช้สำหรับค้นหา "ทุก" รายการที่ตรงกับรูปแบบที่กำหนด ในทางตรงกันข้าม โมดูล search() จะคืนค่าเฉพาะรายการแรกที่ตรงกับรูปแบบที่ระบุเท่านั้น ส่วน findall() จะวนซ้ำไปทุกบรรทัดในไฟล์และจะคืนค่าเฉพาะรายการที่ไม่ทับซ้อนกันping การจับคู่รูปแบบในขั้นตอนเดียว
วิธีใช้ re.findall() ใน Python?
ที่นี่เรามีรายการที่อยู่อีเมล และเราต้องการดึงที่อยู่อีเมลทั้งหมดออกมาจากรายการ เราใช้วิธี re.findall() ใน Pythonมันจะค้นหาที่อยู่อีเมลทั้งหมดจากรายการ
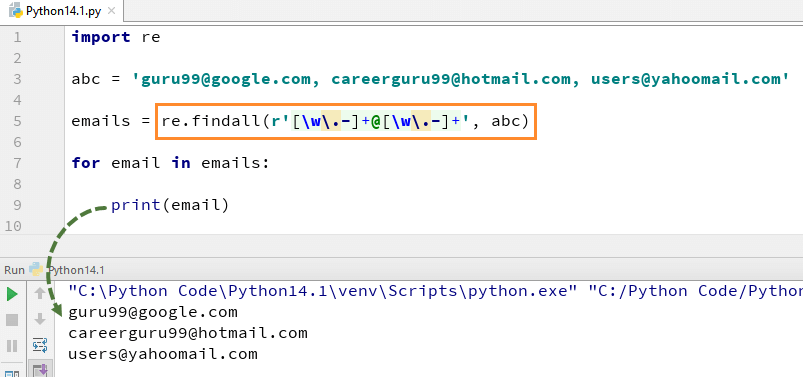
นี่คือโค้ดที่สมบูรณ์สำหรับตัวอย่างของ re.findall()
import re

list = ["guru99 get", "guru99 give", "guru Selenium"]
for element in list:
    z = re.match("(g\w+)\W(g\w+)", element)
if z:
    print((z.groups()))

patterns = ['software testing', 'guru99']
text = 'software testing is fun?'
for pattern in patterns:
    print('Looking for "%s" in "%s" ->' % (pattern, text), end=' ')
    if re.search(pattern, text):
        print('found a match!')
else:
    print('no match')
abc = 'guru99@google.com, careerguru99@hotmail.com, users@yahoomail.com'
emails = re.findall(r'[\w\.-]+@[\w\.-]+', abc)
for email in emails:
    print(email)
Python ธง
หลาย Python วิธีการ Regex และฟังก์ชัน Regex รับอาร์กิวเมนต์ทางเลือกที่เรียกว่า Flags ธงนี้สามารถปรับเปลี่ยนความหมายของสิ่งที่กำหนดได้ Python รูปแบบ Regex เพื่อทำความเข้าใจสิ่งเหล่านี้ เราจะเห็นตัวอย่างหนึ่งหรือสองตัวอย่างของธงเหล่านี้
ธงต่างๆ ที่ใช้ใน Python รวมถึง
| ไวยากรณ์สำหรับการตั้งค่าสถานะ Regex | ธงนี้ทำอะไร |
|---|---|
| [re.M] | ให้เริ่มต้น/สิ้นสุดพิจารณาแต่ละบรรทัด |
| [อีกครั้งฉัน] | มันไม่สนใจกรณี |
| [อีกครั้ง] | ทำ [ . - |
| [re.U] | ทำให้ { \w,\W,\b,\B} เป็นไปตามกฎ Unicode |
| [re.L] | ทำให้ {\w,\W,\b,\B} เป็นไปตามสถานที่ |
| [re.X] | อนุญาตให้แสดงความคิดเห็นใน Regex |
ตัวอย่างของ re.M หรือ Multiline Flags
ในรูปแบบหลายบรรทัด อักขระรูปแบบ [^] จะตรงกับอักขระตัวแรกของสตริงและจุดเริ่มต้นของแต่ละบรรทัด (ตามหลังอักขระขึ้นบรรทัดใหม่แต่ละบรรทัดทันที) ในขณะที่นิพจน์ “w” ตัวเล็กใช้เพื่อทำเครื่องหมายช่องว่างด้วยอักขระ เมื่อคุณรันโค้ด ตัวแปรตัวแรก “k1” จะพิมพ์เฉพาะอักขระ 'g' สำหรับคำ guru99 เท่านั้น ในขณะที่เมื่อคุณเพิ่มแฟล็กหลายบรรทัด แฟล็กจะดึงอักขระตัวแรกขององค์ประกอบทั้งหมดในสตริงออกมา
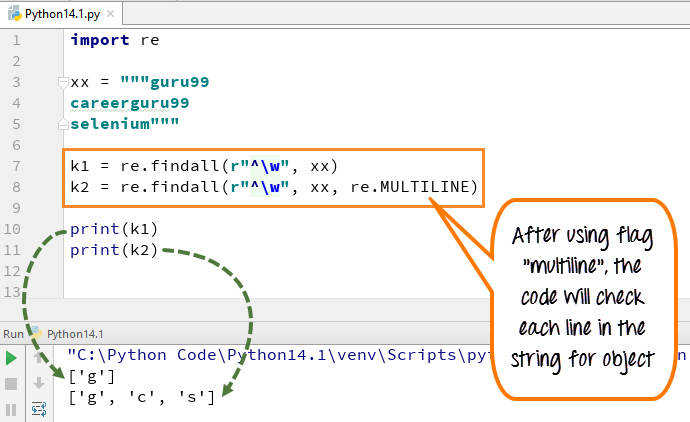
นี่คือรหัส
import re
xx = """guru99
careerguru99
selenium"""
k1 = re.findall(r"^\w", xx)
k2 = re.findall(r"^\w", xx, re.MULTILINE)
print(k1)
print(k2)
- เราประกาศตัวแปร xx สำหรับสตริง "guru99…. careerguru99….selenium"
- เรียกใช้โค้ดโดยไม่ใช้ flags multiline โดยจะให้เอาต์พุตเพียง 'g' จากบรรทัดเท่านั้น
- เรียกใช้โค้ดด้วยแฟล็ก "multiline" เมื่อคุณพิมพ์ 'k2' มันจะให้ผลลัพธ์เป็น 'g', 'c' และ 's'
- ดังนั้นความแตกต่างที่เราเห็นหลังและก่อนที่จะเพิ่มหลายบรรทัดในตัวอย่างด้านบน
ในทำนองเดียวกันคุณยังสามารถใช้อื่น ๆ Python ตั้งค่าสถานะเช่น re.U (Unicode), re.L (ติดตามสถานที่), re.X (อนุญาตให้แสดงความคิดเห็น) ฯลฯ
Python 2 ตัวอย่าง
รหัสข้างต้นคือ Python 3 ตัวอย่าง หากคุณต้องการรันอิน Python 2 โปรดพิจารณาโค้ดต่อไปนี้
# Example of w+ and ^ Expression
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+",xx)
print r1

# Example of \s expression in re.split function
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+", xx)
print (re.split(r'\s','we are splitting the words'))
print (re.split(r's','split the words'))

# Using re.findall for text
import re

list = ["guru99 get", "guru99 give", "guru Selenium"]
for element in list:
    z = re.match("(g\w+)\W(g\w+)", element)
if z:
    print(z.groups())

patterns = ['software testing', 'guru99']
text = 'software testing is fun?'
for pattern in patterns:
    print 'Looking for "%s" in "%s" ->' % (pattern, text),
    if re.search(pattern, text):
        print 'found a match!'
else:
    print 'no match'
abc = 'guru99@google.com, careerguru99@hotmail.com, users@yahoomail.com'
emails = re.findall(r'[\w\.-]+@[\w\.-]+', abc)
for email in emails:
    print email

# Example of re.M or Multiline Flags
import re
xx = """guru99
careerguru99
selenium"""
k1 = re.findall(r"^\w", xx)
k2 = re.findall(r"^\w", xx, re.MULTILINE)
print k1
print k2
ทดสอบของคุณ Python สาระน่ารู้
1. ใช้ใช้วิธีใดในการค้นหาการเกิดขึ้นทั้งหมดของรูปแบบในสตริง
- วิจัย()
- รีแมตช์()
- อีกครั้งค้นหา()
- แยกอีกครั้ง()
2. คลาสอักขระ \d หมายถึงอะไรในนิพจน์ทั่วไป?
- ตัวเลขใดก็ได้ (0-9)
- อักขระที่ไม่ใช่ตัวเลข
- อักขระช่องว่างใด ๆ
- ตัวอักษรหรือตัวเลขใดๆ
3. คุณจะใช้ฟังก์ชันใดในการแบ่งสตริงตามช่องว่าง?
- re.split(r'\s', สตริง)
- re.findall(r'\w+', สตริง)
- re.match(r'\s+', สตริง)
- re.split(r'\w+', สตริง)
4. ความแตกต่างหลักระหว่าง re.match() และ re.search() คืออะไร
- re.match() จะค้นหารูปแบบในจุดเริ่มต้นของสตริง ในขณะที่ re.search() จะค้นหารูปแบบที่ใดก็ได้ในสตริง
- re.match() คืนค่าการจับคู่ทั้งหมด ในขณะที่ re.search() คืนค่าการจับคู่แรก
- re.search() เร็วกว่า re.match()
- ทั้งสองฟังก์ชันมีการทำงานในลักษณะเดียวกัน
