
บทเรียนเกี่ยวกับ NoSQL: ประเภทของฐานข้อมูล NoSQL และตัวอย่าง
 สตีเฟน ทเวน
⚡ สรุปอย่างชาญฉลาด
NoSQL คือระบบจัดการฐานข้อมูลที่ไม่ใช่เชิงสัมพันธ์ ซึ่งไม่ต้องการโครงสร้างข้อมูลที่ตายตัว หลีกเลี่ยงการเชื่อมต่อตาราง และสามารถขยายขนาดได้อย่างง่ายดาย เอกสารนี้จะอธิบายว่า NoSQL คืออะไร ทำไมจึงมีอยู่ ประวัติความเป็นมา คุณสมบัติ ประเภทฐานข้อมูลทั้งสี่ ทฤษฎี CAP ความสอดคล้องในที่สุด และข้อดีข้อเสียของ NoSQL
NoSQL คืออะไร?
ฐานข้อมูล NoSQL NoSQL คือระบบจัดการข้อมูลแบบไม่เชิงสัมพันธ์ที่ไม่จำเป็นต้องมีโครงสร้างข้อมูลตายตัว หลีกเลี่ยงการเชื่อมต่อตาราง และปรับขนาดได้ง่าย วัตถุประสงค์หลักของการใช้ฐานข้อมูล NoSQL คือการจัดเก็บข้อมูลแบบกระจายที่มีความต้องการจัดเก็บข้อมูลจำนวนมหาศาล NoSQL ถูกใช้สำหรับข้อมูลขนาดใหญ่และแอปพลิเคชันเว็บแบบเรียลไทม์ ตัวอย่างเช่น บริษัทต่างๆ เช่น Twitter, Facebook และ... Google รวบรวมข้อมูลผู้ใช้หลายเทราไบต์ทุกวัน
ฐานข้อมูล NoSQL NoSQL ย่อมาจาก “Not Only SQL” หรือ “Not SQL” แม้ว่าคำที่เหมาะสมกว่าคือ “NoREL” แต่ NoSQL ก็ได้รับความนิยมมากกว่า คาร์ล สโตรซซี เป็นผู้ริเริ่มแนวคิด NoSQL ในปี 1998
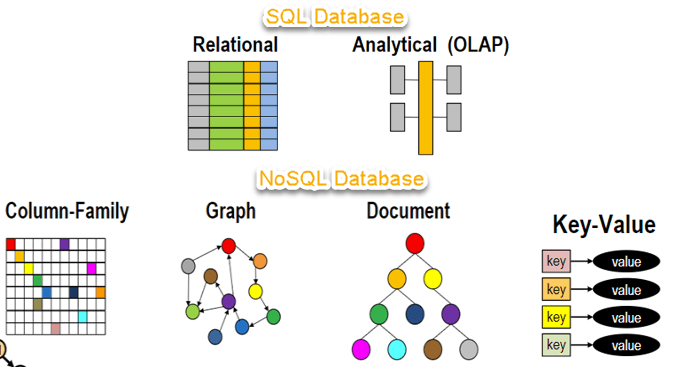
ระบบฐานข้อมูลเชิงสัมพันธ์แบบดั้งเดิม (RDBMS) ใช้ไวยากรณ์ SQL ในการจัดเก็บและเรียกใช้ข้อมูลเพื่อการวิเคราะห์เชิงลึก ในทางกลับกัน ระบบฐานข้อมูล NoSQL ครอบคลุมเทคโนโลยีฐานข้อมูลที่หลากหลาย ซึ่งสามารถจัดเก็บข้อมูลที่มีโครงสร้าง กึ่งโครงสร้าง ไม่มีโครงสร้าง และข้อมูลแบบหลายรูปแบบได้ มาทำความเข้าใจเกี่ยวกับ NoSQL ด้วยแผนภาพในบทเรียนฐานข้อมูล NoSQL นี้กัน:
ทำไมต้อง NoSQL?
แนวคิดของฐานข้อมูล NoSQL ได้รับความนิยมในหมู่บริษัทยักษ์ใหญ่ด้านอินเทอร์เน็ต เช่น Google, Facebook Amazonฯลฯ ที่ต้องจัดการกับข้อมูลจำนวนมหาศาล เวลาตอบสนองของระบบจะช้าเมื่อคุณใช้ RDBMS สำหรับข้อมูลจำนวนมาก
เพื่อแก้ไขปัญหานี้ เราสามารถ "ขยายขนาด" ระบบของเราโดยการอัพเกรดฮาร์ดแวร์ที่มีอยู่ของเรา กระบวนการนี้มีราคาแพง
ทางเลือกในการแก้ปัญหานี้คือการกระจายภาระงานของฐานข้อมูลไปยังโฮสต์หลายเครื่องเมื่อภาระงานเพิ่มขึ้น วิธีนี้เรียกว่า "การขยายขนาด" (scaling out)

ฐานข้อมูล NoSQL เป็นฐานข้อมูลที่ไม่ใช่เชิงสัมพันธ์ ดังนั้นจึงสามารถขยายขนาดได้ดีกว่าฐานข้อมูลเชิงสัมพันธ์ เนื่องจากได้รับการออกแบบโดยคำนึงถึงแอปพลิเคชันบนเว็บเป็นหลัก
ประวัติโดยย่อของฐานข้อมูล NoSQL
- ปี 1998 – คาร์โล สโตรซซี ใช้คำว่า NoSQL สำหรับฐานข้อมูลเชิงสัมพันธ์แบบโอเพนซอร์สที่มีน้ำหนักเบาของเขา
- 2000 – ฐานข้อมูลกราฟ Neo4j เปิดตัวแล้ว
- 2004 - Google BigTable เปิดตัวแล้ว
- 2005 - CouchDB มีการเปิดตัว
- ปี 2007 – บทความวิจัยเรื่อง Amazon Dynamo วางจำหน่ายแล้ว
- ปี 2008 – เฟซบุ๊กเปิดซอร์สโค้ด Cassandra โครงการ
- ปี 2009 – คำว่า NoSQL ถูกนำกลับมาใช้อีกครั้ง
คุณสมบัติของ NoSQL
ไม่สัมพันธ์กัน
- ฐานข้อมูล NoSQL ไม่เคยติดตาม โมเดลเชิงสัมพันธ์.
- ห้ามสร้างตารางที่มีข้อมูลแบบคอลัมน์คงที่แบบตายตัวเด็ดขาด
- ทำงานกับข้อมูลรวมแบบครบวงในตัวเอง หรือ BLOBs
- ไม่จำเป็นต้องใช้แผนที่ความสัมพันธ์ระหว่างวัตถุกับฐานข้อมูลping และการปรับข้อมูลให้เป็นมาตรฐาน
- ไม่มีคุณสมบัติที่ซับซ้อน เช่น ภาษาการสืบค้นข้อมูล ตัววางแผนการสืบค้นข้อมูล การเชื่อมต่อข้อมูลที่มีความสมบูรณ์ของข้อมูลอ้างอิง หรือ ACID
ไม่มีสคีมา
- ฐานข้อมูล NoSQL นั้นมีทั้งแบบที่ไม่มีโครงสร้างตายตัว หรือมีโครงสร้างที่ยืดหยุ่นกว่า
- ไม่จำเป็นต้องมีการกำหนดโครงสร้างข้อมูลใดๆ
- นำเสนอโครงสร้างข้อมูลที่หลากหลายในโดเมนเดียวกัน

API แบบธรรมดา
- มีอินเทอร์เฟซที่ใช้งานง่ายสำหรับการจัดเก็บและสืบค้นข้อมูล
- API อนุญาตให้ทำการจัดการและเลือกข้อมูลในระดับต่ำได้
- โปรโตคอลแบบข้อความส่วนใหญ่ใช้ร่วมกับ HTTP REST และ JSON
- ส่วนใหญ่ไม่ได้ใช้ภาษาการสืบค้น NoSQL ที่มีมาตรฐาน
- ฐานข้อมูลที่เปิดใช้งานบนเว็บ ซึ่งทำงานในฐานะบริการที่เข้าถึงได้จากอินเทอร์เน็ต
กระจาย
- สามารถเรียกใช้ฐานข้อมูล NoSQL หลายฐานในลักษณะแบบกระจายได้
- มีคุณสมบัติการปรับขนาดอัตโนมัติและการสำรองข้อมูลเมื่อเกิดข้อผิดพลาด
- บ่อยครั้งที่หลักการ ACID อาจถูกลดทอนลงเพื่อแลกกับความสามารถในการขยายขนาดและปริมาณงานที่เพิ่มขึ้น
- โดยส่วนใหญ่แล้วจะไม่มีการจำลองแบบซิงโครนัสระหว่างโหนดแบบกระจาย จะใช้การจำลองแบบมัลติมาสเตอร์แบบอะซิงโครนัส การจำลองแบบเพียร์ทูเพียร์ และการจำลองแบบ HDFS
- ให้ความสอดคล้องในที่สุดเท่านั้น
- สถาปัตยกรรมแบบไม่มีการแบ่งปันข้อมูล (Shared-nothing architecture) ช่วยลดการประสานงานและเพิ่มการกระจายงานให้มากขึ้น

ประเภทของฐานข้อมูล NoSQL
ฐานข้อมูล NoSQL โดยหลักแล้วฐานข้อมูลแบ่งออกเป็น 4 ประเภท ได้แก่ ฐานข้อมูลแบบคู่คีย์-ค่า ฐานข้อมูลแบบคอลัมน์ ฐานข้อมูลแบบกราฟ และฐานข้อมูลแบบเอกสาร แต่ละประเภทมีคุณลักษณะและข้อจำกัดเฉพาะตัว ไม่มีฐานข้อมูลประเภทใดที่สามารถแก้ปัญหาได้ทุกอย่าง ผู้ใช้ควรเลือกฐานข้อมูลตามความต้องการของผลิตภัณฑ์
ประเภทของฐานข้อมูล NoSQL:
- ตามคู่คีย์-ค่า
- กราฟเชิงคอลัมน์
- ตามกราฟ
- เน้นเอกสาร

ตามค่าคีย์คู่
ข้อมูลจะถูกจัดเก็บในรูปแบบคู่คีย์/ค่า ออกแบบมาเพื่อรองรับข้อมูลจำนวนมากและภาระงานหนัก ฐานข้อมูลแบบจัดเก็บคู่คีย์-ค่าจะจัดเก็บข้อมูลในรูปแบบตารางแฮช โดยแต่ละคีย์จะมีค่าที่ไม่ซ้ำกัน และค่าอาจเป็น JSON, BLOB (Binary Large Objects), สตริง เป็นต้น
ตัวอย่างเช่น คู่คีย์-ค่าอาจประกอบด้วยคีย์เช่น “เว็บไซต์” ที่เชื่อมโยงกับค่าเช่น “Guru99. "

นี่เป็นหนึ่งในตัวอย่างฐานข้อมูล NoSQL พื้นฐานที่สุด ฐานข้อมูล NoSQL ประเภทนี้ใช้เป็นคอลเลกชัน พจนานุกรม อาร์เรย์แบบเชื่อมโยง ฯลฯ ที่เก็บข้อมูลแบบคีย์-ค่าช่วยให้นักพัฒนาสามารถจัดเก็บข้อมูลที่ไม่มีโครงสร้างได้ เหมาะที่สุดสำหรับร้านค้าping สิ่งของในตะกร้า
Redis, Dynamo และ Riak เป็นตัวอย่างของฐานข้อมูลแบบ NoSQL ที่ใช้การจัดเก็บข้อมูลแบบคีย์-ค่า ฐานข้อมูลเหล่านี้ทั้งหมดมีพื้นฐานมาจาก... Amazonกระดาษไดนาโม
ตามคอลัมน์
ฐานข้อมูลแบบคอลัมน์ทำงานโดยใช้คอลัมน์ และมีพื้นฐานมาจากเอกสาร BigTable โดย Googleแต่ละคอลัมน์จะได้รับการประมวลผลแยกกัน ส่วนค่าในฐานข้อมูลแบบคอลัมน์เดียวจะถูกจัดเก็บเรียงต่อกัน

พวกมันให้ประสิทธิภาพสูงในการประมวลผลคำสั่งค้นหาข้อมูลแบบรวมกลุ่ม เช่น SUM, COUNT, AVGเช่น MIN เป็นต้น เนื่องจากข้อมูลพร้อมใช้งานในรูปแบบคอลัมน์ ฐานข้อมูล NoSQL แบบคอลัมน์จึงถูกนำมาใช้กันอย่างแพร่หลายในการจัดการคลังข้อมูล ระบบธุรกิจอัจฉริยะระบบ CRM และแคตตาล็อกบัตรห้องสมุด
เอชเบส, Cassandraและ Hypertable เป็นตัวอย่างการสืบค้นข้อมูลแบบ NoSQL ของฐานข้อมูลแบบคอลัมน์
เชิงเอกสาร
ฐานข้อมูล NoSQL แบบ Document-Oriented จัดเก็บและเรียกใช้ข้อมูลในรูปแบบคู่คีย์-ค่า แต่ส่วนที่เป็นค่าจะถูกจัดเก็บในรูปแบบเอกสาร เอกสารนั้นอาจจัดเก็บในรูปแบบ JSON หรือ XML ซึ่งฐานข้อมูลสามารถเข้าใจค่าดังกล่าวและสามารถเรียกดูได้

ในแผนภาพด้านซ้าย คุณจะเห็นว่าเรามีแถวและคอลัมน์ และด้านขวา เรามีฐานข้อมูลเอกสารซึ่งมีโครงสร้างคล้ายกับ JSON สำหรับฐานข้อมูลเชิงสัมพันธ์ คุณต้องรู้ว่ามีคอลัมน์อะไรบ้าง เป็นต้น แต่สำหรับฐานข้อมูลเอกสาร คุณมีที่เก็บข้อมูลเช่นออบเจ็กต์ JSON คุณไม่จำเป็นต้องกำหนดมัน ทำให้มีความยืดหยุ่น
เอกสารประเภทนี้ส่วนใหญ่ใช้สำหรับระบบ CMS, แพลตฟอร์มบล็อก, การวิเคราะห์แบบเรียลไทม์ และแอปพลิเคชันอีคอมเมิร์ซ ไม่ควรใช้สำหรับธุรกรรมที่ซับซ้อนซึ่งต้องมีการดำเนินการหรือการสืบค้นข้อมูลหลายครั้งกับโครงสร้างข้อมูลรวมที่แตกต่างกัน
Amazon ซิมเพิลดีบี, CouchDB, MongoDBRiak และ Lotus Notes เป็นโปรแกรมจัดการเอกสารยอดนิยม ระบบดีบีเอ็มเอส.
ตามกราฟ
ฐานข้อมูลแบบกราฟจัดเก็บทั้งเอนทิตีและความสัมพันธ์ระหว่างเอนทิตีเหล่านั้น เอนทิตีจะถูกจัดเก็บเป็นโหนด และความสัมพันธ์จะถูกจัดเก็บเป็นเส้นเชื่อม เส้นเชื่อมแสดงถึงความสัมพันธ์ระหว่างโหนดต่างๆ โหนดและเส้นเชื่อมทุกเส้นจะมีตัวระบุที่ไม่ซ้ำกัน

เมื่อเปรียบเทียบกับฐานข้อมูลเชิงสัมพันธ์ที่ตารางเชื่อมต่อกันอย่างหลวมๆ ฐานข้อมูลกราฟมีลักษณะเป็นฐานข้อมูลเชิงสัมพันธ์หลายมิติ การสำรวจความสัมพันธ์ทำได้อย่างรวดเร็ว เนื่องจากความสัมพันธ์เหล่านั้นถูกบันทึกไว้ในฐานข้อมูลแล้ว และไม่จำเป็นต้องคำนวณเพิ่มเติม ฐานข้อมูลกราฟส่วนใหญ่ใช้สำหรับเครือข่ายสังคม โลจิสติกส์ และข้อมูลเชิงพื้นที่
Neo4J, กราฟอนันต์, OrientDBและ FlockDB เป็นฐานข้อมูลแบบกราฟที่ได้รับความนิยมบางประเภท
เครื่องมือกลไกการค้นหาสำหรับ NoSQL
กลไกการดึงข้อมูลที่พบได้บ่อยที่สุดคือการดึงค่าโดยใช้ REST โดยอิงตามคีย์/รหัสประจำตัวด้วยทรัพยากร GET
ฐานข้อมูลแบบจัดเก็บเอกสารรองรับการค้นหาที่ซับซ้อนกว่า เนื่องจากเข้าใจค่าในคู่คีย์-ค่า ตัวอย่างเช่น CouchDB อนุญาตให้กำหนดมุมมองด้วย MapReduce
ทฤษฎีบท CAP คืออะไร?
ทฤษฎี CAP หรือที่เรียกว่าทฤษฎีของ Brewer กล่าวว่า เป็นไปไม่ได้ที่ระบบจัดเก็บข้อมูลแบบกระจายจะให้การรับประกันได้มากกว่าสองในสามข้อ:
- ความมั่นคง
- ความพร้อมที่จะให้บริการ
- ความอดทนของพาร์ติชัน
สอดคล้อง: ข้อมูลควรยังคงสอดคล้องกันแม้หลังจากดำเนินการแล้ว ซึ่งหมายความว่าเมื่อเขียนข้อมูลแล้ว คำขออ่านในอนาคตควรมีข้อมูลนั้นอยู่ด้วย ตัวอย่างเช่น หลังจากอัปเดตสถานะคำสั่งซื้อแล้ว ลูกค้าทั้งหมดควรสามารถเห็นข้อมูลเดียวกันได้
สถานะ: ฐานข้อมูลควรพร้อมใช้งานและตอบสนองอยู่เสมอ มันไม่ควรจะมีการหยุดทำงานใดๆ
ความอดทนของพาร์ติชัน: Partition Tolerance หมายความว่าระบบควรทำงานต่อไปแม้ว่าการสื่อสารระหว่างเซิร์ฟเวอร์จะไม่เสถียรก็ตาม ตัวอย่างเช่น เซิร์ฟเวอร์สามารถแบ่งพาร์ติชันออกเป็นหลายกลุ่มซึ่งอาจไม่สามารถสื่อสารถึงกันได้ ที่นี่ หากส่วนหนึ่งของฐานข้อมูลไม่พร้อมใช้งาน ส่วนอื่นๆ จะไม่ได้รับผลกระทบเสมอ
ความสอดคล้องในที่สุด
คำว่า “ความสอดคล้องในที่สุด” (eventual consistency) หมายถึงการมีสำเนาข้อมูลอยู่ในเครื่องหลายเครื่องเพื่อให้มีความพร้อมใช้งานสูงและปรับขนาดได้ ดังนั้น การเปลี่ยนแปลงใดๆ ที่เกิดขึ้นกับข้อมูลในเครื่องใดเครื่องหนึ่งจะต้องถูกส่งต่อไปยังสำเนาอื่นๆ ด้วย
การจำลองข้อมูลอาจไม่เกิดขึ้นทันที เนื่องจากสำเนาบางส่วนจะได้รับการอัปเดตทันที ในขณะที่สำเนาอื่นๆ จะได้รับการอัปเดตในภายหลัง สำเนาเหล่านี้อาจไม่สอดคล้องกัน แต่ในที่สุดก็จะสอดคล้องกัน ดังนั้นจึงเรียกว่า ความสอดคล้องกันในที่สุด (eventual consistency)
ฐาน: Bอนิจจา Aพร้อมใช้งาน Sมักจะรัฐ Eความสม่ำเสมอของช่องลม
- โดยพื้นฐานแล้ว คำว่า "พร้อมใช้งาน" หมายความว่าฐานข้อมูลพร้อมใช้งานตลอดเวลาตามทฤษฎี CAP
- สถานะแบบอ่อน หมายถึง แม้จะไม่มีการป้อนข้อมูลใดๆ สถานะของระบบก็อาจเปลี่ยนแปลงได้
- ความสอดคล้องในที่สุด หมายความว่าระบบจะมีความสอดคล้องกันในที่สุดเมื่อเวลาผ่านไป

ข้อดีของ NoSQL
- สามารถใช้เป็นแหล่งข้อมูลหลักหรือแหล่งข้อมูลวิเคราะห์ได้
- ความสามารถในการประมวลผลข้อมูลขนาดใหญ่
- ไม่มีจุดอ่อนเพียงจุดเดียว
- ทำซ้ำได้ง่าย
- ไม่จำเป็นต้องมีเลเยอร์แคชแยกต่างหาก
- มันให้ประสิทธิภาพที่รวดเร็วและความสามารถในการขยายแนวนอน
- สามารถจัดการกับข้อมูลที่มีโครงสร้าง ข้อมูลกึ่งโครงสร้าง และข้อมูลที่ไม่มีโครงสร้างได้อย่างมีประสิทธิภาพเท่าเทียมกัน
- การเขียนโปรแกรมเชิงวัตถุ ซึ่งใช้งานง่ายและมีความยืดหยุ่น
- ฐานข้อมูล NoSQL ไม่จำเป็นต้องใช้เซิร์ฟเวอร์ประสิทธิภาพสูงโดยเฉพาะ
- รองรับภาษาและแพลตฟอร์มการพัฒนาหลักๆ
- ง่ายต่อการใช้งานมากกว่าการใช้ระบบจัดการฐานข้อมูลเชิงสัมพันธ์ (RDBMS)
- สามารถใช้เป็นแหล่งข้อมูลหลักสำหรับแอปพลิเคชันออนไลน์ได้
- จัดการกับข้อมูลขนาดใหญ่ ซึ่งรองรับความเร็ว ความหลากหลาย ปริมาณ และความซับซ้อนของข้อมูล
- มีความเชี่ยวชาญด้านฐานข้อมูลแบบกระจายและการดำเนินงานในหลายศูนย์ข้อมูล
- ช่วยลดความจำเป็นในการใช้เลเยอร์แคชเฉพาะเพื่อจัดเก็บข้อมูล
- นำเสนอการออกแบบโครงสร้างข้อมูลที่ยืดหยุ่น ซึ่งสามารถเปลี่ยนแปลงได้ง่ายโดยไม่ต้องหยุดระบบหรือทำให้การให้บริการหยุดชะงัก
ข้อเสียของ NoSQL
- ไม่มีกฎเกณฑ์มาตรฐานใดๆ
- ความสามารถในการสืบค้นข้อมูลมีจำกัด
- อาร์ดีบีเอ็มเอส ฐานข้อมูลและเครื่องมือต่างๆ ค่อนข้างพัฒนาเต็มที่แล้ว
- มันไม่มีศักยภาพด้านฐานข้อมูลแบบดั้งเดิม เช่น ความสม่ำเสมอเมื่อมีการดำเนินการธุรกรรมหลายรายการพร้อมกัน
- เมื่อปริมาณข้อมูลเพิ่มขึ้น การรักษาค่าที่ไม่ซ้ำกันจะทำได้ยากขึ้น เนื่องจากคีย์มีความซับซ้อนมากขึ้น
- ใช้งานได้ไม่ดีนักกับข้อมูลเชิงสัมพันธ์
- นักพัฒนาซอฟต์แวร์มือใหม่ต้องเรียนรู้ระบบนี้ค่อนข้างยากลำบาก
- ตัวเลือกโอเพนซอร์สไม่ค่อยเป็นที่นิยมในองค์กรธุรกิจ
