
Python ไฟล์ XML – วิธีอ่าน เขียน และแยกวิเคราะห์
 แอนนา เบลค
⚡ สรุปอย่างชาญฉลาด
Python การประมวลผล XML ช่วยให้คุณอ่าน เขียน และแยกวิเคราะห์เอกสาร XML โดยใช้โมดูล minidom และ ElementTree ที่มีอยู่ภายใน คลาส minidom โหลดไฟล์ลงในหน่วยความจำในรูปแบบ DOM ในขณะที่ ElementTree นำเสนอวิธีการที่รวดเร็วและมีประสิทธิภาพกว่า PythonAPI ของ ic tree
หัวข้อด้านล่างนี้จะกล่าวถึงการแยกวิเคราะห์ การเขียน และการอ่านไฟล์ XML Python.
XML คืออะไร?
XML ย่อมาจาก eXtensible Markup Language ได้รับการออกแบบมาเพื่อจัดเก็บและขนส่งข้อมูลจำนวนน้อยถึงปานกลาง และมีการใช้กันอย่างแพร่หลายในการแบ่งปันข้อมูลที่มีโครงสร้าง
Python ช่วยให้คุณสามารถแยกวิเคราะห์และแก้ไขเอกสาร XML ได้ ในการแยกวิเคราะห์เอกสาร XML คุณจำเป็นต้องมีเอกสาร XML ทั้งหมดอยู่ในหน่วยความจำ ในบทเรียนนี้ เราจะมาดูวิธีการใช้คลาส XML minidom ในการแยกวิเคราะห์เอกสาร XML กัน Python เพื่อโหลดและแยกวิเคราะห์ไฟล์ XML
วิธีแยกวิเคราะห์ XML โดยใช้ minidom
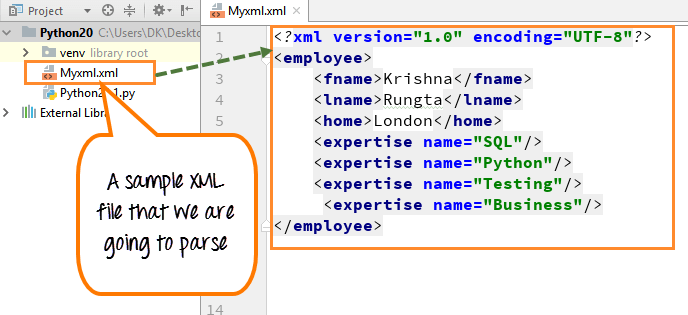
เราได้สร้างไฟล์ XML ตัวอย่างที่เราจะแยกวิเคราะห์
ขั้นตอนที่ 1) สร้างไฟล์ XML ตัวอย่าง
ภายในไฟล์เราจะเห็นชื่อ นามสกุล บ้าน และพื้นที่ความเชี่ยวชาญ (SQL, Python(การทดสอบและธุรกิจ)
ขั้นตอนที่ 2) ใช้ฟังก์ชันแยกวิเคราะห์เพื่อโหลดและแยกวิเคราะห์ไฟล์ XML
เมื่อเราวิเคราะห์เอกสารเสร็จแล้ว เราจะพิมพ์ "ชื่อโหนด" ของรากของเอกสารและ "ชื่อแท็กของโหนดลูกตัวแรก" ออกมา ชื่อแท็กและชื่อโหนดเป็นคุณสมบัติมาตรฐานของไฟล์ XML
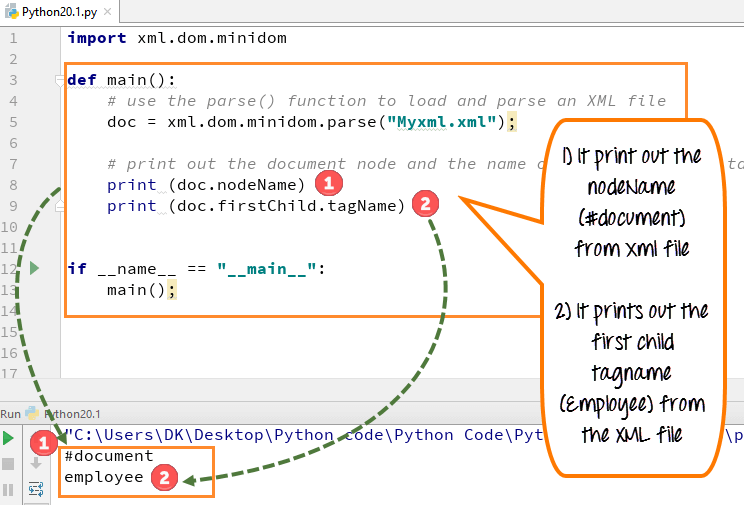
- นำเข้าโมดูล xml.dom.minidom และประกาศไฟล์ที่จะต้องนำมาประมวลผล (myxml.xml)
- ไฟล์นี้ประกอบด้วยข้อมูลพื้นฐานเกี่ยวกับพนักงาน เช่น ชื่อ นามสกุล บ้าน ความเชี่ยวชาญ ฯลฯ
- เราใช้ฟังก์ชันแยกวิเคราะห์บน XML minidom เพื่อโหลดและแยกวิเคราะห์ไฟล์ XML
- เรามีตัวแปรชื่อ doc และ doc จะได้รับผลลัพธ์จากฟังก์ชัน parse
- เราต้องการพิมพ์ชื่อโหนดและชื่อแท็กของโหนดลูกจากไฟล์ ดังนั้นเราจึงประกาศตัวแปรเหล่านั้นในฟังก์ชัน print
- เรียกใช้รหัส - พิมพ์ชื่อโหนด (#document) จากไฟล์ XML และชื่อแท็กย่อยคนแรก (พนักงาน) จากไฟล์ XML
หมายเหตุ: ชื่อโหนดและชื่อแท็กย่อยเป็นชื่อหรือคุณสมบัติมาตรฐานของ XML DOM
ขั้นตอนที่ 3) เรียกดูรายการแท็ก XML จากเอกสาร XML แล้วพิมพ์ออกมา
ถัดไป เรายังสามารถเรียกดูรายการแท็ก XML จากเอกสาร XML และพิมพ์ออกมาได้ ในที่นี้เราได้พิมพ์ชุดทักษะต่างๆ เช่น SQL ออกมา Python, การทดสอบ และธุรกิจ

- กำหนดตัวแปร expertise ซึ่งเราจะใช้เป็นตัวอย่างtracความเชี่ยวชาญทั้งหมดที่พนักงานมี
- ใช้ฟังก์ชันมาตรฐาน dom ที่เรียกว่า "getElementsByTagName"
- นี่จะได้รับองค์ประกอบทั้งหมดที่มีชื่อว่าทักษะ
- ประกาศลูปเพื่อวนซ้ำแต่ละแท็กทักษะ
- รันโค้ด - มันจะแสดงรายการทักษะสี่อย่าง
วิธีการเขียนโหนด XML
เราสามารถสร้างแอตทริบิวต์ใหม่ได้โดยใช้ฟังก์ชัน "createElement" จากนั้นจึงเพิ่มแอตทริบิวต์หรือแท็กใหม่นี้ต่อท้ายแท็ก XML ที่มีอยู่ เราได้เพิ่มแท็กใหม่ “BigData” ในไฟล์ XML ของเรา
- คุณต้องเขียนโค้ดเพื่อเพิ่มแอตทริบิวต์ใหม่ (BigData) ลงในแท็ก XML ที่มีอยู่เดิม
- จากนั้น คุณต้องพิมพ์แท็ก XML โดยเพิ่มแอตทริบิวต์ใหม่ต่อท้ายแท็ก XML เดิม
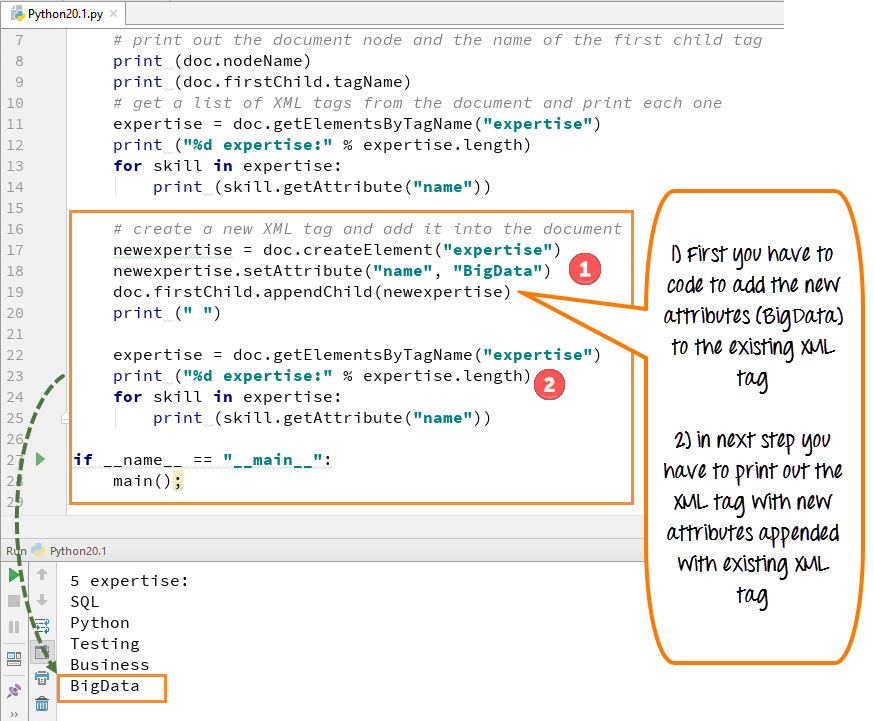
- ในการเพิ่มแท็ก XML ใหม่และเพิ่มลงในเอกสาร เราใช้โค้ด “doc.createElement”
- โค้ดนี้จะสร้างแท็กทักษะใหม่สำหรับแอตทริบิวต์ใหม่ของเราที่ชื่อว่า “BigData”
- เพิ่มแท็กทักษะนี้ลงในข้อมูลย่อยแรกของเอกสาร (พนักงาน)
- รันโค้ด - แท็กใหม่ "BigData" จะปรากฏขึ้นพร้อมกับรายการความเชี่ยวชาญอื่นๆ
ตัวอย่างตัวแยกวิเคราะห์ XML
Python 2 ตัวอย่าง
import xml.dom.minidom

def main():
# use the parse() function to load and parse an XML file
   doc = xml.dom.minidom.parse("Myxml.xml");

# print out the document node and the name of the first child tag
   print doc.nodeName
   print doc.firstChild.tagName

# get a list of XML tags from the document and print each one
   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

#Write a new XML tag and add it into the document
   newexpertise = doc.createElement("expertise")
   newexpertise.setAttribute("name", "BigData")
   doc.firstChild.appendChild(newexpertise)
   print " "

   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

if name == "__main__":
  main();
Python 3 ตัวอย่าง
import xml.dom.minidom

def main():
    # use the parse() function to load and parse an XML file
    doc = xml.dom.minidom.parse("Myxml.xml");

    # print out the document node and the name of the first child tag
    print (doc.nodeName)
    print (doc.firstChild.tagName)
    # get a list of XML tags from the document and print each one
    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

    # Write a new XML tag and add it into the document
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print (" ")

    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

if __name__ == "__main__":
    main();
วิธีแยกวิเคราะห์ XML โดยใช้ ElementTree
ElementTree คือ API สำหรับจัดการไฟล์ XML ElementTree เป็นวิธีที่ง่ายในการประมวลผลไฟล์ XML
เรากำลังใช้เอกสาร XML ต่อไปนี้เป็นตัวอย่างข้อมูล:
<data>
   <items>
      <item name="expertise1">SQL</item>
      <item name="expertise2">Python</item>
   </items>
</data>
การอ่าน XML โดยใช้ ElementTree:
ก่อนอื่นเราต้องนำเข้าโมดูล xml.etree.ElementTree ก่อน
import xml.etree.ElementTree as ET
ต่อไปเรามาดึงข้อมูลองค์ประกอบรากกัน:
root = tree.getroot()
ต่อไปนี้คือโค้ดฉบับสมบูรณ์สำหรับการอ่านข้อมูล XML ข้างต้น:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()

# all items data
print('Expertise Data:')

for elem in root:
   for subelem in elem:
      print(subelem.text)
Output:
Expertise Data:
SQL
Python
