
บทช่วยสอนการถดถอยเชิงเส้นด้วย TensorFlow [ตัวอย่าง]
 เอเวลิน คลาร์ก
⚡ สรุปอย่างชาญฉลาด
การถดถอยเชิงเส้น (Linear Regression) ใน TensorFlow จำลองความสัมพันธ์ระหว่างคุณลักษณะเชิงตัวเลขและค่าเป้าหมายต่อเนื่อง บทแนะนำนี้จะฝึกฝนตัวทำนายราคาบ้านในบอสตันด้วยสามวิธีที่แตกต่างกัน โดยใช้ Pandas, NumPy และไปป์ไลน์อินพุตดั้งเดิมของ TensorFlow ร่วมกับตัวประมาณค่า LinearRegressor
การถดถอยเชิงเส้นคืออะไร?
การถดถอยเชิงเส้น การถดถอยเชิงเส้นเป็นวิธีการทางสถิติสำหรับการสร้างแบบจำลองความสัมพันธ์ระหว่างตัวแปรสองตัว การสร้างแบบจำลองนี้ทำขึ้นระหว่างตัวแปรตอบสนองที่เป็นค่าคงที่กับตัวแปรอธิบายหนึ่งตัวหรือมากกว่านั้น ความสัมพันธ์ที่มีตัวแปรอธิบายหนึ่งตัวเรียกว่าการถดถอยเชิงเส้นแบบง่าย และความสัมพันธ์ที่มีตัวแปรอธิบายมากกว่าหนึ่งตัวเรียกว่าการถดถอยเชิงเส้นแบบหลายตัวแปร
TensorFlow มีเครื่องมือสำหรับควบคุมการคำนวณอย่างเต็มรูปแบบ ซึ่งทำได้โดยใช้ API ระดับต่ำ ยิ่งไปกว่านั้น TensorFlow ยังมาพร้อมกับ API มากมายเพื่อดำเนินการหลายอย่าง เรียนรู้เครื่อง อัลกอริทึม นี่คือ API ระดับสูง และ TensorFlow เรียกมันว่าตัวประมาณค่า (estimators)
- API ระดับต่ำ: สร้างโครงสร้างและปรับแต่งโมเดลตั้งแต่เริ่มต้น เป็นเรื่องที่ซับซ้อนสำหรับผู้เริ่มต้น
- API ระดับสูง: กำหนดอัลกอริธึม มันใช้งานง่าย TensorFlow มีกล่องเครื่องมือที่เรียกว่า ประมาณการ เพื่อสร้าง ฝึกอบรม ประเมินผล และคาดการณ์
ในบทช่วยสอนนี้ คุณจะใช้ ตัวประมาณค่าเท่านั้นการคำนวณเร็วขึ้นและง่ายต่อการใช้งาน ส่วนแรกจะอธิบายวิธีการใช้ตัวเพิ่มประสิทธิภาพการลดระดับความชัน (gradient descent optimizer) เพื่อฝึกการถดถอยเชิงเส้นใน TensorFlow ในส่วนที่สอง คุณจะใช้ชุดข้อมูล Boston เพื่อทำนายราคาบ้านโดยใช้ตัวประมาณค่า (estimator) ของ TensorFlow
วิธีฝึกโมเดลการถดถอยเชิงเส้น
ก่อนที่เราจะเริ่มฝึกโมเดล เรามาดูกันก่อนว่าการถดถอยเชิงเส้นคืออะไรกันแน่
ลองนึกภาพว่าคุณมีตัวแปรสองตัว คือ x และ y และงานของคุณคือการทำนายค่าของ y โดยที่รู้ค่าของ x ถ้าคุณลองพล็อตข้อมูล คุณจะเห็นความสัมพันธ์เชิงบวกระหว่างตัวแปรอิสระ x และตัวแปรตาม y ดังที่แสดงในแผนภาพกระจายด้านล่าง

คุณอาจสังเกตได้ว่า ถ้า x=1 ค่า y จะอยู่ที่ประมาณ 6 และถ้า x=2 ค่า y จะอยู่ที่ประมาณ 8.5
วิธีนี้ไม่ใช่วิธีที่แม่นยำมากนักและมีโอกาสเกิดข้อผิดพลาดสูง โดยเฉพาะอย่างยิ่งกับชุดข้อมูลที่มีจุดข้อมูลหลายแสนจุด
การถดถอยเชิงเส้นถูกประเมินด้วยสมการ ตัวแปร y ถูกอธิบายโดยตัวแปรร่วมหนึ่งตัวหรือหลายตัว ในตัวอย่างของคุณ มีตัวแปรตามเพียงตัวเดียวเท่านั้น หากคุณต้องเขียนสมการนี้ มันจะเป็น:

ด้วย:
 คือค่าความเอนเอียง นั่นคือ ถ้า x=0, y=
 คือน้ำหนักที่เกี่ยวข้องกับ x
 คือค่าตกค้าง หรือค่าความคลาดเคลื่อนของแบบจำลอง ซึ่งรวมถึงสิ่งที่แบบจำลองไม่สามารถเรียนรู้จากข้อมูลได้
ลองนึกภาพว่าคุณเหมาะสมกับโมเดลดังกล่าวและคุณพบวิธีแก้ปัญหาดังต่อไปนี้:
- = 3.8
- = 2.78
คุณสามารถแทนตัวเลขเหล่านั้นในสมการได้และจะกลายเป็น:
y= 3.8 + 2.78x
ตอนนี้คุณมีวิธีที่ดีกว่าในการหาค่าของ y แล้ว กล่าวคือ คุณสามารถแทนที่ x ด้วยค่าใดก็ได้ที่คุณต้องการเพื่อทำนาย y ในภาพด้านล่าง เราได้แทนที่ x ในสมการด้วยค่าทั้งหมดในชุดข้อมูลและพล็อตผลลัพธ์ออกมา

เส้นสีแดงแสดงถึงค่าที่ได้จากการประมาณ นั่นคือค่า y สำหรับแต่ละค่าของ x คุณไม่จำเป็นต้องทราบค่าของ x เพื่อทำนายค่า y เพราะสำหรับแต่ละค่า x จะมีค่าหนึ่งที่ตรงกับเส้นสีแดง คุณยังสามารถทำนายค่า x ที่มากกว่า 2 ได้อีกด้วย
หากคุณต้องการขยายการวิเคราะห์การถดถอยเชิงเส้นไปยังตัวแปรอิสระเพิ่มเติม คุณสามารถทำได้โดยการเพิ่มตัวแปรเพิ่มเติมลงในแบบจำลอง ความแตกต่างระหว่างการวิเคราะห์แบบดั้งเดิมและการวิเคราะห์การถดถอยเชิงเส้นคือ การวิเคราะห์การถดถอยเชิงเส้นจะพิจารณาว่า y จะมีปฏิกิริยาอย่างไรต่อตัวแปร x แต่ละตัวที่แยกจากกัน
ลองมาดูตัวอย่างกัน สมมติว่าคุณต้องการทำนายยอดขายของร้านไอศกรีม ชุดข้อมูลประกอบด้วยข้อมูลต่างๆ เช่น สภาพอากาศ (ฝนตก แดดออก เมฆมาก) และข้อมูลลูกค้า (เงินเดือน เพศ สถานภาพสมรส)
การวิเคราะห์แบบดั้งเดิมจะพยายามทำนายยอดขายโดยการคำนวณค่าเฉลี่ยของแต่ละตัวแปรและพยายามประมาณการยอดขายสำหรับสถานการณ์ต่างๆ ซึ่งจะนำไปสู่การทำนายที่ไม่แม่นยำและจำกัดการวิเคราะห์ไว้เฉพาะสถานการณ์ที่เลือกไว้เท่านั้น
หากคุณใช้การถดถอยเชิงเส้น คุณสามารถเขียนสมการนี้ได้:
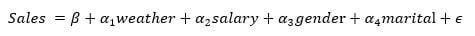
อัลกอริทึมจะค้นหาวิธีแก้ปัญหาที่ดีที่สุดสำหรับค่าน้ำหนัก ซึ่งหมายความว่าจะพยายามลดต้นทุนให้เหลือน้อยที่สุด ซึ่งก็คือความแตกต่างระหว่างเส้นที่เหมาะสมกับจุดข้อมูล
อัลกอริทึมทำงานอย่างไร
แผนภาพด้านล่างสรุปขั้นตอนการทำงานซ้ำของอัลกอริทึม ได้แก่ เลือกค่าน้ำหนัก ทำนายค่า y วัดค่าความคลาดเคลื่อน และแก้ไขค่าน้ำหนัก

อัลกอริธึมจะเลือกหมายเลขสุ่มให้กับแต่ละหมายเลข  และ
 และแทนที่ค่า x เพื่อให้ได้ค่าทำนายของ y หากชุดข้อมูลมีการสังเกต 100 ครั้ง อัลกอริธึมจะคำนวณค่าที่คาดการณ์ไว้ 100 ค่า
เราสามารถคำนวณข้อผิดพลาดได้  ค่าความคลาดเคลื่อนของแบบจำลอง คือ ผลต่างระหว่างค่าที่ทำนายได้กับค่าจริง ค่าความคลาดเคลื่อนเป็นบวกหมายความว่าแบบจำลองทำนายค่า y ต่ำกว่าความเป็นจริง และค่าความคลาดเคลื่อนเป็นลบหมายความว่าแบบจำลองทำนายค่า y สูงกว่าความเป็นจริง

เป้าหมายของคุณคือการลดค่ากำลังสองของความคลาดเคลื่อนให้เหลือน้อยที่สุด อัลกอริทึมจะคำนวณค่าเฉลี่ยของค่ากำลังสองของความคลาดเคลื่อน ขั้นตอนนี้เรียกว่าการลดค่าความคลาดเคลื่อนให้เหลือน้อยที่สุด สำหรับการถดถอยเชิงเส้น นี่คือ... หมายถึงข้อผิดพลาดสแควร์หรือเรียกอีกอย่างว่า MSE ในทางคณิตศาสตร์มันคือ:

ที่ไหน:
 คือน้ำหนัก ดังนั้น
 หมายถึงค่าที่คาดการณ์ไว้
- y คือค่าที่แท้จริง
- m คือจำนวนการสังเกต
 หมายถึงค่าที่คาดการณ์ไว้
โปรดทราบว่า  หมายความว่ามันใช้ทรานสโพสของเมทริกซ์ ที่
 คือสัญกรณ์ทางคณิตศาสตร์ของค่าเฉลี่ย
เป้าหมายคือการหาสิ่งที่ดีที่สุด  ซึ่งทำให้ค่า MSE ต่ำที่สุด
หากข้อผิดพลาดโดยเฉลี่ยมีมาก แสดงว่าโมเดลทำงานได้ไม่ดีและไม่ได้เลือกน้ำหนักอย่างเหมาะสม หากต้องการแก้ไขน้ำหนัก คุณต้องใช้เครื่องมือเพิ่มประสิทธิภาพ เครื่องมือเพิ่มประสิทธิภาพแบบดั้งเดิมเรียกว่า โคตรไล่ระดับ.
การลดระดับความชัน (Gradient Descent) จะคำนวณอนุพันธ์และลดหรือเพิ่มน้ำหนัก หากอนุพันธ์เป็นบวก น้ำหนักจะลดลง หากอนุพันธ์เป็นลบ น้ำหนักจะเพิ่มขึ้น โมเดลจะอัปเดตน้ำหนักและคำนวณข้อผิดพลาดใหม่ กระบวนการนี้จะทำซ้ำจนกว่าข้อผิดพลาดจะไม่เปลี่ยนแปลงอีกต่อไป แต่ละรอบเรียกว่าหนึ่งรอบ (pass) การย้ำนอกจากนี้ ค่าความชันจะถูกคูณด้วยอัตราการเรียนรู้ ซึ่งบ่งบอกถึงความเร็วในการเรียนรู้
หากอัตราการเรียนรู้ต่ำเกินไป อัลกอริทึมจะใช้เวลานานมากในการลู่เข้า เนื่องจากต้องใช้จำนวนรอบการทำซ้ำที่มากขึ้น หากอัตราการเรียนรู้สูงเกินไป อัลกอริทึมอาจไม่ลู่เข้าเลยก็ได้ กราฟแสดงค่าความคลาดเคลื่อนเทียบกับจำนวนรอบการทำซ้ำด้านล่างสำหรับชุดข้อมูลนี้

จากภาพด้านบน คุณจะเห็นว่าแบบจำลองทำซ้ำกระบวนการนี้ประมาณ 20 ครั้งก่อนที่จะพบค่าที่เสถียรสำหรับน้ำหนัก ซึ่งจะทำให้ได้ค่าความคลาดเคลื่อนต่ำที่สุด
โปรดสังเกตว่าค่าความคลาดเคลื่อนไม่เท่ากับศูนย์ แต่จะคงที่อยู่ที่ประมาณ 5 ซึ่งหมายความว่าแบบจำลองมีความคลาดเคลื่อนโดยทั่วไปอยู่ที่ 5 หากคุณต้องการลดความคลาดเคลื่อน คุณจำเป็นต้องเพิ่มข้อมูลลงในแบบจำลอง เช่น ตัวแปรเพิ่มเติม หรือใช้ตัวประมาณค่าที่แตกต่างกัน
คุณจำสมการแรกได้ไหม:

ค่าน้ำหนักสุดท้ายคือ 3.8 และ 2.78 วิดีโอด้านล่างแสดงให้เห็นว่าการลดระดับความชัน (gradient descent) ปรับฟังก์ชันความสูญเสีย (loss function) อย่างไรเพื่อให้ได้ค่าน้ำหนักเหล่านี้
วิธีฝึกการถดถอยเชิงเส้นด้วย TensorFlow
เมื่อคุณมีความเข้าใจที่ดีขึ้นเกี่ยวกับสิ่งที่เกิดขึ้นเบื้องหลังแล้ว คุณก็พร้อมที่จะใช้ API ตัวประมาณค่าที่ TensorFlow มอบให้เพื่อฝึกการถดถอยเชิงเส้นครั้งแรกของคุณโดยใช้ TensorFlow
หมายเหตุเกี่ยวกับเวอร์ชัน: เวิร์กโฟลว์การประมาณค่าที่แสดงด้านล่างนี้เขียนขึ้นโดยใช้ TensorFlow เวอร์ชัน 1.x และเวอร์ชัน 2.x ช่วงแรกๆ TensorFlow ได้ทำเครื่องหมายไว้ว่า tf.estimator และ tf.feature_column API ถูกยกเลิกการใช้งานอย่างสมบูรณ์ในเวอร์ชัน 2.12 และ Estimator ถูกยกเลิกในเวอร์ชัน 2.16 ในการติดตั้งปัจจุบัน ให้รันโค้ดนี้ภายใน TensorFlow 1.15 หรือ 2.x ที่มี...tf.compat.v1 สภาพแวดล้อม หรือพอร์ตไปยัง Keras ซึ่ง tf.keras.layers.Dense(1) นอกจากนี้ เลเยอร์การประมวลผลล่วงหน้าจะเข้ามาแทนที่ LinearRegressor และคอลัมน์คุณลักษณะ แนวคิดพื้นฐาน เช่น คุณลักษณะ ป้ายกำกับ ชุดข้อมูล รอบการฝึก MSE และการไล่ระดับความชัน ยังคงเหมือนเดิม
คุณจะใช้ชุดข้อมูลบอสตัน ซึ่งประกอบด้วยตัวแปรต่อไปนี้
| ตัวแปร | Descriptไอออน |
| คริม | อัตราอาชญากรรมต่อหัวแยกตามเมือง |
| zn | สัดส่วนที่ดินที่อยู่อาศัยแบ่งเขตพื้นที่เกิน 25,000 ตร.ฟุต |
| สินธุ | สัดส่วนของพื้นที่ธุรกิจที่ไม่ใช่ร้านค้าปลีกต่อเมือง |
| NOx | ความเข้มข้นของไนตริกออกไซด์ |
| rm | จำนวนห้องเฉลี่ยต่อที่อยู่อาศัย |
| อายุ | สัดส่วนของยูนิตที่มีเจ้าของสร้างขึ้นก่อนปี พ.ศ. 1940 |
| นี้ | ระยะทางถ่วงน้ำหนักไปยังศูนย์จัดหางานบอสตันห้าแห่ง |
| ภาษี | อัตราภาษีทรัพย์สินมูลค่าเต็มต่อ 10,000 ดอลลาร์ |
| พทราติโอ | อัตราส่วนนักเรียนต่อครูแยกตามเมือง |
| เมดวี | ค่ามัธยฐานของบ้านที่มีเจ้าของเป็นพันดอลลาร์ |
คุณจะสร้างชุดข้อมูลที่แตกต่างกันสามชุด:
| ชุด | วัตถุประสงค์ | รูปร่าง |
| องค์กร | ฝึกโมเดลและรับตุ้มน้ำหนัก | 400, 10 |
| การประเมินผล | ประเมินประสิทธิภาพของโมเดลจากข้อมูลที่มองไม่เห็น | 100, 10 |
| ทำนาย | ใช้แบบจำลองเพื่อทำนายมูลค่าบ้านจากข้อมูลใหม่ | 6, 10 |
วัตถุประสงค์คือการใช้คุณลักษณะของชุดข้อมูลเพื่อทำนายมูลค่าของบ้าน
ในส่วนที่สองของบทเรียนนี้ คุณจะได้เรียนรู้วิธีการใช้ TensorFlow กับวิธีการนำเข้าข้อมูลสามวิธีที่แตกต่างกัน:
- กับแพนด้า
- ด้วยระบบเส้นทาง นำพาย
- เฉพาะ TensorFlow เท่านั้น
โปรดทราบว่าทั้งสามตัวเลือกให้ผลลัพธ์เหมือนกัน
คุณจะได้เรียนรู้วิธีการใช้ API ระดับสูงเพื่อสร้าง ฝึกฝน และประเมินโมเดลการถดถอยเชิงเส้นของ TensorFlow หากคุณใช้ API ระดับต่ำ คุณจะต้องกำหนดค่าต่างๆ ด้วยตนเองดังนี้:
- ฟังก์ชั่นการสูญเสีย
- ตัวปรับแต่งประสิทธิภาพ: การลดระดับความชัน
- การคูณเมทริกซ์
- กราฟและเทนเซอร์
ขั้นตอนนี้ค่อนข้างยุ่งยากและซับซ้อนเกินไปสำหรับผู้เริ่มต้น
โซลูชัน Pandas
คุณต้องนำเข้าไลบรารีที่จำเป็นเพื่อฝึกโมเดล
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
ขั้นตอน 1) นำเข้าข้อมูลด้วย นุ่น.
คุณกำหนดชื่อคอลัมน์และเก็บไว้ในตัวแปร COLUMNS จากนั้นคุณสามารถใช้ pd.read_csv() เพื่อนำเข้าข้อมูลได้
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
กำหนดให้การเรียกใช้แต่ละครั้งชี้ไปยังไฟล์ CSV ที่คุณดาวน์โหลดไว้ก่อนหน้านี้
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
คุณสามารถพิมพ์รูปร่างของข้อมูลได้
print(training_set.shape, test_set.shape, prediction_set.shape)
เอาท์พุต
(400, 10) (100, 10) (6, 10)
โปรดทราบว่าป้ายกำกับ ซึ่งก็คือค่า y ของคุณนั้น รวมอยู่ในชุดข้อมูลแล้ว ดังนั้นคุณจึงต้องกำหนดรายการอีกสองรายการ: รายการหนึ่งประกอบด้วยคุณลักษณะเท่านั้น และอีกรายการหนึ่งประกอบด้วยชื่อของป้ายกำกับเท่านั้น รายการทั้งสองนี้จะบอกตัวประมาณค่าของคุณว่าคุณลักษณะในชุดข้อมูลคืออะไร และชื่อคอลัมน์ใดคือป้ายกำกับ
เสร็จสิ้นด้วยรหัสด้านล่าง
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
ขั้นตอน 2) แปลงข้อมูล
คุณต้องแปลงตัวแปรตัวเลขให้อยู่ในรูปแบบที่ถูกต้อง TensorFlow มีวิธีการแปลงตัวแปรต่อเนื่องโดยใช้เมธอด tf.feature_column.numeric_column()
ในขั้นตอนก่อนหน้านี้ คุณได้กำหนดรายการคุณลักษณะที่คุณต้องการรวมไว้ในแบบจำลองแล้ว ตอนนี้คุณสามารถใช้รายการนี้เพื่อแปลงคุณลักษณะเหล่านั้นให้เป็นข้อมูลตัวเลขได้ หากคุณต้องการยกเว้นคุณลักษณะบางอย่างจากแบบจำลอง คุณสามารถลบตัวแปรหนึ่งตัวหรือมากกว่านั้นออกจากรายการ FEATURES ก่อนที่จะสร้าง feature_cols ได้
โปรดทราบว่าคุณจะใช้ Python การใช้ list comprehension กับลิสต์ FEATURES เพื่อสร้างลิสต์ใหม่ชื่อ feature_cols จะช่วยให้คุณไม่ต้องเขียน tf.feature_column.numeric_column() ถึงเก้าครั้ง List comprehension เป็นวิธีที่รวดเร็วและสะอาดกว่าในการสร้างลิสต์ใหม่
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
ขั้นตอน 3) กำหนดตัวประมาณค่า
ในขั้นตอนนี้ คุณต้องกำหนดตัวประมาณค่า TensorFlow มีตัวประมาณค่าสำเร็จรูปให้เลือกใช้ 6 แบบ โดย 3 แบบสำหรับงานจำแนกประเภท และอีก 3 แบบสำหรับงานถดถอยของ TensorFlow:
- ผู้ถดถอย
- DNNRegressor
- LinearRegressor
- DNNLinearCombinedRegressor
- แยกประเภท
- DNNลักษณนาม
- ลักษณนามเชิงเส้น
- ตัวจำแนกประเภทรวมเชิงเส้น DNN
ในบทช่วยสอนนี้ คุณจะใช้ Linear Regressor หากต้องการเข้าถึงฟังก์ชันนี้ คุณต้องใช้ tf.estimator
ฟังก์ชันต้องการอาร์กิวเมนต์สองตัว:
- feature_columns: ประกอบด้วยตัวแปรที่จะรวมอยู่ในโมเดล
- model_dir: เส้นทางสำหรับจัดเก็บกราฟ บันทึกพารามิเตอร์ของโมเดล และอื่นๆ
TensorFlow จะสร้างโฟลเดอร์ชื่อ train ในไดเร็กทอรีการทำงานของคุณโดยอัตโนมัติ คุณต้องใช้เส้นทางนี้ในการเข้าถึง เทนเซอร์บอร์ดดังแสดงในตัวอย่างการถดถอยของ TensorFlow ด้านล่าง
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
เอาท์พุต
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
ส่วนที่ยุ่งยากของ TensorFlow คือวิธีการป้อนข้อมูลให้กับโมเดล TensorFlow ถูกออกแบบมาให้ทำงานกับการประมวลผลแบบขนานและชุดข้อมูลขนาดใหญ่มาก เนื่องจากข้อจำกัดของทรัพยากรเครื่อง จึงเป็นไปไม่ได้ที่จะป้อนข้อมูลทั้งหมดให้กับโมเดลพร้อมกัน ดังนั้น คุณจึงต้องป้อนข้อมูลเป็นชุดๆ ในแต่ละครั้ง โปรดทราบว่าเรากำลังพูดถึงชุดข้อมูลขนาดใหญ่ที่มีข้อมูลหลายล้านรายการขึ้นไป หากคุณไม่ป้อนข้อมูลเป็นชุดๆ คุณจะพบกับข้อผิดพลาดเกี่ยวกับหน่วยความจำ
ตัวอย่างเช่น หากข้อมูลของคุณมีการสังเกต 100 ครั้ง และคุณกำหนดขนาดแบทช์เป็น 10 หมายความว่าโมเดลจะเห็นการสังเกต 10 ครั้งในแต่ละรอบซ้ำ (10*10)
เมื่อโมเดลประมวลผลข้อมูลทั้งหมดเสร็จแล้ว ก็จะสิ้นสุดรอบการฝึก (epoch) รอบการฝึกนี้กำหนดจำนวนครั้งที่ต้องการให้โมเดลประมวลผลข้อมูล ควรตั้งค่าขั้นตอนนี้เป็น "ไม่มี" (none) เพื่อให้โมเดลทำการฝึกตามจำนวนครั้งที่กำหนดไว้
ข้อมูลเพิ่มเติมประการที่สองคือ คุณต้องการสับเปลี่ยนข้อมูลก่อนการวนซ้ำแต่ละครั้งหรือไม่ ในระหว่างการฝึกฝนนั้น การสับเปลี่ยนข้อมูลมีความสำคัญ เพื่อป้องกันไม่ให้โมเดลเรียนรู้รูปแบบเฉพาะของชุดข้อมูล หากโมเดลเรียนรู้รายละเอียดของรูปแบบพื้นฐานของข้อมูลแล้ว มันจะยากที่จะทำนายผลลัพธ์สำหรับข้อมูลที่ไม่เคยเห็นมาก่อน นี่เรียกว่าภาวะโอเวอร์ฟิตติ้ง (overfitting) โมเดลอาจทำงานได้ดีกับข้อมูลฝึกฝน แต่ไม่สามารถทำนายผลลัพธ์ได้อย่างถูกต้องสำหรับข้อมูลที่ไม่เคยเห็นมาก่อน
TensorFlow ทำให้สองขั้นตอนเหล่านี้ทำได้ง่าย เมื่อข้อมูลเข้าสู่ไปป์ไลน์ มันจะรู้ว่าต้องการข้อมูลจำนวนเท่าใด (แบทช์) และจำเป็นต้องสุ่มลำดับข้อมูลหรือไม่
ในการสั่งการ TensorFlow ว่าจะป้อนข้อมูลให้กับโมเดลอย่างไร คุณสามารถใช้ pandas_input_fn ได้ อ็อบเจ็กต์นี้ต้องการพารามิเตอร์ห้าตัว:
- x: ข้อมูลคุณลักษณะ
- y: ข้อมูลป้ายกำกับ
- ชุด_ขนาด: ชุด โดยค่าเริ่มต้น 128
- num_epoch: จำนวนรอบการฝึก (epochs) โดยค่าเริ่มต้นคือ 1
- สุ่มสลับ: จะสุ่มสลับข้อมูลหรือไม่ โดยค่าเริ่มต้นคือ ไม่มี
คุณจำเป็นต้องป้อนข้อมูลให้กับโมเดลหลายครั้ง ดังนั้นคุณจึงกำหนดฟังก์ชันเพื่อทำซ้ำกระบวนการนี้ ตั้งชื่อฟังก์ชันนี้ว่า get_input_fn
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
วิธีปกติในการประเมินประสิทธิภาพของแบบจำลองคือ:
- ฝึกโมเดล
- ประเมินประสิทธิภาพของโมเดลบนชุดข้อมูลอื่น
- ทำนายผล
ตัวประมาณค่าของ TensorFlow มีฟังก์ชันที่แตกต่างกันสามแบบเพื่อดำเนินการทั้งสามขั้นตอนดังกล่าวได้อย่างง่ายดาย
ขั้นตอน 4) ฝึกโมเดล
คุณสามารถใช้วิธี estimator train เพื่อฝึกโมเดลได้ estimator train ต้องการ input_fn และจำนวนขั้นตอน คุณสามารถใช้ฟังก์ชันที่คุณสร้างไว้ข้างต้นเพื่อป้อนข้อมูลให้กับโมเดล จากนั้นสั่งให้โมเดลวนซ้ำ 1000 ครั้ง โปรดทราบว่าคุณไม่ได้ระบุจำนวน epochs คุณปล่อยให้โมเดลวนซ้ำ 1000 ครั้ง หากคุณตั้งค่าจำนวน epochs เป็น 1 โมเดลจะวนซ้ำสี่ครั้ง เนื่องจากมีข้อมูล 400 รายการในชุดข้อมูลฝึก และขนาดแบทช์คือ 128:
- 128 แถว
- 128 แถว
- 128 แถว
- 16 แถว
ดังนั้น จึงง่ายกว่าที่จะตั้งค่าจำนวนรอบการฝึก (epochs) เป็นไม่มีเลย และกำหนดจำนวนการทำซ้ำ (iterations) ดังแสดงในตัวอย่างการจำแนกประเภทด้วย TensorFlow ด้านล่าง
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
เอาท์พุต
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
คุณสามารถตรวจสอบ TensorBoard ได้โดยใช้คำสั่งต่อไปนี้:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
ขั้นตอน 5) ประเมินแบบจำลองของคุณ
คุณสามารถประเมินความพอดีของแบบจำลองของคุณในชุดทดสอบด้วยโค้ดด้านล่าง:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
เอาท์พุต
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
คุณสามารถพิมพ์การสูญเสียด้วยรหัสด้านล่าง:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
เอาท์พุต
Loss: 3215.895996
โมเดลนี้มีค่าความสูญเสีย 3215 คุณสามารถตรวจสอบสถิติสรุปเพื่อดูว่าข้อผิดพลาดนั้นมีขนาดใหญ่เพียงใด
training_set['medv'].describe()
เอาท์พุต
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
จากสถิติสรุปข้างต้น คุณทราบว่าราคาเฉลี่ยของบ้านอยู่ที่ 22 โดยมีราคาต่ำสุด 5 และราคาสูงสุด 50 เนื่องจากค่าความคลาดเคลื่อนที่รายงานเป็นค่าความคลาดเคลื่อนกำลังสองเฉลี่ย ดังนั้นค่าความคลาดเคลื่อนโดยทั่วไปในหน่วยเดิมจึงอยู่ที่ประมาณรากที่สองของ 32.16 ซึ่งเท่ากับประมาณ 5.7 ดอลลาร์
ขั้นตอน 6) ทำการทำนาย
สุดท้ายนี้ คุณสามารถใช้เมธอด predict ของ TensorFlow เพื่อประเมินมูลค่าของบ้านหกหลังในบอสตันได้
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
หากต้องการแสดงค่าที่คาดการณ์ไว้ คุณสามารถใช้โค้ดนี้ได้:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
เอาท์พุต
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
แบบจำลองนี้คาดการณ์ค่าดังต่อไปนี้:
| บ้าน | คำทำนาย |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
โปรดทราบว่าเราไม่ทราบมูลค่าที่แท้จริงของบ้านทั้งหกหลังนี้ ในบทเรียนการเรียนรู้เชิงลึกนี้ คุณจะพยายามเอาชนะแบบจำลองเชิงเส้น
โซลูชัน NumPy
ส่วนนี้จะอธิบายวิธีการฝึกโมเดลโดยใช้ตัวประมาณค่า NumPy เพื่อป้อนข้อมูล วิธีการจะเหมือนกัน ยกเว้นว่าคุณจะใช้ตัวประมาณค่า numpy_input_fn แทน
อ่านไฟล์ CSV ทั้งสามไฟล์เดิม แต่เก็บเฉพาะอาร์เรย์ NumPy ดิบที่มี .values เท่านั้น
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
ขั้นตอน 1) นำเข้าข้อมูล
ก่อนอื่น คุณต้องแยกความแตกต่างระหว่างตัวแปรคุณลักษณะกับป้ายกำกับ คุณต้องทำเช่นนี้ทั้งสำหรับข้อมูลฝึกฝนและข้อมูลประเมินผล การกำหนดฟังก์ชันเพื่อแบ่งข้อมูลจะช่วยให้การทำงานเร็วขึ้น
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
คุณสามารถใช้ฟังก์ชันนี้เพื่อแยกป้ายกำกับออกจากคุณลักษณะของชุดข้อมูลฝึกฝนและประเมินผลได้
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
คุณต้องตัดคอลัมน์สุดท้ายของชุดข้อมูลการทำนายออก เนื่องจากคอลัมน์นั้นมีค่าเป็น NaN ทั้งหมด
x_predict = prediction_set_n[:, :-2]
ตรวจสอบรูปร่างของอาร์เรย์ โปรดทราบว่าป้ายกำกับไม่ควรมีมิติที่สอง ซึ่งหมายถึง (400,)
print(X_train.shape, y_train.shape, x_predict.shape)
เอาท์พุต
(400, 9) (400,) (6, 9)
คุณสามารถสร้างคอลัมน์คุณลักษณะได้ดังนี้:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
ตัวประมาณค่าถูกกำหนดไว้เช่นเดิม: คุณระบุคอลัมน์คุณลักษณะและตำแหน่งที่จะบันทึกกราฟ
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
เอาท์พุต
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
คุณสามารถใช้ตัวประมาณค่า NumPy เพื่อป้อนข้อมูลให้กับโมเดลแล้วจึงฝึกโมเดลได้ โปรดทราบว่าเราได้กำหนดฟังก์ชัน input_fn ไว้ล่วงหน้าเพื่อให้ง่ายต่อการอ่าน
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
เอาท์พุต
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
คุณทำขั้นตอนเดียวกันนี้ซ้ำอีกครั้งโดยใช้ฟังก์ชันอินพุตที่แตกต่างกันเพื่อประเมินโมเดลของคุณ
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
เอาท์พุต
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
สุดท้าย คุณสามารถคำนวณค่าทำนายได้ ผลลัพธ์ควรจะคล้ายกับผลลัพธ์จาก Pandas
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
เอาท์พุต
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
โซลูชัน TensorFlow
ส่วนสุดท้ายอุทิศให้กับความบริสุทธิ์ TensorFlow วิธีแก้ปัญหา วิธีนี้ซับซ้อนกว่าสองวิธีแรกเล็กน้อย
โปรดทราบว่าหากคุณใช้ Jupyter สมุดบันทึกคุณต้องรีสตาร์ทและล้างเคอร์เนลเพื่อเรียกใช้เซสชันนี้
TensorFlow ได้สร้างเครื่องมือที่ยอดเยี่ยมสำหรับการส่งข้อมูลเข้าสู่ไปป์ไลน์ ในส่วนนี้ คุณจะได้สร้างฟังก์ชัน input_fn ด้วยตนเอง
ขั้นตอน 1) กำหนดเส้นทางและรูปแบบของข้อมูล
ขั้นแรก คุณต้องประกาศตัวแปรสองตัว โดยระบุพาธของไฟล์ CSV โปรดทราบว่าคุณมีไฟล์สองไฟล์ ไฟล์หนึ่งสำหรับชุดข้อมูลฝึกฝน และอีกไฟล์หนึ่งสำหรับชุดข้อมูลทดสอบ
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
จากนั้น คุณต้องกำหนดคอลัมน์ที่คุณต้องการใช้จากไฟล์ CSV เราจะใช้ทุกคอลัมน์ หลังจากนั้น คุณต้องประกาศชนิดของตัวแปรแต่ละตัว
ตัวแปรทศนิยมถูกกำหนดโดย [0.]
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
ขั้นตอน 2) กำหนดฟังก์ชัน input_fn
ฟังก์ชันนี้สามารถแบ่งออกได้เป็นสามส่วน:
- นำเข้าข้อมูล
- สร้างตัววนซ้ำ
- ใช้ข้อมูล
ด้านล่างนี้คือโค้ดโดยรวมที่ใช้กำหนดฟังก์ชัน โค้ดจะได้รับการอธิบายในภายหลัง
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
นำเข้าข้อมูล
สำหรับไฟล์ CSV เมธอด dataset จะอ่านทีละบรรทัด ในการสร้างชุดข้อมูล คุณต้องใช้ออบเจ็กต์ TextLineชุดข้อมูล ชุดข้อมูลของคุณมีส่วนหัว ดังนั้นคุณต้องใช้ skip(1) เพื่อข้ามบรรทัดแรก ในขั้นตอนนี้ คุณจะอ่านเฉพาะข้อมูลและไม่รวมส่วนหัวในไปป์ไลน์ เพื่อป้อนข้อมูลให้กับโมเดล คุณต้องแยกคุณลักษณะออกจากป้ายกำกับ วิธีการที่ใช้ในการแปลงข้อมูลใดๆ คือ map
วิธีการนี้จะเรียกใช้ฟังก์ชันที่คุณจะสร้างขึ้นเพื่อกำหนดวิธีการแปลงข้อมูล โดยสรุปแล้ว คุณต้องส่งข้อมูลเข้าไปในฟังก์ชันนั้น TextLineคัดลอกอ็อบเจ็กต์ชุดข้อมูล โดยไม่รวมส่วนหัว และใช้การแปลงตามคำสั่งของฟังก์ชัน
Code คำอธิบาย
- tf.dataTextLineชุดข้อมูล (ไฟล์ข้อมูล): บรรทัดนี้อ่านไฟล์ CSV
- .skip(1): ข้ามส่วนหัว
- .map(parse_csv)): แปลงข้อมูล CSV เป็นเทนเซอร์
คุณต้องกำหนดฟังก์ชันเพื่อสั่งการอ็อบเจ็กต์แผนที่ คุณสามารถตั้งชื่อฟังก์ชันนี้ว่า parse_csv ได้
ฟังก์ชันนี้จะแยกวิเคราะห์ไฟล์ CSV ด้วยเมธอด tf.decode_csv และประกาศคุณลักษณะและป้ายกำกับ คุณลักษณะสามารถประกาศเป็นพจนานุกรมหรือทูเปิลก็ได้ แต่ในที่นี้จะใช้พจนานุกรมเพราะสะดวกกว่า
Code คำอธิบาย
- tf.decode_csv(value, record_defaults= RECORDS_ALL): เมธอด decode_csv ใช้เอาต์พุตของ TextLineชุดข้อมูลสำหรับอ่านไฟล์ CSV record_defaults จะบอก TensorFlow เกี่ยวกับประเภทของคอลัมน์ ใน TensorFlow 2.x สัญลักษณ์นี้จะอยู่ที่ tf.io.decode_csv
- dict(zip(COLUMNS, columns)): เติมข้อมูลลงในพจนานุกรมด้วยคอลัมน์ทั้งหมด เช่นtracted ระหว่างการประมวลผลข้อมูลนี้
- features.pop('medv'): ไม่รวมตัวแปรเป้าหมายออกจากตัวแปรคุณลักษณะและสร้างตัวแปรป้ายกำกับขึ้นมา
ชุดข้อมูลต้องการองค์ประกอบเพิ่มเติมเพื่อป้อนข้อมูลให้กับเทนเซอร์อย่างต่อเนื่อง ดังนั้น คุณต้องเพิ่มเมธอด `repeat` เพื่อให้ชุดข้อมูลสามารถป้อนข้อมูลให้กับโมเดลได้อย่างไม่มีที่สิ้นสุด หากคุณไม่เพิ่มเมธอดนี้ โมเดลจะทำงานเพียงครั้งเดียวแล้วเกิดข้อผิดพลาด เนื่องจากไม่มีข้อมูลเพิ่มเติมป้อนเข้าสู่ไปป์ไลน์
หลังจากนั้น คุณสามารถควบคุมขนาดแบทช์ด้วยวิธีแบทช์ได้ ซึ่งหมายความว่าคุณจะบอกชุดข้อมูลว่าคุณต้องการส่งข้อมูลเข้าสู่ไปป์ไลน์ในแต่ละรอบเท่าใด หากคุณตั้งค่าขนาดแบทช์ใหญ่เกินไป โมเดลจะทำงานช้าลง
ขั้นตอน 3) สร้างตัววนซ้ำ
ตอนนี้คุณพร้อมสำหรับขั้นตอนที่สองแล้ว: สร้างตัววนซ้ำเพื่อส่งคืนองค์ประกอบในชุดข้อมูล
วิธีที่ง่ายที่สุดในการสร้างตัวดำเนินการคือใช้วิธีการ make_one_shot_iterator
หลังจากนั้น คุณสามารถสร้างคุณลักษณะและป้ายกำกับจากตัววนซ้ำได้
ขั้นตอน 4) ใช้ข้อมูล
คุณสามารถตรวจสอบสิ่งที่เกิดขึ้นกับฟังก์ชัน input_fn ได้ คุณต้องเรียกใช้ฟังก์ชันในเซสชันเพื่อดึงข้อมูล ลองตั้งค่าขนาดแบทช์เท่ากับ 1 ดู
โปรดทราบว่าคำสั่งนี้จะพิมพ์คุณลักษณะต่างๆ ในรูปแบบพจนานุกรม และพิมพ์ป้ายกำกับในรูปแบบอาร์เรย์
โค้ดนี้จะแสดงบรรทัดแรกของไฟล์ CSV คุณสามารถลองรันโค้ดนี้หลายๆ ครั้งโดยใช้ขนาดชุดข้อมูลที่แตกต่างกันได้
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
เอาท์พุต
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
ขั้นตอน 5) กำหนดคอลัมน์คุณลักษณะ
คุณต้องกำหนดคอลัมน์ตัวเลขดังต่อไปนี้:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
โปรดทราบว่าคุณต้องรวมตัวแปรทั้งหมดไว้ในกลุ่มเดียวกัน
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
ขั้นตอน 6) สร้างโมเดล
คุณสามารถฝึกโมเดลด้วยตัวประมาณค่า LinearRegressor
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
เอาท์พุต
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
คุณต้องใช้ a ฟังก์ชันแลมบ์ดา เพื่อให้คุณสามารถเขียนอาร์กิวเมนต์สำหรับฟังก์ชัน input_fn ได้ หากคุณไม่ใช้ฟังก์ชันแลมบ์ดา คุณจะไม่สามารถฝึกโมเดลได้
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
เอาท์พุต
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
คุณสามารถประเมินความพอดีของแบบจำลองของคุณในชุดทดสอบด้วยโค้ดด้านล่าง:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
เอาท์พุต
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
ขั้นตอนสุดท้ายคือการทำนายค่าของเป้าหมายโดยอิงจากค่าในเมทริกซ์คุณลักษณะ คุณสามารถสร้างพจนานุกรมด้วยค่าที่คุณต้องการทำนายได้ โมเดลของคุณมีคุณลักษณะเก้าอย่าง ดังนั้นคุณต้องระบุค่าสำหรับแต่ละคุณลักษณะ โมเดลจะให้ผลการทำนายสำหรับแต่ละคุณลักษณะเหล่านั้น
ในโค้ดด้านล่าง คุณจะเขียนค่าของแต่ละฟีเจอร์ที่มีอยู่ในไฟล์ CSV df_predict
คุณต้องเขียนฟังก์ชัน input_fn ใหม่ เนื่องจากไม่มีป้ายกำกับในชุดข้อมูล คุณสามารถใช้ API from_tensors จากอ็อบเจ็กต์ Dataset ได้
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
สุดท้าย คุณก็พิมพ์ผลการทำนายออกมา
for pred in enumerate(pred_results):
print(pred)
เอาท์พุต
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
ทั้งสามวิธีให้ผลลัพธ์การทำนายเหมือนกันหกแบบ ซึ่งยืนยันว่าการเลือกใช้ Pandas, NumPy และชุดข้อมูล TensorFlow ดั้งเดิมนั้นเป็นเรื่องของความสะดวก ไม่ใช่เรื่องของความแม่นยำ
