
Hadoop คืออะไร? Archiสถาปัตยกรรม ระบบนิเวศ และองค์ประกอบ
 ปราฟูลลา รานาไดฟ์
⚡ สรุปอย่างชาญฉลาด
Apache Hadoop เป็นเฟรมเวิร์กโอเพนซอร์สที่จัดเก็บชุดข้อมูลขนาดใหญ่ไว้ในคลัสเตอร์ของเครื่องคอมพิวเตอร์ทั่วไป และย้ายตรรกะการประมวลผลไปไว้ที่ข้อมูล ทำให้การวิเคราะห์สามารถขยายขนาดได้โดยการเพิ่มโหนดราคาถูกแทนที่จะใช้เซิร์ฟเวอร์ขนาดใหญ่ขึ้น
Hadoop คืออะไร?
Apache Hadoop เป็นเฟรมเวิร์กซอฟต์แวร์โอเพ่นซอร์สที่ใช้ในการพัฒนาแอปพลิเคชันการประมวลผลข้อมูลซึ่งดำเนินการในสภาพแวดล้อมการประมวลผลแบบกระจาย
แอปพลิเคชันที่สร้างขึ้นโดยใช้ Hadoop ทำงานบนชุดข้อมูลขนาดใหญ่ที่กระจายอยู่ทั่วคลัสเตอร์ของคอมพิวเตอร์ทั่วไป คอมพิวเตอร์ทั่วไปมีราคาถูกและหาได้ง่าย โดยส่วนใหญ่มีประโยชน์สำหรับการเพิ่มประสิทธิภาพการประมวลผลในราคาประหยัด
เช่นเดียวกับข้อมูลที่จัดเก็บอยู่ในระบบไฟล์ภายในเครื่องคอมพิวเตอร์ส่วนบุคคล ใน Hadoop ข้อมูลจะจัดเก็บอยู่ในระบบไฟล์แบบกระจาย ซึ่งเรียกว่า Hadoop แจกจ่ายระบบไฟล์แบบจำลองการประมวลผลนั้นอิงตาม 'ตำแหน่งข้อมูล' แนวคิดนี้คือการส่งตรรกะการคำนวณไปยังโหนดคลัสเตอร์ (เซิร์ฟเวอร์) ที่มีข้อมูลอยู่ ตรรกะการคำนวณนี้เป็นเพียงเวอร์ชันที่คอมไพล์แล้วของโปรแกรมที่เขียนด้วยภาษาโปรแกรมระดับสูง เช่น Javaโปรแกรมดังกล่าวจะประมวลผลข้อมูลที่จัดเก็บไว้ใน Hadoop HDFS.
คุณรู้หรือไม่? คลัสเตอร์คอมพิวเตอร์ประกอบด้วยหน่วยประมวลผลหลายหน่วย (ดิสก์จัดเก็บข้อมูล + โปรเซสเซอร์) ที่เชื่อมต่อกันและทำงานเป็นระบบเดียว
เวอร์ชัน 3.5.0 ซึ่งเผยแพร่เมื่อวันที่ 2 เมษายน 2026 เป็นเวอร์ชันเสถียรปัจจุบัน ส่วนเวอร์ชัน 3.4 ยังคงได้รับการอัปเดตเพื่อบำรุงรักษาอยู่
ระบบนิเวศและส่วนประกอบของ Hadoop
แผนภาพด้านล่างแสดงส่วนประกอบต่างๆ ในระบบนิเวศของ Hadoop โดยจัดกลุ่มตามหน้าที่ของแต่ละส่วนประกอบ ได้แก่ การจัดเก็บ การประมวลผล และเครื่องมือสำหรับการสืบค้น การนำเข้า และการประสานงานที่เกี่ยวข้อง

Apache Hadoop ประกอบด้วยสองโครงการย่อย –
- Hadoop MapReduce: MapReduce คือโมเดลการคำนวณและกรอบงานซอฟต์แวร์สำหรับเขียนแอปพลิเคชันที่ทำงานบน Hadoop โปรแกรม MapReduce เหล่านี้สามารถประมวลผลข้อมูลจำนวนมหาศาลแบบขนานบนคลัสเตอร์โหนดการคำนวณขนาดใหญ่ได้
- เอชดีเอฟเอส (Hadoop แจกจ่ายระบบไฟล์): HDFS ดูแลส่วนที่จัดเก็บของแอปพลิเคชัน Hadoop แอปพลิเคชัน MapReduce ใช้ข้อมูลจาก HDFS HDFS สร้างสำเนาของบล็อกข้อมูลหลายชุดและแจกจ่ายไปยังโหนดการคำนวณในคลัสเตอร์ การแจกจ่ายนี้ทำให้สามารถคำนวณได้อย่างน่าเชื่อถือและรวดเร็วอย่างยิ่ง
เวอร์ชันปัจจุบันมีโมดูลหลักเพิ่มเติมอีกสองโมดูล เส้นด้าย Hadoopฟังก์ชันนี้ถูกเพิ่มเข้ามาใน Hadoop 2.x โดยจะกำหนดตารางการทำงานบนคลัสเตอร์ และ ฮาดู๊ปทั่วไป ถือครองร่วมกัน Java ไลบรารีที่ทุกโมดูลต้องพึ่งพา YARN คือสิ่งที่ช่วยให้เอนจิ้นต่างๆ เช่น สามารถใช้งานได้ SparkTez และ Flink สามารถทำงานควบคู่ไปกับ MapReduce ได้
แม้ว่า Hadoop จะเป็นที่รู้จักกันดีที่สุดในด้าน MapReduce และระบบไฟล์แบบกระจาย HDFS แต่คำนี้ก็ยังใช้สำหรับกลุ่มโครงการที่เกี่ยวข้องซึ่งอยู่ภายใต้ขอบเขตของการประมวลผลแบบกระจายและการประมวลผลข้อมูลขนาดใหญ่ โครงการอื่นๆ ที่เกี่ยวข้องกับ Hadoop ใน Apache ได้แก่ รังHBase, Mahout, สควูป, ฟลูมและ ZooKeeper
Hadoop Archiเทคเจอร์
Hadoop มีสถาปัตยกรรมแบบมาสเตอร์-สเลฟสำหรับการจัดเก็บข้อมูลและการประมวลผลข้อมูลแบบกระจายโดยใช้ แผนที่ลด และวิธีการของ HDFS แผนภาพด้านล่างแสดงบทบาทเหล่านั้นเคียงข้างกัน โดยมีเลเยอร์การจัดเก็บข้อมูลอยู่ด้านหนึ่งและเลเยอร์การประมวลผลอยู่ด้านตรงข้าม
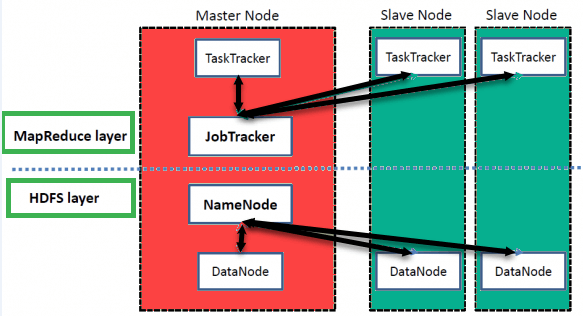
Hadoop ระดับสูง Archiเทคเจอร์
ชื่อโหนด
NameNode ทำหน้าที่จัดเก็บข้อมูลเมตาของไฟล์และไดเร็กทอรีทุกรายการที่ใช้ในเนมสเปซ รวมถึงบล็อกที่ประกอบขึ้นเป็นแต่ละไฟล์ และตำแหน่งที่บล็อกเหล่านั้นอยู่
โหนดข้อมูล
DataNode ทำหน้าที่จัดการสถานะของโหนด HDFS และช่วยให้คุณสามารถโต้ตอบกับบล็อกที่จัดเก็บไว้ โดยจะรายงานสถานะบล็อกและสัญญาณชีพจรเป็นระยะๆ กลับไปยัง NameNode
มาสเตอร์โหนด
โหนดหลักช่วยให้คุณดำเนินการประมวลผลข้อมูลแบบขนานโดยใช้ Hadoop MapReduce
โหนดทาส
โหนดลูกข่าย (Slave Node) คือเครื่องเพิ่มเติมในคลัสเตอร์ Hadoop ที่ช่วยให้คุณจัดเก็บข้อมูลและทำการคำนวณที่ซับซ้อนได้ นอกจากนี้ โหนดลูกข่ายแต่ละโหนดจะทำงานในแต่ละ Task ด้วยTracker และ DataNode ซึ่งช่วยให้คุณสามารถซิงโครไนซ์กระบวนการต่างๆ กับ NameNode และ Job ได้Tracตามลำดับ
ใน Hadoop สามารถตั้งค่าระบบมาสเตอร์หรือสเลฟได้ทั้งในระบบคลาวด์หรือในระบบภายในองค์กร
หมายเหตุเกี่ยวกับการตั้งชื่อ: การสัมภาษณ์Tracเคอร์ และ งานTracเคอร์ จัดอยู่ในกลุ่มรันไทม์ MapReduce รุ่นแรก (MRv1) ตั้งแต่ Hadoop 2.x เป็นต้นไป YARN จะแบ่งหน้าที่กันระหว่างคลัสเตอร์ทั้งหมด ผู้จัดการทรัพยากร, ตัวจัดการโหนด ต่อคนงาน และหนึ่ง แอปพลิเคชันมาสเตอร์ ต่องาน NameNode และ DataNode ยังคงไม่เปลี่ยนแปลง
คุณสมบัติของ Hadoop
เหมาะสำหรับการวิเคราะห์ข้อมูลขนาดใหญ่
As ข้อมูลขนาดใหญ่ เนื่องจากข้อมูลมักมีลักษณะกระจายตัวและไม่มีโครงสร้างที่แน่นอน คลัสเตอร์ Hadoop จึงเหมาะที่สุดสำหรับการวิเคราะห์ข้อมูลขนาดใหญ่ เนื่องจากเป็นตรรกะการประมวลผล (ไม่ใช่ข้อมูลจริง) ที่ไหลไปยังโหนดการประมวลผล จึงใช้แบนด์วิดท์เครือข่ายน้อยลง ซึ่งเรียกว่า ประสิทธิภาพ แนวคิดเรื่องตำแหน่งข้อมูลและยังช่วยเพิ่มประสิทธิภาพของแอปพลิเคชันที่ใช้ Hadoop อีกด้วย
scalability
คลัสเตอร์ Hadoop สามารถขยายขนาดได้อย่างง่ายดายโดยการเพิ่มโหนดคลัสเตอร์เพิ่มเติม จึงรองรับการเติบโตของ Big Data ได้ นอกจากนี้ การขยายขนาดไม่จำเป็นต้องแก้ไขตรรกะของแอปพลิเคชันด้วย
ค่าเผื่อความผิดพลาด
ระบบนิเวศของ Hadoop มีกลไกในการจำลองข้อมูลอินพุตไปยังโหนดคลัสเตอร์อื่น ๆ ด้วยวิธีนี้ ในกรณีที่โหนดคลัสเตอร์ใดโหนดหนึ่งล้มเหลว การประมวลผลข้อมูลยังคงสามารถดำเนินต่อไปได้โดยใช้ข้อมูลที่จัดเก็บไว้ในโหนดคลัสเตอร์อื่น HDFS จะเก็บสำเนาของทุกบล็อกไว้สามชุดโดยค่าเริ่มต้น ซึ่งเป็นค่าที่กำหนดโดย การจำลองแบบ dfs คุณสมบัติดังกล่าว และ NameNode จะทำการจำลองบล็อกใดๆ ที่มีจำนวนลดลงต่ำกว่าค่าที่กำหนดไว้
โครงสร้างเครือข่ายใน Hadoop
โครงสร้าง (การจัดเรียง) ของเครือข่ายส่งผลต่อประสิทธิภาพของคลัสเตอร์ Hadoop เมื่อขนาดของคลัสเตอร์เพิ่มขึ้น นอกจากประสิทธิภาพแล้ว ยังต้องคำนึงถึงความพร้อมใช้งานสูงและการจัดการกับความล้มเหลวด้วย เพื่อให้บรรลุเป้าหมายนี้ การสร้างคลัสเตอร์ Hadoop จึงใช้ประโยชน์จากโครงสร้างเครือข่าย
แผนผังด้านล่างแสดงให้เห็นถึงรูปแบบการจัดเรียงดังกล่าว ตั้งแต่ศูนย์ข้อมูลไปจนถึงโหนดภายในแต่ละแร็ค

โดยทั่วไป แบนด์วิดท์ของเครือข่ายเป็นปัจจัยสำคัญที่ต้องพิจารณาในการสร้างเครือข่ายใดๆ อย่างไรก็ตาม เนื่องจากการวัดแบนด์วิดท์อาจทำได้ยาก ใน Hadoop เครือข่ายจึงถูกแทนด้วยโครงสร้างต้นไม้ และระยะห่างระหว่างโหนดของต้นไม้นี้ (จำนวนฮอป) ถือเป็นปัจจัยสำคัญในการสร้างคลัสเตอร์ Hadoop โดยระยะห่างระหว่างสองโหนดจะเท่ากับผลรวมของระยะห่างจากโหนดทั้งสองไปยังบรรพบุรุษร่วมที่ใกล้ที่สุด
คลัสเตอร์ Hadoop ประกอบด้วยศูนย์ข้อมูล แร็ค และโหนดที่ทำหน้าที่ประมวลผลงานจริง โดยที่ศูนย์ข้อมูลประกอบด้วยแร็ค และแร็คประกอบด้วยโหนด แบนด์วิดท์เครือข่ายที่ใช้ได้สำหรับกระบวนการต่างๆ จะแตกต่างกันไปตามตำแหน่งของกระบวนการ กล่าวคือ แบนด์วิดท์ที่ใช้ได้จะลดลงเมื่อเราอยู่ห่างจาก...
- กระบวนการบนโหนดเดียวกัน
- โหนดที่แตกต่างกันบนชั้นวางเดียวกัน
- โหนดบนชั้นวางที่แตกต่างกันของศูนย์ข้อมูลเดียวกัน
- โหนดในศูนย์ข้อมูลต่างๆ
ระบบการรับรู้แร็คใช้โครงสร้างแบบเดียวกัน: HDFS จะวางสำเนาข้อมูลไว้ในแร็คมากกว่าหนึ่งแร็ค ดังนั้นหากสวิตช์แร็คตัวใดตัวหนึ่งเสียหาย ข้อมูลทุกสำเนาก็จะไม่หายไปด้วย
