
บทแนะนำการใช้งาน ELK Stack: Kibana Logstash และอีสเทลลิสเคิร์ช
 เดวิดคาร์เตอร์
⚡ สรุปอย่างชาญฉลาด
ELK Stack ผสานรวมเครื่องมือโอเพนซอร์สสามอย่าง ได้แก่ Elasticsearch, Logstashและ Kibana — เพื่อรวบรวม จัดเก็บ ค้นหา และแสดงข้อมูลเครื่องจักร ทำให้ทีมวิศวกรรมสามารถบันทึกข้อมูลแบบรวมศูนย์และวิเคราะห์ข้อมูลแบบเรียลไทม์เพื่อแก้ไขปัญหาได้รวดเร็วยิ่งขึ้นในเซิร์ฟเวอร์และแอปพลิเคชันต่างๆ
ELK Stack เป็นหนึ่งในโซลูชันโอเพนซอร์สที่ใช้กันอย่างแพร่หลายที่สุดสำหรับการบันทึกข้อมูลและการวิเคราะห์ข้อมูลแบบรวมศูนย์ บทช่วยสอน ELK Stack นี้จะอธิบายว่า Elasticsearch ทำงานอย่างไร Logstashและ Kibana คืออะไร ทั้งสามเครื่องมือทำงานร่วมกันอย่างไร และแพลตฟอร์มนี้ถูกนำไปใช้ในงานตรวจสอบและสังเกตการณ์ในโลกแห่งความเป็นจริงที่ใดบ้าง
ELK Stack คืออะไร?
การขอ ELK สแต็ค คือชุดของผลิตภัณฑ์โอเพ่นซอร์สสามรายการ ได้แก่ Elasticsearch Logstashและ Kibana มันมีระบบบันทึกข้อมูลแบบรวมศูนย์ ซึ่งช่วยให้คุณระบุปัญหาของเซิร์ฟเวอร์หรือแอปพลิเคชันได้ โดยให้คุณค้นหาบันทึกทั้งหมดได้ในที่เดียว นอกจากนี้ยังช่วยให้คุณเชื่อมโยงบันทึกจากหลายเซิร์ฟเวอร์ภายในช่วงเวลาที่กำหนดได้อีกด้วย
- E ย่อมาจาก Elasticsearch: ใช้สำหรับจัดเก็บข้อมูลบันทึก (log)
- L ย่อมาจาก Logstash: ใช้สำหรับเรือpingรวมถึงการประมวลผลและการจัดเก็บบันทึกข้อมูล
- K ย่อมาจาก Kibana: a เครื่องมือสร้างภาพ (ส่วนติดต่อผู้ใช้บนเว็บ) ที่โฮสต์ผ่าน Nginx หรือ Apache
อีสไทรอัลเสิร์ช, Logstashและ Kibana ล้วนได้รับการพัฒนา บริหารจัดการ และบำรุงรักษาโดยบริษัทชื่อ ยืดหยุ่นได้.
โดยรวมแล้ว ELK Stack ถูกออกแบบมาเพื่อให้ผู้ใช้สามารถดึงข้อมูลจากแหล่งใดก็ได้ ในรูปแบบใดก็ได้ จากนั้นจึงทำการค้นหา วิเคราะห์ และแสดงผลข้อมูลเหล่านั้นแบบเรียลไทม์
ELK สแต็ค Archiเทคเจอร์
เมื่อคุณเข้าใจแล้วว่าสแต็กคืออะไร ส่วนนี้จะอธิบายสถาปัตยกรรมของ ELK และวิธีการไหลเวียนของข้อมูลระหว่างส่วนประกอบต่างๆ
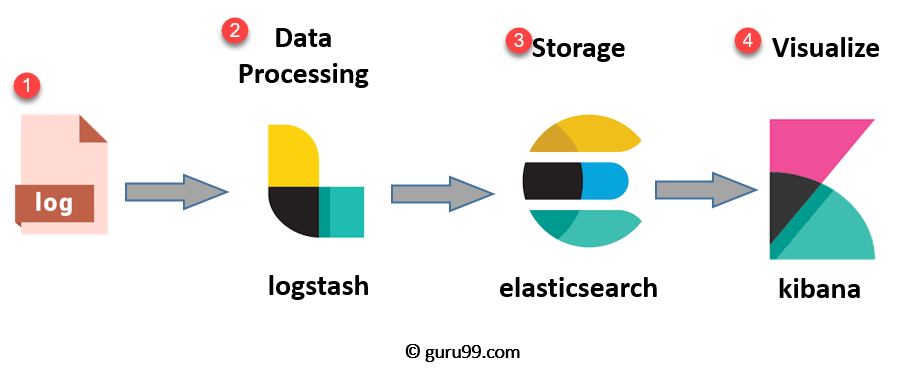
กระบวนการทำงาน ELK มีลำดับขั้นตอนที่ชัดเจน โดยแต่ละเครื่องมือมีหน้าที่เฉพาะของตนเอง:
- บันทึก: ระบุไฟล์บันทึกเซิร์ฟเวอร์ที่จำเป็นต้องนำมาวิเคราะห์แล้ว
- Logstash: รวบรวมข้อมูลบันทึกและเหตุการณ์ จากนั้นทำการวิเคราะห์และแปลงข้อมูลเหล่านั้น
- ยางยืดค้นหา: ข้อมูลที่ถูกแปลงโดย Logstash มีการจัดเก็บ ค้นหา และจัดทำดัชนี
- คิบานะ: ใช้ฐานข้อมูล Elasticsearch เพื่อสำรวจ แสดงภาพ และแบ่งปันข้อมูลเชิงลึก
อย่างไรก็ตาม มักมีการเพิ่มส่วนประกอบที่สี่ชื่อ Beats เพื่อใช้ในการรวบรวมข้อมูล Beats เป็นโปรแกรมส่งข้อมูลขนาดเล็กที่ติดตั้งบนเซิร์ฟเวอร์ และการเพิ่ม Beats นี้ทำให้ Elastic เปลี่ยนชื่อ ELK เป็น Elastic Stack
เมื่อคุณต้องจัดการกับข้อมูลจำนวนมหาศาล คุณอาจเพิ่ม Kafka หรือ RabbitMQ ไว้ด้านหน้าของไปป์ไลน์เพื่อทำการบัฟเฟอร์และเพิ่มความยืดหยุ่น
เพื่อเพิ่มความปลอดภัย สามารถติดตั้งพร็อกซีแบบย้อนกลับ เช่น Nginx ไว้ด้านหน้าของระบบได้

เมื่อคำนึงถึงสถาปัตยกรรมแล้ว ส่วนต่อไปนี้จะเจาะลึกรายละเอียดของแต่ละผลิตภัณฑ์โอเพนซอร์สในระบบ
Elasticsearch คืออะไร?
Elasticsearch คือ ฐานข้อมูล NoSQL พัฒนาขึ้นโดยใช้เครื่องมือค้นหา Lucene และสร้างขึ้นด้วย RESTful API ทำให้ติดตั้งง่าย มีความน่าเชื่อถือสูง จัดการง่าย และจัดเก็บข้อมูลทั้งหมดไว้ในที่เดียว ช่วยให้คุณสามารถเรียกใช้การค้นหาขั้นสูงและค้นหาเอกสารได้อย่างรวดเร็ว
Elasticsearch ยังช่วยให้คุณจัดเก็บ ค้นหา และวิเคราะห์ข้อมูลปริมาณมากได้อีกด้วย โดยส่วนใหญ่มักใช้เป็นกลไกหลักที่ขับเคลื่อนแอปพลิเคชันที่มีความต้องการด้านการค้นหาสูง
เนื่องจาก Elasticsearch เพิ่มฟังก์ชันการวิเคราะห์และคุณสมบัติขั้นสูงมากมายนอกเหนือจากการค้นหาที่รวดเร็ว ทำให้ Elasticsearch ได้รับการนำไปใช้อย่างแพร่หลายในแพลตฟอร์มการค้นหาสำหรับเว็บและแอปพลิเคชันมือถือสมัยใหม่
คุณสมบัติของ Elasticsearch
Elasticsearch มีความสามารถมากมายในการจัดทำดัชนีและค้นหาข้อมูล:
- เซิร์ฟเวอร์ค้นหาแบบโอเพนซอร์สที่เขียนด้วยภาษาโปรแกรม Java.
- สามารถจัดทำดัชนีข้อมูลที่หลากหลายประเภทได้
- มีเว็บอินเทอร์เฟซ REST API ที่แสดงผลในรูปแบบ JSON
- ค้นหาข้อความเต็ม
- การค้นหาแบบเรียลไทม์ใกล้เคียง (NRT)
- ระบบจัดเก็บเอกสาร JSON ที่แบ่งส่วน ทำสำเนา และสามารถค้นหาได้
- ระบบจัดเก็บเอกสารแบบกระจายศูนย์ที่ไม่ต้องใช้ Schema รองรับ REST และ JSON
- รองรับหลายภาษาและระบุตำแหน่งทางภูมิศาสตร์
ข้อดีของ Elasticsearch
- สามารถจัดเก็บข้อมูลที่ไม่มีโครงสร้าง (schema) และยังสามารถสร้างโครงสร้างสำหรับข้อมูลของคุณได้อีกด้วย
- ช่วยให้คุณสามารถจัดการระเบียนทีละรายการโดยใช้ API หลายเอกสารได้
- รองรับการกรองและการค้นหาข้อมูลเพื่อรับข้อมูลเชิงลึก
- พัฒนาขึ้นโดยใช้ Apache Lucene และมี RESTful API ให้บริการ
- มอบความสามารถในการขยายขนาดในแนวนอน ความน่าเชื่อถือ และความสามารถในการใช้งานหลายผู้เช่า เพื่อการจัดทำดัชนีแบบเรียลไทม์และการค้นหาที่รวดเร็วยิ่งขึ้น
- ช่วยให้คุณปรับขนาดได้ทั้งแนวตั้งและแนวนอน
ตารางด้านล่างนี้อธิบายคำศัพท์สำคัญที่คุณจะพบเจอเมื่อทำงานกับ Elasticsearch:
| เทอม | การใช้ |
|---|---|
| Cluster | คลัสเตอร์คือกลุ่มของโหนดที่รวมกันเพื่อจัดเก็บข้อมูลของคุณและมอบความสามารถในการจัดทำดัชนีและการค้นหาแบบรวม |
| โหนด | โหนดคืออินสแตนซ์ Elasticsearch เดียว มันจะถูกสร้างขึ้นเมื่ออินสแตนซ์ Elasticsearch เริ่มทำงาน |
| ดัชนี | ดัชนีคือกลุ่มเอกสารที่มีลักษณะคล้ายคลึงกัน เช่น ข้อมูลลูกค้าหรือแคตตาล็อกสินค้า มีประโยชน์สำหรับการจัดทำดัชนี การค้นหา การอัปเดต และการลบข้อมูล และคุณสามารถกำหนดดัชนีได้หลายรายการในกลุ่มเดียว |
| เอกสาร | เอกสารคือหน่วยข้อมูลพื้นฐานที่สามารถจัดทำดัชนีได้ โดยแสดงในรูปแบบคู่คีย์-ค่า JSON และเอกสารแต่ละฉบับจะเชื่อมโยงกับประเภทและรหัสเฉพาะที่ไม่ซ้ำกัน |
| Shard | ดัชนีทุกตัวสามารถแบ่งออกเป็นชาร์ดได้หลายส่วนเพื่อกระจายข้อมูล ชาร์ดคือส่วนย่อยที่สุดของดัชนีและสามารถกระจายไปทั่วคลัสเตอร์ได้เมื่อเพิ่มโหนดมากขึ้น |
ความหมายของ Logstash?
Logstash คือเครื่องมือรวบรวมข้อมูลของระบบ ทำหน้าที่รวบรวมข้อมูลขาเข้าและส่งต่อไปยัง Elasticsearch รวบรวมข้อมูลทุกประเภทจากแหล่งต่างๆ และทำให้พร้อมใช้งานเพื่อดำเนินการต่อ
Logstash สามารถรวมข้อมูลจากแหล่งข้อมูลที่แตกต่างกันและปรับให้เป็นมาตรฐานในปลายทางที่คุณเลือกได้ これにより คุณสามารถทำความสะอาดและทำให้ข้อมูลทั้งหมดของคุณเข้าถึงได้ง่ายสำหรับกรณีการวิเคราะห์และการแสดงภาพข้อมูลที่หลากหลาย
ประกอบด้วยสามองค์ประกอบ:
- Input: รับข้อมูลบันทึกเข้ามาและแปลงให้อยู่ในรูปแบบที่เครื่องสามารถอ่านได้
- ตัวกรอง: ชุดเงื่อนไขที่ทำให้เกิดการกระทำเฉพาะอย่างต่อเหตุการณ์หนึ่งๆ
- Output: ผู้มีอำนาจตัดสินใจที่ทำหน้าที่กำหนดเส้นทางให้กับเหตุการณ์หรือบันทึกข้อมูลที่ได้รับการประมวลผลแต่ละรายการ
คุณสมบัติของ Logstash
Logstash ประกอบด้วยคุณสมบัติหลายประการที่ทำให้การประมวลผลบันทึกข้อมูลมีความยืดหยุ่น:
- เหตุการณ์ต่างๆ จะผ่านแต่ละขั้นตอนโดยใช้คิวภายใน
- อนุญาตให้ป้อนข้อมูลบันทึกได้หลากหลายรูปแบบ
- รองรับการกรองและการวิเคราะห์ข้อมูลบันทึกของคุณ
ข้อดีของการ Logstash
- รวมศูนย์การประมวลผลข้อมูลของคุณ
- วิเคราะห์ข้อมูลและเหตุการณ์หลากหลายประเภท ทั้งแบบมีโครงสร้างและไม่มีโครงสร้าง
- มีปลั๊กอินสำหรับเชื่อมต่อกับแหล่งข้อมูลและแพลตฟอร์มต่างๆ มากมาย
คิบานะคืออะไร?
Kibana คือเครื่องมือแสดงภาพข้อมูลที่ช่วยเติมเต็ม ELK Stack ใช้สำหรับแสดงภาพเอกสาร Elasticsearch และช่วยให้นักพัฒนาได้รับข้อมูลเชิงลึกอย่างรวดเร็วผ่านไดอะแกรมแบบโต้ตอบ ข้อมูลเชิงพื้นที่ และกราฟที่ทำให้การค้นหาข้อมูลที่ซับซ้อนเข้าใจง่ายขึ้น
คุณสามารถใช้ Kibana เพื่อค้นหา ดู และโต้ตอบกับข้อมูลที่จัดเก็บอยู่ในดัชนี Elasticsearch นอกจากนี้ยังช่วยให้คุณดำเนินการขั้นสูงได้อีกด้วย การวิเคราะห์ข้อมูล และนำเสนอข้อมูลของคุณในรูปแบบตาราง แผนภูมิ และแผนที่ที่หลากหลาย
Kibana รองรับวิธีการค้นหาข้อมูลหลายวิธี โดยประเภทการค้นหาที่ใช้บ่อยที่สุดมีดังต่อไปนี้:
| ประเภทการสืบค้น | การใช้ |
|---|---|
| ค้นหาข้อความฟรี | ใช้สำหรับค้นหาข้อความที่ระบุ |
| การค้นหาระดับฟิลด์ | ใช้สำหรับค้นหาข้อความภายในฟิลด์ที่กำหนด |
| คำสั่งเชิงตรรกะ | ใช้สำหรับรวมผลการค้นหาเข้าด้วยกันเป็นประโยคตรรกะ |
| การค้นหาความใกล้เคียง | ใช้สำหรับค้นหาคำที่อยู่ในช่วงตัวอักษรที่กำหนด |
นอกจากนี้ Kibana ยังมีฟีเจอร์ที่มีประสิทธิภาพมากมายสำหรับการสำรวจข้อมูลที่จัดทำดัชนีไว้:
- แดชบอร์ดส่วนหน้าที่มีประสิทธิภาพ ซึ่งแสดงข้อมูลที่จัดทำดัชนีจากคลัสเตอร์ Elasticsearch ในรูปแบบภาพ
- ช่วยให้สามารถค้นหาข้อมูลที่จัดทำดัชนีไว้แบบเรียลไทม์ได้
- ช่วยให้คุณสามารถค้นหา ดู และโต้ตอบกับข้อมูลที่จัดเก็บอยู่ใน Elasticsearch ได้
- ดำเนินการสืบค้นข้อมูลและแสดงผลลัพธ์ในรูปแบบแผนภูมิ ตาราง และแผนที่
- แดชบอร์ดที่ปรับแต่งได้เพื่อการวิเคราะห์และแยกแยะข้อมูล Logstash บันทึกข้อมูลใน Elasticsearch
- นำเสนอข้อมูลทางประวัติศาสตร์ในรูปแบบของกราฟ แผนภูมิ และอื่นๆ
- นำเสนอแดชบอร์ดแบบเรียลไทม์ที่ตั้งค่าได้ง่าย
ข้อดีและข้อเสียของ Kibana
เช่นเดียวกับเครื่องมืออื่นๆ Kibana ก็มีจุดแข็งที่ชัดเจนซึ่งเป็นเหตุผลที่ทำให้ได้รับความนิยม:
- การแสดงผลข้อมูลทำได้ง่าย
- ผสานรวมเข้ากับ Elasticsearch อย่างสมบูรณ์
- ทำหน้าที่เป็นเครื่องมือแสดงภาพข้อมูลโดยเฉพาะ
- นำเสนอการวิเคราะห์แบบเรียลไทม์ การสร้างแผนภูมิ การสรุป และการแก้ไขข้อผิดพลาด
- มีอินเทอร์เฟซที่ใช้งานง่ายและเป็นมิตรกับผู้ใช้
- อนุญาตให้แชร์ภาพรวมของบันทึกที่คุณค้นหา
- อนุญาตให้บันทึกและจัดการแดชบอร์ดได้หลายรายการ
นอกจากนี้ยังมีข้อจำกัดบางประการที่ควรคำนึงถึง:
- ใช้งานได้เฉพาะกับ Elasticsearch ในฐานะแหล่งข้อมูลเท่านั้น
- การสร้างและปรับแต่งแดชบอร์ดที่ซับซ้อนอาจต้องใช้เวลาเรียนรู้ค่อนข้างนาน
ทำไมต้องวิเคราะห์บันทึก?
ในโครงสร้างพื้นฐานบนระบบคลาวด์ ประสิทธิภาพและการแยกส่วนมีความสำคัญอย่างยิ่ง
ประสิทธิภาพของเครื่องเสมือนในระบบคลาวด์อาจแตกต่างกันไปตามภาระงาน สภาพแวดล้อม และจำนวนผู้ใช้งานที่ใช้งานอยู่ ดังนั้นความน่าเชื่อถือและความล้มเหลวของโหนดจึงอาจกลายเป็นปัญหาสำคัญได้
A แพลตฟอร์มการจัดการบันทึก สามารถตรวจสอบปัญหาเหล่านี้ทั้งหมดได้ นอกจากนี้ยังสามารถประมวลผลบันทึกระบบปฏิบัติการ บันทึกเว็บเซิร์ฟเวอร์ Nginx และ IIS สำหรับการวิเคราะห์ปริมาณการใช้งาน บันทึกแอปพลิเคชัน และบันทึกที่สร้างขึ้นบน AWS (Amazon บริการเว็บ).
ท้ายที่สุดแล้ว การจัดการบันทึกข้อมูลจะช่วยได้ DevOps วิศวกรและผู้ดูแลระบบสามารถตัดสินใจได้ดีขึ้นโดยอาศัยข้อมูล นี่คือเหตุผลที่การวิเคราะห์บันทึกข้อมูลผ่าน Elastic Stack หรือเครื่องมือที่คล้ายกันจึงกลายเป็นสิ่งจำเป็น
ELK กับ Splunk
คำถามที่พบบ่อยคือ ELK Stack แตกต่างจากรุ่นอื่นอย่างไร Splunkซึ่งเป็นทางเลือกเชิงพาณิชย์ที่ได้รับความนิยม ตารางด้านล่างสรุปความแตกต่างหลักๆ:
| ELK | Splunk |
|---|---|
| ELK เป็นเครื่องมือโอเพนซอร์ส | Splunk เป็นเครื่องมือเชิงพาณิชย์ |
| ELK ไม่ได้เสนอ Solaris ความสะดวกในการพกพาเนื่องจาก Kibana | ข้อเสนอของ Splunk Solaris ความเบา |
| ความเร็วในการประมวลผลมีจำกัดอย่างเคร่งครัด | ให้บริการประมวลผลที่แม่นยำและรวดเร็ว |
| ELK คือชุดเทคโนโลยีที่สร้างขึ้นจากการผสมผสานระหว่าง Elasticsearch, Logstashและคิบาน่า | Splunk เป็นเครื่องมือที่เป็นกรรมสิทธิ์ของบริษัท ซึ่งให้บริการทั้งโซลูชันแบบติดตั้งในองค์กรและแบบคลาวด์ |
| ใน ELK การค้นหา การวิเคราะห์ และการแสดงผลข้อมูลจะทำได้ก็ต่อเมื่อตั้งค่าสแต็กเสร็จแล้วเท่านั้น | Splunk เป็นแพ็กเกจการจัดการข้อมูลที่สมบูรณ์แบบพร้อมใช้งานได้ทันที |
| ELK มีการบูรณาการกับเครื่องมืออื่นๆ ในตัวอย่างจำกัด | Splunk มีประโยชน์สำหรับการตั้งค่าการเชื่อมต่อกับเครื่องมืออื่นๆ |
กรณีศึกษา
บริษัทที่มีชื่อเสียงหลายแห่งใช้ ELK Stack ในการบันทึกข้อมูลและวิเคราะห์ข้อมูลในระดับขนาดใหญ่ ตัวอย่างด้านล่างแสดงให้เห็นถึงวิธีการใช้งานจริง
Netflix
Netflix บริษัทพึ่งพาแพลตฟอร์ม ELK Stack อย่างมากในการตรวจสอบและวิเคราะห์บันทึกความปลอดภัยของการดำเนินงานบริการลูกค้า แพลตฟอร์มนี้ช่วยให้ Netflix จัดทำดัชนี จัดเก็บ และค้นหาเอกสารในกลุ่มคลัสเตอร์มากกว่าสิบห้ากลุ่ม ซึ่งแต่ละกลุ่มประกอบด้วยโหนดประมาณ 800 โหนด
เว็บไซต์เครือข่ายมืออาชีพ LinkedIn ใช้ ELK Stack เพื่อตรวจสอบประสิทธิภาพและความปลอดภัย ทีมงานของ LinkedIn ได้ผสานรวม ELK เข้ากับ Kafka เพื่อจัดการปริมาณงานแบบเรียลไทม์ และการดำเนินงานครอบคลุมคลัสเตอร์มากกว่า 100 แห่งในศูนย์ข้อมูล 6 แห่ง
เส้นปลายทางที่ดักไว้เมื่อเดินทางมาถึง
Tripwire ผู้ให้บริการระบบจัดการข้อมูลและเหตุการณ์ด้านความปลอดภัย (SIEM) ระดับโลก ใช้ ELK Stack เพื่อสนับสนุนการวิเคราะห์บันทึกข้อมูลแพ็กเก็ต
กลาง
Medium แพลตฟอร์มเผยแพร่บล็อกยอดนิยม ใช้ ELK Stack ในการแก้ไขปัญหาที่เกิดขึ้นจริงและตรวจจับข้อผิดพลาด DynamoDB จุดเด่นต่างๆ ระบบนี้ช่วยให้บริษัทสามารถรองรับผู้อ่านที่ไม่ซ้ำกัน 25 ล้านคน และบทความใหม่หลายพันรายการในแต่ละสัปดาห์
ข้อดีและข้อเสียของ ELK Stack
ข้อดี
ELK Stack มีข้อดีหลายประการที่ทำให้ได้รับการใช้งานอย่างแพร่หลาย:
- ระบบจะทำงานได้ดีที่สุดเมื่อบันทึกข้อมูลจากแอปพลิเคชันต่างๆ ในองค์กรมารวมกันอยู่ในอินสแตนซ์ ELK เดียว
- มันให้ข้อมูลเชิงลึกที่ครบถ้วนจากแหล่งข้อมูลเพียงแหล่งเดียว และช่วยลดความจำเป็นในการล็อกอินเข้าสู่แหล่งข้อมูลแยกต่างหากหลายร้อยแหล่ง
- ติดตั้งในสถานที่ได้อย่างรวดเร็ว
- ติดตั้งง่ายและปรับขนาดได้ทั้งแนวตั้งและแนวนอน
- Elastic มีไคลเอ็นต์สำหรับหลายภาษา รวมถึง Ruby ด้วย PythonPHP, Perl, .NET Javaและ Javaต้นฉบับ
- มีไลบรารีสำหรับภาษาโปรแกรมและภาษาสคริปต์หลายภาษาให้เลือกใช้
ข้อเสีย
ถึงแม้ว่า ELK Stack จะมีจุดแข็งหลายประการ แต่ก็มีข้อเสียอยู่บ้างที่ควรพิจารณา:
- เมื่อคุณเปลี่ยนไปใช้ระบบที่ซับซ้อนมากขึ้น การจัดการส่วนประกอบต่างๆ อาจกลายเป็นเรื่องยาก
- ต้องใช้เวลาเรียนรู้พอสมควร ดังนั้นจึงควรเตรียมใจไว้ว่าจะต้องลองผิดลองถูกบ้างในระหว่างที่รอประสบการณ์
