
Hive ETL: กำลังโหลด JSON, XML, ตัวอย่างข้อมูลข้อความ
 เดวิดคาร์เตอร์
⚡ สรุปอย่างชาญฉลาด
Hive ETL แปลงไฟล์ข้อความ XML และ JSON ให้เป็นตารางที่สามารถสืบค้นได้ โดยการโหลดไฟล์เหล่านั้นเข้าไปใน Hive และดึงข้อมูลออกมาtracการดึงค่าด้วย xpath() และ get_json_object() ทำให้ผู้1วิเคราะห์สามารถเข้าถึงข้อมูล Hadoop กึ่งโครงสร้างผ่านทางอินเทอร์เฟซ SQL ได้
Hive เป็นเครื่องมือ ETL และคลังข้อมูลบนพื้นฐานของ... Hadoop ระบบนิเวศน์นี้มีฟังก์ชันการทำงานต่างๆ เช่น การสร้างแบบจำลองข้อมูล การจัดการข้อมูล การประมวลผลข้อมูล และการสอบถามข้อมูล ตัวอย่างข้อมูลtracการดำเนินการใน Hive หมายถึงการสร้างตารางใน Hive การโหลดข้อมูลที่มีโครงสร้างและกึ่งโครงสร้าง รวมถึงการสืบค้นข้อมูลตามความต้องการ
สำหรับการประมวลผลแบบกลุ่ม เราจะเขียนสคริปต์ที่กำหนดเองโดยใช้สคริปต์ map และ reduce ที่กำหนดเองในภาษาสคริปต์ ซึ่งจะช่วยให้... SQL เช่นสภาพแวดล้อมและการสนับสนุนเพื่อการสืบค้นที่ง่ายดาย
การทำงานกับข้อมูลที่มีโครงสร้างโดยใช้ Hive
ข้อมูลที่มีโครงสร้าง หมายความว่าข้อมูลนั้นอยู่ในรูปแบบที่ถูกต้อง คือมีแถวและคอลัมน์ ซึ่งคล้ายคลึงกับ... อาร์ดีบีเอ็มเอส ข้อมูลที่มีแถวและคอลัมน์ที่เหมาะสม
ต่อไปนี้เราจะทำการโหลดข้อมูลที่มีโครงสร้างซึ่งอยู่ในไฟล์ข้อความเข้าไปใน Hive
ขั้นตอน 1) ในขั้นตอนนี้ เรากำลังสร้างตาราง “employees_guru” พร้อมชื่อคอลัมน์ เช่น Id, Name, Age, Address, Salary และ Department ของพนักงานพร้อมประเภทข้อมูล

จากภาพหน้าจอข้างต้น เราสามารถสังเกตได้ดังต่อไปนี้:
- การสร้างตาราง “employees_guru”
- กำลังโหลดข้อมูลจากไฟล์ Employees.txt ลงในตาราง “employees_guru”
ขั้นตอน 2) ในขั้นตอนนี้ เราจะแสดงเนื้อหาที่จัดเก็บไว้ในตารางนี้โดยใช้คำสั่ง “เลือก” (Select) เราสามารถดูเนื้อหาในตารางได้จากภาพหน้าจอต่อไปนี้

ตัวอย่างโค้ด
แบบสอบถามที่จะดำเนินการ
1) Create table employees_guru(Id INT, Name STRING, Age INT, Address STRING, Salary FLOAT, Department STRING)
> Row format delimited
> Fields terminated by ',';
2) load data local inpath '/home/hduser/Employees.txt' into TABLE employees_guru;
3) select * from employees_guru;
การทำงานกับข้อมูลกึ่งโครงสร้างโดยใช้ Hive (XML, JSON)
Hive ทำหน้าที่ประมวลผลข้อมูล (ETL) ในระบบนิเวศของ Hadoop โดยทำหน้าที่เป็นตัวกลาง เครื่องมือ ETLการใช้งาน MapReduce ในแอปพลิเคชันบางประเภทอาจเป็นเรื่องยาก Hive สามารถลดความซับซ้อนนั้นและมอบโซลูชันที่ดีที่สุดสำหรับแอปพลิเคชันด้านไอทีในแง่ของภาคส่วนคลังข้อมูล
ข้อมูลกึ่งโครงสร้าง เช่น XML และ JSON สามารถประมวลผลได้ง่ายกว่าโดยใช้ Hive ขั้นแรก เราจะมาดูวิธีการใช้ Hive สำหรับ... XML.
แปลง XML เป็นตาราง Hive
ในที่นี้ เราจะโหลดข้อมูล XML ลงในตาราง Hive และเราจะดึงค่าที่เก็บไว้ในแท็ก XML
ขั้นตอน 1) สร้างตาราง “xmlsample_guru” โดยมีคอลัมน์ str ที่มีชนิดข้อมูลเป็นสตริง

จากภาพหน้าจอข้างต้น เราสามารถสังเกตได้ดังต่อไปนี้:
- การสร้างตาราง “xmlsample_guru”
- กำลังโหลดข้อมูลจากไฟล์ test.xml ลงในตาราง “xmlsample_guru”
ขั้นตอน 2) การใช้ XPath ด้วยเมธอด xpath() เราจะสามารถดึงข้อมูลที่จัดเก็บอยู่ภายในแท็ก XML ได้
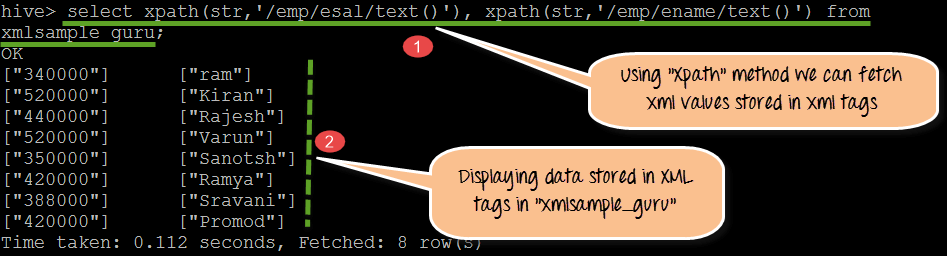
จากภาพหน้าจอข้างต้น เราสามารถสังเกตได้ดังต่อไปนี้:
- เราใช้เมธอด xpath() เพื่อดึงค่าที่จัดเก็บไว้ภายใต้ /emp/esal/ และ /emp/ename/
- ค่าต่างๆ ที่อยู่ภายในแท็ก XML ในขั้นตอนนี้ เราจะแสดงค่าจริงที่จัดเก็บไว้ภายใต้แท็ก XML ในตาราง “xmlsample_guru”
โปรดทราบว่า xpath() จะส่งคืนอาร์เรย์ของสตริง ในขณะที่ xpath_string(), xpath_int() และ xpath_double() จะส่งคืนค่าประเภทเดียว
ขั้นตอน 3) ในขั้นตอนนี้ เราจะดึงและแสดงข้อมูล XML ดิบของตาราง “xmlsample_guru”

จากภาพหน้าจอข้างต้น เราสามารถสังเกตได้ดังต่อไปนี้:
- ข้อมูล XML จริงที่แสดงพร้อมกับแท็ก
- หากเราพิจารณาแท็กเพียงแท็กเดียว จะพบว่ามี "emp" เป็นแท็กหลัก และมี "ename" กับ "esal" เป็นแท็กย่อย
Code ตัวอย่าง:
แบบสอบถามที่จะดำเนินการ
1) create table xmlsample_guru(str string);                                                                                                   2) load data local inpath '/home/hduser/test.xml' overwrite  into table xmlsample_guru;
3) select xpath(str,'emp/ename/text()'), xpath(str,'emp/esal/text()') from xmlsample_guru;
เจสัน (Javaสัญกรณ์วัตถุสคริปต์)
ข้อมูลจากโซเชียลมีเดียและเว็บไซต์มักถูกจัดเก็บในรูปแบบ JSON เมื่อใดก็ตามที่เราพยายามดึงข้อมูลจากเซิร์ฟเวอร์ออนไลน์ ระบบจะส่งคืนไฟล์ JSON โดยใช้ Hive เป็นที่เก็บข้อมูล เราสามารถโหลดข้อมูล JSON ลงในตาราง Hive ได้โดยการสร้างสคีมา
แปลง JSON เป็นตาราง Hive
ในส่วนนี้ เราจะโหลดข้อมูล JSON ลงในตาราง Hive และเราจะดึงค่าที่จัดเก็บไว้ในสคีมา JSON ออกมา
ขั้นตอน 1) ในขั้นตอนนี้ เราจะสร้างตาราง JSON ชื่อ “json_guru” เมื่อสร้างเสร็จแล้ว เราจะโหลดและแสดงเนื้อหาของสคีมาจริง

จากภาพหน้าจอข้างต้น เราสามารถสังเกตได้ดังต่อไปนี้:
- การสร้างตาราง “json_guru”
- กำลังโหลดข้อมูลจากไฟล์ test.json ลงในตาราง “json_guru”
- แสดงโครงสร้างข้อมูลจริงของไฟล์ JSON ที่จัดเก็บอยู่ในตาราง json_guru
ขั้นตอน 2) เราสามารถดึงค่าข้อมูลที่จัดเก็บไว้ในโครงสร้างลำดับชั้น JSON ได้โดยใช้เมธอด get_json_object()

จากภาพหน้าจอข้างต้น เราสามารถสังเกตได้ดังต่อไปนี้:
- การใช้ get_json_object(str,'$.ecode') สามารถดึงค่า ecode จากตาราง json_guru ได้ ในทำนองเดียวกัน การใช้ get_json_object(str,'$.ename') และ get_json_object(str,'$.sal') จะดึงค่า ename และ sal จากตาราง json_guru
- ค่าที่จัดเก็บไว้ภายในลำดับชั้น JSON ใน json_guru
เนื่องจาก get_json_object() วิเคราะห์เอกสารเพียงครั้งเดียวต่อการเรียกใช้ json_tuple() จึงประหยัดกว่าเมื่อต้องการคีย์หลายตัว และ JSON SerDe จะแมปเอกสารไปยังคอลัมน์ที่มีประเภทข้อมูลเมื่อโหลดข้อมูล
Code ตัวอย่างข้อมูล
แบบสอบถามที่จะดำเนินการ
1) create table json_guru(str string);
2) load data inpath 'home/hduser/test.json' into table json_guru;
3) select * from json_guru;
4) select get_json_object(str,'$.ecode') as ecode, get_json_object(str,'$.ename') as ename ,get_json_object(str,'$.sal') as salary from json_guru;
การแปลง JSON ที่ซับซ้อนเป็นตาราง Hive
ในส่วนนี้ เราจะโหลดข้อมูล JSON ที่ซับซ้อนลงในตาราง Hive และเราจะดึงค่าที่จัดเก็บไว้ในสคีมา JSON ออกมา
ขั้นตอน 1) สร้าง complexjson_guru โดยใช้ฟิลด์คอลัมน์เดียว

จากภาพหน้าจอข้างต้น เราสามารถสังเกตได้ดังต่อไปนี้:
- การสร้างตาราง complexjson_guru โดยมีคอลัมน์เดียวเป็นชนิดข้อมูลสตริง
- กำลังโหลดข้อมูลลงใน complexjson_guru จากไฟล์ complex JSON ชื่อ emp.json
ขั้นตอน 2) โดยการใช้ get_json_object เราสามารถดึงเนื้อหาจริงที่จัดเก็บอยู่ภายในโครงสร้างลำดับชั้นของไฟล์ JSON ได้
จากภาพหน้าจอต่อไปนี้ เราจะเห็นผลลัพธ์ของข้อมูลที่จัดเก็บไว้ใน complexjson_guru
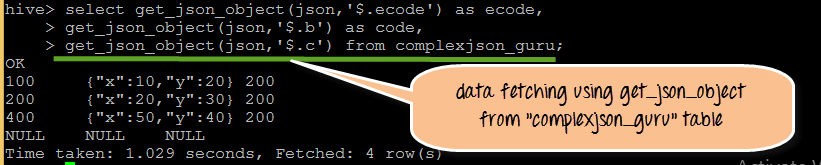
ขั้นตอน 3) ในขั้นตอนนี้ เราสามารถใช้คำสั่ง “Select” เพื่อดูข้อมูล JSON ที่ซับซ้อนซึ่งจัดเก็บอยู่ในตาราง “complexjson_guru” ได้

ตัวอย่างโค้ด
แบบสอบถามที่จะดำเนินการ
1) create table complexjson_guru(json string);
2) load data inpath 'home/hduser/emp.json' into table complexjson_guru;
3) select get_json_object(json,'$.ecode') as ecode ,get_json_object(json,'$.b') as code, get_json_object(json,'$.c') from complexjson_guru;
4) select * from complexjson_guru;
การใช้งาน Hive ในโครงการแบบเรียลไทม์ – ควรใช้เมื่อใดและที่ไหน
ควรใช้ Hive ในระบบนิเวศของ Hadoop เมื่อใดและที่ไหน:
เมื่อ
- เมื่อทำงานกับฟังก์ชันทางสถิติที่แข็งแกร่งและทรงพลังในระบบนิเวศ Hadoop
- เมื่อทำงานกับการประมวลผลข้อมูลที่มีโครงสร้างและกึ่งโครงสร้าง
- ในฐานะเครื่องมือคลังข้อมูลด้วย Hadoop
- การนำเข้าข้อมูลแบบเรียลไทม์ด้วย HBase ซึ่งสามารถใช้ Hive ได้
ที่ไหน
- เพื่อความสะดวกในการใช้งานในฐานะเครื่องมือ ETL และคลังข้อมูล
- เพื่อสร้างสภาพแวดล้อมแบบ SQL และสามารถเรียกดูข้อมูลได้เหมือน SQL โดยใช้ HiveQL
- เพื่อใช้งานและปรับใช้สคริปต์แผนที่และตัวลดขนาดที่กำหนดเองสำหรับความต้องการเฉพาะของลูกค้า
