
สร้างและวาง INDEX เข้าไป Cassandra
 เดวิดคาร์เตอร์
⚡ สรุปอย่างชาญฉลาด
สร้างและลบดัชนีใน Cassandra ฟังก์ชันนี้ช่วยให้สามารถกรองข้อมูลในคอลัมน์ที่ไม่ใช่ส่วนหนึ่งของคีย์หลักได้ หน้านี้ครอบคลุมคำสั่ง CREATE INDEX และ DROP INDEX กฎการตั้งชื่อ ประเภทของดัชนีที่มีให้เลือก และกรณีที่การใช้ดัชนีไม่ใช่ทางออกที่เหมาะสม
Cassandra สร้างดัชนี
คำสั่ง 'สร้างดัชนี' สร้างดัชนีในคอลัมน์ที่ระบุโดยผู้ใช้ หากมีข้อมูลอยู่แล้วสำหรับคอลัมน์ที่คุณต้องการจัดทำดัชนี Cassandra สร้างดัชนีบนข้อมูลระหว่างการดำเนินการคำสั่ง 'สร้างดัชนี'
- หลังจากสร้างดัชนีแล้ว Cassandra จัดทำดัชนีข้อมูลใหม่โดยอัตโนมัติเมื่อมีการแทรกข้อมูล
- ไม่สามารถสร้างดัชนีบนคีย์หลักได้ เนื่องจากคีย์หลักได้รับการจัดทำดัชนีแล้ว
- ระบบรองรับการสร้างดัชนีบนคอลัมน์ของชุดข้อมูล โดยใช้รูปแบบ KEYS, VALUES หรือ ENTRIES ขึ้นอยู่กับสิ่งที่ต้องการค้นหา
- โดยไม่ต้องจัดทำดัชนีบนคอลัมน์ Cassandra ไม่สามารถกรองคอลัมน์นั้นได้ เว้นแต่ว่าจะเป็นคีย์หลัก
นั่นคือเหตุผลที่ต้องใช้การกรองคอลัมน์ใน Cassandraจำเป็นต้องสร้างดัชนี
วากยสัมพันธ์
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
ตัวอย่าง
นี่คือภาพรวมที่พยายามกรองคอลัมน์ "แผนก" โดยไม่สร้างดัชนี เพื่อเป็นการตอบสนอง ข้อผิดพลาดจึงถูกส่งคืน

นี่คือภาพรวมที่มีการสร้างดัชนีในคอลัมน์ฝ่าย

CREATE INDEX DeptIndex ON University.Student (dept);
นี่คือภาพรวมที่คอลัมน์ 'แผนก' จะถูกกรองได้สำเร็จ

SELECT * FROM University.Student WHERE dept = 'CS';
ชื่อดัชนีเป็นตัวเลือกเสริม การละเว้นชื่อดัชนีจะช่วยให้... Cassandra สร้างดัชนีโดยอัตโนมัติ ซึ่งมีความสำคัญเมื่อต้องลบดัชนีนั้นในภายหลัง
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra วางดัชนี
คำสั่ง 'วางดัชนี' จะปล่อยดัชนีที่ระบุ หากไม่ได้ระบุชื่อดัชนีในระหว่างการสร้างดัชนี ชื่อดัชนีจะเป็น TableName_ColumnName_idx
- หากไม่มีดัชนีอยู่ ก็จะส่งคืนข้อผิดพลาด เว้นแต่ว่ามีการใช้ IF EXISTS ซึ่งจะส่งคืน no-op
- คุณต้องระบุชื่อคีย์สเปซพร้อมกับชื่อดัชนี มิเช่นนั้นระบบจะค้นหาดัชนีในคีย์สเปซปัจจุบัน
วากยสัมพันธ์
DROP INDEX IF EXISTS KeyspaceName.IndexName;
ตัวอย่าง
นี่คือภาพรวมของคำสั่งที่ดำเนินการ 'Drop index' ซึ่งจะปล่อยดัชนี DeptIndex
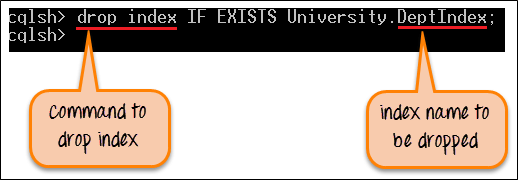
DROP INDEX IF EXISTS University.DeptIndex;
หลังจากดำเนินการคำสั่งสำเร็จ DeptIndex จะถูกละทิ้งจากคีย์สเปซ ขณะนี้ข้อมูลไม่สามารถกรองโดยแผนกคอลัมน์ได้
เพื่อยืนยันว่ามีดัชนีใดบ้างก่อนที่จะลบออกping หนึ่ง อธิบายตารางและอ่านคำจำกัดความของดัชนีที่ด้านล่างของผลลัพธ์
DESCRIBE TABLE University.Student;
ประเภทของดัชนีใน Cassandra
คำสั่งข้างต้นสร้างดัชนีรองมาตรฐาน แต่มีกลไกที่แตกต่างกันสามแบบ และแต่ละแบบมีพฤติกรรมที่แตกต่างกันมาก
| ประเภท | วิธีการทำงาน | เหมาะสำหรับ |
|---|---|---|
| ดัชนีรอง | แต่ละโหนดจะจัดทำดัชนีเฉพาะข้อมูลภายในเครื่องของตนเองเท่านั้น ดังนั้นการค้นหาข้อมูลโดยไม่มีคีย์พาร์ติชันจะต้องติดต่อทุกโหนด | คอลัมน์ที่มีจำนวนข้อมูลปานกลางจะถูกสอบถามควบคู่ไปกับคีย์พาร์ติชัน |
| ดัชนี SASI | ดัชนีที่แนบมานี้รองรับการจับคู่คำนำหน้าและคำต่อท้ายแบบ LIKE รวมถึงช่วงตัวเลขด้วย | รูปแบบการค้นหาข้อความ ยังอยู่ในช่วงทดลอง ดังนั้นควรทดสอบก่อนนำไปใช้งานจริง |
| ดัชนีที่แนบมากับอุปกรณ์จัดเก็บข้อมูล (SAI) | แนะนำใน Cassandra 5.0 ซึ่งใช้โครงสร้างดัชนีเดียวกันในทุกคอลัมน์ ส่งผลให้ค่าใช้จ่ายในการเขียนข้อมูลลดลง | สิ่งทดแทนที่ทันสมัยสำหรับทั้งสองอย่างข้างต้นบน Cassandra 5 กลุ่ม |
การสร้างดัชนีให้กับคอลัมน์ในชุดข้อมูลจะใช้ตัวดัดแปลงที่ระบุส่วนที่จะสร้างดัชนี
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
คำสั่ง VALUES ใช้ค้นหาองค์ประกอบของชุดข้อมูลหรือรายการ คำสั่ง KEYS ใช้ค้นหาคีย์ของแผนที่ และคำสั่ง ENTRIES ใช้จับคู่คีย์และค่าเข้าด้วยกัน การจัดทำดัชนีคอลเลกชันจะกล่าวถึงเพิ่มเติมในหัวข้อถัดไป Cassandra คอลเลกชัน เกี่ยวกับการสอน
เมื่อใดที่ไม่ควรใช้ดัชนีใน Cassandra
ดัชนีรองนั้นสะดวกก็จริง แต่ไม่ใช่ดัชนีเชิงสัมพันธ์ และการใช้ดัชนีรองในตำแหน่งที่ไม่เหมาะสมมักเป็นสาเหตุที่ทำให้คลัสเตอร์ทำงานช้า มีสี่สถานการณ์ที่ต้องใช้วิธีการที่แตกต่างออกไป
- จำนวนสมาชิกที่สูงมาก การสร้างดัชนีให้กับสิ่งที่เกือบจะเป็นเอกลักษณ์ เช่น ที่อยู่อีเมล หมายความว่าเกือบทุกพาร์ติชันจะมีแถวที่ตรงกันอย่างน้อยหนึ่งแถว ดังนั้นการค้นหาจึงกระจายไปทั่วทั้งคลัสเตอร์เพื่อส่งคืนระเบียนเดียว
- จำนวนสมาชิกน้อยมาก การสร้างดัชนีสำหรับแฟล็กสองค่า เช่น ใช้งานอยู่หรือไม่ใช้งาน จะทำให้เกิดพาร์ติชันดัชนีขนาดใหญ่มาก และการอ่านพาร์ติชันหนึ่งจะส่งคืนข้อมูลครึ่งหนึ่งของตาราง
- คอลัมน์เหล่านี้มีการอัปเดตบ่อยครั้ง ทุกครั้งที่มีการเปลี่ยนแปลง ระบบจะสร้างรายการในดัชนีและสร้างหลุมฝังศพสำหรับรายการเก่า ซึ่งจะทำให้การสะสมของหลุมฝังศพส่งผลเสียต่อการอ่านข้อมูลเมื่อเวลาผ่านไป
- แบบสอบถามที่ไม่มีคีย์พาร์ติชัน หากไม่มีตัวประสานงาน ผู้ประสานงานจะต้องติดต่อทุกโหนดและรวมผลลัพธ์เข้าด้วยกัน ซึ่งวิธีการนี้ไม่สามารถรองรับการขยายตัวเมื่อมีการเพิ่มโหนดมากขึ้น
ทางเลือกที่ยั่งยืนกว่าคือการสร้างตารางที่สองโดยใช้คอลัมน์ที่ต้องการค้นหาเป็นคีย์หลัก ซึ่งเขียนขึ้นพร้อมกับตารางแรก วิธีนี้เป็นไปตามหลักการ "ค้นหาก่อน" ที่อธิบายไว้ใน Cassandra กฎแบบจำลองข้อมูลและมันจะจำกัดการอ่านข้อมูลทั้งหมดไว้ในพาร์ติชันเดียวบนโหนดเดียวเท่านั้น
โดยทั่วไปแล้ว ดัชนีเหมาะสำหรับคอลัมน์ที่มีจำนวนข้อมูลปานกลางและถูกเรียกใช้ร่วมกับคีย์พาร์ติชันที่ทราบแล้ว หากข้อมูลไม่ตรงกับคำอธิบายนี้ ควรใช้ตารางที่สร้างขึ้นมาโดยเฉพาะจะเหมาะสมกว่า
