
10 bästa GRATIS webbscrapingping Verktyg (2026)
 Redaktionellt team
Upplysningar: Guru99 är läsarstödda. Vi kan få provision när du köper via länkar på den här sidan. Läs mer
Webbskrapningping Verktyg kan spara timmar, men fel val returnerar ofta ofullständiga poster, utlöser IP-blockeringar, slösar bort krediter, döljer viktiga gränser och lämnar nybörjare bakom förvirrande dashboards. Instabila väljare eller inkonsekvent rendering kan också orsaka att rapporter slutar fungera utan förvarning. Läsare jämför ofta rubriker samtidigt som de missar kostnader för förfrågningar. JavaSkriptstöd, datalagring och efterlevnadskontroller. En tydligare granskning synliggör dessa avvägningar, hjälper till att matcha varje arbetsflöde med rätt tjänst och förvandlar en osäker slutlista till ett hanterbart nästa steg.
Jag spenderade över 55 timmar på att undersöka över 18 verktyg, kontrollera officiella produktsidor, åtkomstbegränsningar, arbetsflöden och återkommande recensionsmönster. Min djupgående research valde ut de 10 bästa gratis webbskräpprogramvarorna.ping Verktygsalternativ med funktioner, för- och nackdelar, och information om aktuella abonnemang. Guiden skiljer permanenta gratisabonnemang från provpoäng och betalda tester, så att du kan fortsätta med tydligare förväntningar. Läs mer ...
Oxylabs är en marknadsledande plattform för insamling av webbintelligens. Det drivs av de högsta affärs-, etik- och efterlevnadsstandarder, vilket gör det möjligt för företag över hela världen att låsa upp datadrivna insikter. Den erbjuder en mekanism för automatiskt återförsök som hjälper till att hantera och kringgå IP-block.
Bästa GRATIS webbscrapingping Programvara och verktyg
| Namn | bäst för | VIKTIGA FUNKTIONER | Enkel användning | Pröva På | Länk |
|---|---|---|---|---|---|
👍 Oxylabs |
Storskalig dataexempeltraction | Hög framgångsfrekvens, Geo-targeting, Structured Data | Moderate | Obegränsat | Läs mer |
 👍 Decodo |
Avancerad dataskrapningping Lösningar | IP-rotation, Hög framgångsfrekvens, Proxyhantering | Easy | 7-dagars gratis provperiod | Läs mer |
 👍 NodeMaven |
Premium proxy-scraping för bostäder och mobila enheterping | IP-kvalitetsfilter, 7 dagars fasta sessioner, 190+ länder | Easy | 750 MB för 3.50 dollar | Läs mer |
 Webshare |
Prisvärt proxynätverk för scraping | 80 miljoner+ IP-adresser, geografisk inriktning, IP-rotation | Easy | 10 gratis fullmakter | Läs mer |
 Apify |
Utvecklare och automationsentusiaster | Avancerad dataexempeltraction, API-anrop | Moderate | Livstids gratis grundplan | Läs mer |
1) Oxylabs
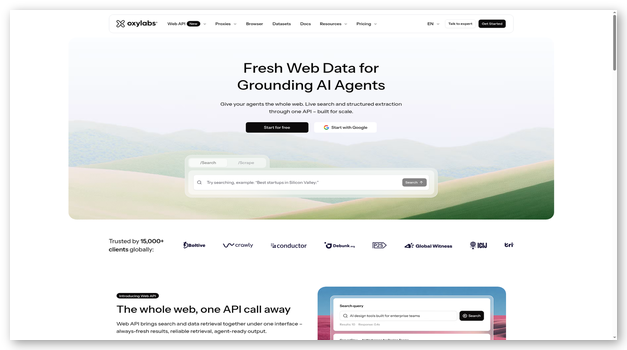
Oxylabs tillhandahåller en hanterad webb Scraper API för team som samlar in offentlig data från svåra webbplatser. Det hanterar proxy-routing, webbläsarrendering, återförsök och strukturerad leverans bakom ett API. Detaljhandelsövervakningsteam kan begära lokaliserade produktsidor utan att underhålla separata webbläsarflottor.
Dess instrumentpanel fokuserar på användning, förfrågningar och parserkontroller. Batchfrågor och schemaläggning stöder återkommande jobb, medan OxyCopilot hjälper till att generera förfrågningar. Tjänsten passar produktionsarbetsbelastningar bättre än tillfälliga engångsprojekt, särskilt när förutsägbar leverans är viktigare än att äga scrapen.ping infrastruktur i stor skala.
Funktioner:
- Hanterade förfrågningar: API:et dirigerar förfrågningar genom lämplig infrastruktur och försöker igen blockerade försök. Team får användbara svar utan att behöva underhålla stora proxylistor eller webbläsararbetare.
- Huvudlös webbläsare: Läser in webbläsarrendering JavaSidor med många manus före extraction. Detta stöder dynamiska produktlistor, interaktiva resesidor och annat innehåll som saknas i rå HTML.
- Anpassad parser: Anpassade parsningsregler konverterar stödda sidor till strukturerade fält. Analytiker lägger mindre tid på att rensa uppmärkning innan de laddar resultat till databaser eller rapporter.
- Batchfrågor: Gruppinlämning grupperar många mål URLs i ett arbetsflöde. Det minskar orkestreringsarbetet när team övervakar priser, lager, sökresultat eller listningar.
- Schemaläggare: Schemalagda jobb kör återkommande samlingar med definierade intervall. Detta hjälper team att uppdatera datauppsättningar utan att behöva förlita sig på en separat cron-tjänst för varje projekt.
- Geografisk inriktning: Platsparametrar begär sidor från utvalda marknader. Forskare kan jämföra regionala priser, tillgänglighet eller sökresultat via samma API-integration.
- Användningskontroller: Instrumentpanelen visar resultatförbrukning och förfrågningsaktivitet. Team kan track volym innan gränserna blir en överraskning under en produktionsinsamlingskörning.
Fördelar
Nackdelar
👉 Hur man får Oxylabs gratis?
- Öppna Oxylabs web Scraper API-prissida.
- Skapa ett konto och välj den kostnadsfria provperioden utan att lägga till ett kort.
- Testet inkluderar upp till 2 000 resultat för stödda scraping arbetsflöden.
Gratis provperiod med upp till 2 000 resultat
2) Decodo
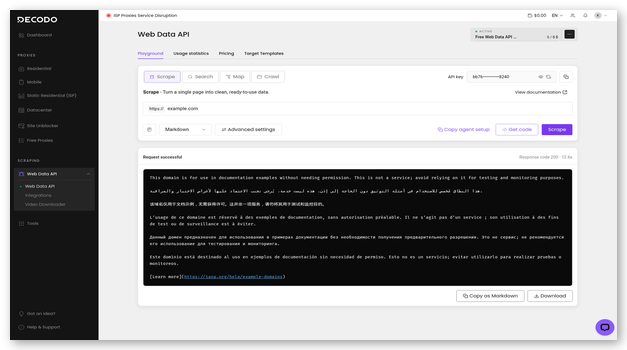
Decodo kombinerar proxyinfrastruktur med en webbscraperping API byggt för utvecklare, analytiker och AI-arbetsflöden. Dess slutpunkter för skrapning, sökning, mappning och genomsökning täcker enskilda sidor genom flersidig identifiering. Förberedda mallar returnerar strukturerad data för vanliga mål utan att kräva en anpassad parser.
Instrumentpanelen visar API-nycklar, inställningar för förfrågningar, användning och utdataalternativ. JavaSkriptrendering och hanterat proxyval hanterar svårare sidor, medan Markdown-utdata stöder språkmodellpipelines. En permanent gratisplan gör Decodo praktisk för prototyper innan team på ett tillförlitligt sätt förbinder sig till högre förfrågningsvolymer.
Funktioner:
- Fyra slutpunkter: Skrapnings-, sök-, kart- och genomsökningsslutpunkter täcker fokuserade exempeltraction och webbplatsidentifiering. Utvecklare kan hålla flera datauppgifter bakom en API-nyckel.
- Förberedda mallar: Mer än 100 underhållna mallar riktar sig mot vanliga webbplatser och datatyper. De minskar arbetet med att välja och snabbar upp tidiga konceptförberedelser.
- JavaSkriptrendering: Valfri rendering laddar dynamiskt innehåll före leverans. Team kan samla in data från klientrenderade sidor utan att behöva använda sitt eget headless webbläsarkluster.
- Flexibel utgång: Svaren kan innehålla HTML, Markdown, JSON, CSV, PNG eller XHR-data där det stöds. Varje arbetsflöde kan välja ett analysklart format.
- Proxyhantering: Inbyggt proxyval och anti-bot-kontroller minskar manuell rotation. Förfrågningar kan nå geokänsliga sidor medan API:et hanterar infrastrukturbeslut.
- AI-kopplingar: MCP och andra integrationsvägar överför aktuell webbdata till AI-verktyg som stöds. Detta passar forskningsagenter och arbetsflöden för insamling som behöver live-källor.
- Begärankontroller: Hastighetsgränser och total användning visas med varje plan. Team kan dimensionera ett projekt kring crawlvolym istället för att gissa enbart utifrån bandbredd.
Fördelar
Nackdelar
👉 Hur får man Decodo gratis?
- Besök Decodos webbscraperping API-prissida.
- Skapa det kostnadsfria kontot och kopiera de genererade API-inloggningsuppgifterna.
- Gratisplanen täcker 5 000 genomsökningar eller 10 000 skrapade sidor varje månad.
Gratisplan med upp till 10 000 sidor
3) NodeMaven
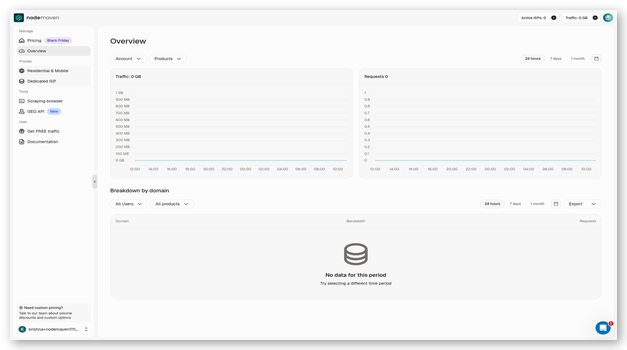
NodeMaven är en proxyplattform för scraping lag som redan äger extractionkod eller webbläsarautomation. Alternativ för bostäder, mobiler och internetleverantörer stöder HTTP- och SOCKS5-anslutningar över bred geografisk täckning. Dess IP-kvalitetsfilter granskar adresser före tilldelning för att minska undvikbara fel.
Instrumentpanelen fokuserar på trafik, inloggningsuppgifter, målgruppsinriktning och rotationsinställningar snarare än analyserade datamängder. Klibbiga sessioner passar konto- eller platskontinuitet, medan rotation per begäran passar breda crawls. NodeMaven fungerar bäst när proxykvalitet och sessionskontroll är viktigare än en färdig scrap.ping API.
Funktioner:
- Kvalitetsfilter: IP-kvalitetsfiltret granskar tillgängliga adresser före tilldelning. Renare pooler kan minska slöseri med återförsök och CA.PTCHA-avbrott under långa insamlingskörningar.
- Proxytyper: Bostads-, mobil- och internetleverantörsproxyservrar samlas under ett och samma konto. Team kan matcha rykte, stabilitet och kostnad för varje scrap.ping mål.
- Rotationskontroller: Anslutningar kan rotera mellan förfrågningar eller förbli fastlåsta under längre sessioner. Detta stöder både stora crawlningar och arbetsflöden som kräver en konsekvent identitet.
- Geografisk inriktning: Land, stad och internetleverantör begränsar utgångsplatsen. Forskare kan samla in lokaliserade priser, annonser, sökresultat eller tillgänglighetsdata.
- Protokollstöd: Stöd för HTTP och SOCKS5 fungerar med vanliga skript och automatiseringsverktyg. Befintliga crawlers kan ansluta utan att ändra sitt ex.tractionslogik.
- Trafikövergång: Outnyttjad trafik kan flyttas till nästa faktureringsperiod enligt nuvarande planer. Detta hjälper projekt med ojämna månatliga inkassoscheman att bevara köpt kapacitet.
- Användningspanel: Trafik- och anslutningsinformation visas i kontots instrumentpanel. Team kan övervaka förbrukning och justera rotationen innan en genomsökning förbrukar sin tillåtna kapacitet.
Fördelar
Nackdelar
👉 Hur får man NodeMaven gratis?
- Öppna NodeMavens prissida och skapa ett konto.
- Välj testversionen för proxyåtkomst för bostäder och mobila enheter.
- Den betalda provperioden kostar 3.50 dollar och inkluderar 750 MB bandbredd.
750 MB provperiod för 3.50 USD
4) Webshare
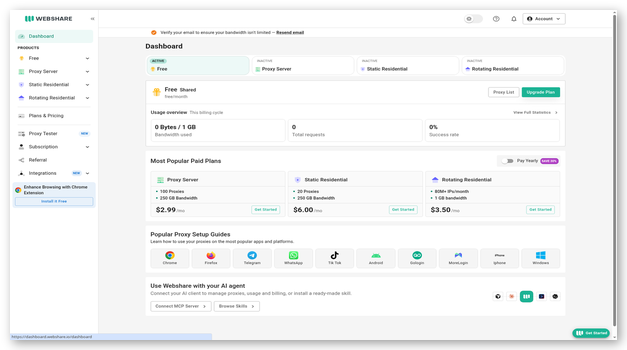
Webshare Tillhandahåller proxyanslutningar för datacenter, bostäder och internetleverantörer för skript, crawlers och webbläsarautomation. Dess permanenta gratisplan ger små projekt tio datacenterproxyservrar och en månatlig bandbreddstilldelning. Användare kan autentisera sig via inloggningsuppgifter eller godkända IP-adresser.
Instrumentpanelen presenterar proxylistor, anslutningsinformation, användning och API-åtkomst på ett ställe. Rotationskontroller hjälper till att distribuera förfrågningar, medan platsfilter stöder regional insamling. Webshare passar för elever och lätta jobb som behöver pålitlig proxyåtkomst, även om det inte ersätter en parser eller fullständig scraping.ping arbetsflöde.
Funktioner:
- Gratis proxyservrar: Det permanenta gratisabonnemanget inkluderar tio datacenterproxyservrar och 1 GB månatlig trafik. Små experiment kan fortsätta utan att en provperiod löper ut.
- Proxy-val: Betalda alternativ täcker datacenter-, bostads- och internetanslutningar. Team kan välja en pool baserat på målsvårighetsgrad, stabilitet och budget.
- Rotation: Roterande slutpunkter ändrar adresser automatiskt för de planer som stöds. Detta minskar manuellt underhåll av proxylistor över större eller ofta upprepade förfrågningsuppsättningar.
- Geografiska kontroller: Platsfilter hjälper till att dirigera förfrågningar genom relevanta länder eller regioner. Marknadsundersökare kan jämföra lokaliserat innehåll med samma anslutningsarbetsflöde.
- API-åtkomst: API:et exponerar proxyinformation och kontoåtgärder för automatisering. Utvecklare kan etablera eller hämta anslutningar utan att kopiera listor från instrumentpanelen.
- Authentication: Användarnamnsuppgifter och IP-auktorisering stöder olika distributionsmönster. Team kan säkra åtkomst för servrar, bärbara datorer eller distribuerade scrap-filer.ping arbetare.
- Användning trackung: Instrumentpanelens mätvärden visar bandbredd och proxyaktivitet. Användare kan upptäcka närmande gränser innan en crawler stannar under en viktig insamlingskörning.
Fördelar
Nackdelar
👉 Hur man får Webshare gratis?
- Öppet Webshare och registrera ett gratis konto utan kort.
- Besök proxylistan för att hämta de tilldelade anslutningsuppgifterna.
- Gratisplanen inkluderar tio datacenterproxyservrar och 1 GB månadsvis.
10 gratis proxyservrar och 1 GB per månad
5) Apify
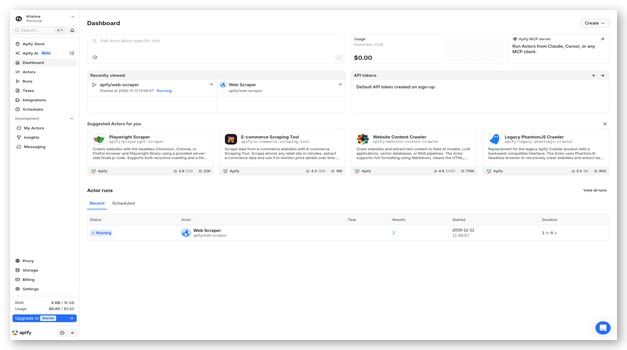
Apify är en molnplattform för att köra återanvändbara scrapers som kallas Actors. Dess publika Store täcker vanliga webbplatser, medan utvecklare kan bygga anpassade Actors med Crawlee eller andra verktyg som stöds. Scheman, dataset, köer och webhooks förvandlar enskilda körningar till repeterbara dataarbetsflöden.
Konsolen visar indata, körloggar, lagring, kostnader och utdata för varje aktör. Team kan exportera poster eller koppla dem via API:et. Apify erbjuder bred flexibilitet, även om marknadsplatsens kvalitet och användningskostnader varierar. Den passar användare som vill ha både förberedda skrapor och en programmerbar automationsplattform.
Funktioner:
- Skådespelarebutik: Butiken erbjuder färdiga scrapers för många vanliga webbplatser och uppgifter. Användare kan börja med en befintlig aktör istället för att koda varje samlare.
- Anpassade skådespelare: Utvecklare kan paketera sina egna scraping logik som återanvändbara aktörer. Versionsbaserade indata och byggen gör det enklare att köra samma arbetsflöde upprepade gånger.
- schemaläggning: Inbyggda scheman startar aktörer vid valda tidpunkter eller intervall. Återkommande pris-, listnings- eller innehållsövervakning kan köras utan en extern schemaläggare.
- Datalagring: Datauppsättningar, nyckel-värdeslagrar och förfrågningsköer organiserar utdata och crawlningsstatus. Varje körning håller sina poster tillgängliga för export eller nedströmsbearbetning.
- Integrations: API:er, webhooks och kopplingar skickar resultat till andra system. Team kan utlösa uppföljningsjobb efter att en körning lyckats eller misslyckats.
- Proxyalternativ: Proxytjänster för datacenter och bostäder finns tillgängliga inom plattformen. Aktörer kan rotera anslutningar utan en separat hanterad proxyleverantör.
- Körövervakning: Loggar, status, beräkningsanvändning och kostnader visas för varje körning. Utvecklare kan diagnostisera fel och uppskatta hur mycket resurser ett återkommande jobb förbrukar.
Fördelar
Nackdelar
👉 Hur man får Apify gratis?
- Besök Apifys prissida och välj Gratis-planen.
- Skapa ett konto utan att ange betalkortsinformation.
- Planen förnyas med 5 USD i månadskredit och fem samtidiga körningar.
5 USD i gratis kredit per månad
6) Novada
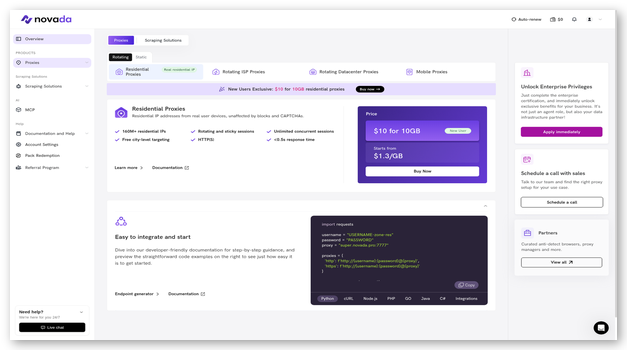
Novada grupper a Scraper API, Web Unblocker och Browser API under ett och samma kreditsaldo. Scraper API:et returnerar strukturerade poster för stödda mål, medan webbläsar-API:et hanterar interaktiva JavaSkripta sidor genom välbekanta automatiseringsprotokoll. Hanterade anti-bot-kontroller minskar infrastrukturarbetet.
Dess instrumentpanel tracks produktförbrukning, domäner, krediter och samtidiga förfrågningar. Enhetlig fakturering låter team byta metod utan separata prenumerationer. Novada är användbart för blandade extracbehov, men åtkomst till provperioden kräver kampanjdelning och supportgodkännande. Köpta krediter upphör också att gälla efter den angivna giltighetsperioden.
Funktioner:
- Scraper API: Ocuco-landskapet Scraper API:et returnerar rensad data för stödda sök-, handels- och sociala mål. Team kan hoppa över en stor del av HTML-parsningsfasen.
- Web Unblocker: Web Unblocker returnerar råa sidor samtidigt som den hanterar vanliga åtkomsthinder. Det passar team som vill behålla sin egen parsningslogik.
- Webbläsar-API: Molnwebbläsare stöder kopplingar i Puppeteer- och Playwright-stil. Utvecklare kan rendera sidor, klicka på element, skrolla och fånga komplext interaktivt innehåll.
- Enhetliga krediter: En balans täcker skrapanping, avblockering och webbläsarprodukter. Team kan ändra metoder utan att köpa en separat ersättning för varje tjänst.
- Lyckad fakturering: Novada debiterar krediter när förfrågningar returnerar data enligt sina publicerade regler. Misslyckade plattformsförfrågningar förbrukar inte samma saldo.
- Strukturerad utdata: Mallar som stöds tillhandahåller JSON- eller CSV-poster istället för rå markup. Analytiker kan ladda resultaten till rapporter med mindre rensning.
- Samtidighetskontroller: Plannivåer definierar kapacitet för parallella förfrågningar för varje produkt. Team kan välja en tillåtelse som matchar crawlervolym och förväntade svarstider.
Fördelar
Nackdelar
👉 Hur man får Novaja gratis?
- Skapa en Novada-kontot och öppna dess sida för gratis provperiod.
- Dela kampanjen med tre grupper och skicka sedan skärmdumpar till supporten.
- Efter godkännande, Novada lägger till 15 dollar i kredit för proxyservrar och scrabbservrarping verktyg.
15 USD i provkredit
7) Bright Data
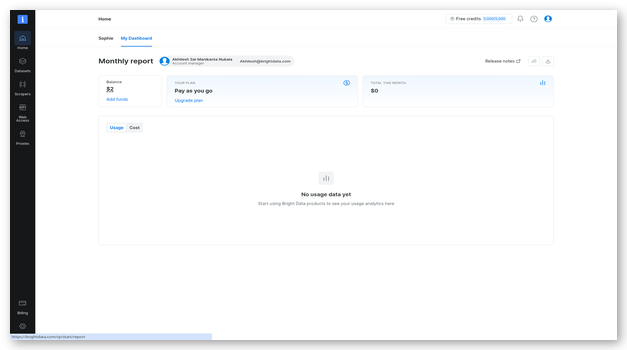
Bright Data erbjuder färdiga webbsidor Scraper API:er, en Scraping Webbläsare, Scraper Studio, proxyservrar och dataset. Team kan välja strukturerade poster eller styra en fjärrwebbläsare med Playwright och Puppeteer. Inbyggd åtkomsthantering hanterar rotation, webbläsarfingeravtryck och åtkomstutmaningar.
Kontrollpanelen separerar produkter, inloggningsuppgifter, användning, insamlare och leveransinställningar. Förbyggda API:er minskar underhållet på stödda mål, medan webbläsaråtkomst hanterar anpassade interaktioner. Bright Data passar krävande projekt med bred täckning och supportbehov. Dess stora produktkatalog och företagsalternativ kan kännas överdrivna för enkla personliga skrapping.
Funktioner:
- Scraper API: Förbyggda API:er returnerar strukturerade poster för webbplatser och kategorier som stöds. Team undviker att underhålla väljare och webbläsarlogik för varje måländring.
- Ärrping Webbläsare: En webbläsare som är värdbaserad ansluter via Playwright eller Puppeteer. Utvecklare kan köra JavaSkript och automatisera interaktioner medan Bright Data hanterar åtkomstinfrastruktur.
- Scraper Studio: Studioverktyg hjälper till att bygga och driftsätta anpassade samlare. Visuella och AI-assisterade alternativ minskar installationstiden för mål utan ett förberett API.
- Proxynätverk: Integrerade proxytjänster täcker flera anslutningstyper och platser. Arbetsflöden kan dirigera trafik utan att flytta inloggningsuppgifter mellan flera separata leverantörer.
- Leveransalternativ: Insamlad data kan flyttas via API:er, webhooks eller molndestinationer som stöds. Team kan mata befintliga lager och analyspipelines efter varje körning.
- Utgiftskontroller: Betala per användning-alternativ och månadsgränser hjälper till att hantera förbrukningen. Användningsvyer på instrumentpanelen visar hur en insamlare påverkar projektbudgeten.
- Gratis skivor: Webben Scraper Den kostnadsfria API-nivån inkluderar 5 000 poster varje månad. Inget betalkort krävs för att starta den publicerade nivån.
Fördelar
Nackdelar
👉 Hur man får Bright Data gratis?
- Öppet Bright Datas webb Scraper API-prissida.
- Välj Starta gratis och registrera dig utan att ange ett betalkort.
- Gratisnivån inkluderar 5 000 webb Scraper API-poster varje månad.
5 000 gratis poster varje månad
8) PrivateProxy
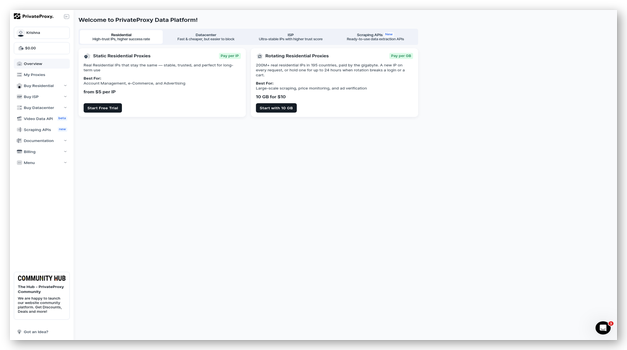
PrivateProxy tillhandahåller statiska och roterande proxypaket för skript och webbläsarautomation. Statiska testversioner för bostäder och datacenter låter användare testa en adress innan de binder sig, medan betalda roterande abonnemang täcker begärandebaserad eller bandbreddsbaserad trafik. Anslutningar stöder vanliga autentiseringsmönster.
Kontoområdet fokuserar på paket, platser, inloggningsuppgifter, användning och prenumerationsstatus. Dedikerade statiska alternativ passar jobb som behöver en enhetlig adress, medan roterande tjänster passar bredare crawlningar. PrivateProxy är en infrastrukturkomponent snarare än en komplett skrapa, så team måste leverera extractionslogik, återförsök, lagring och datavalidering.
Funktioner:
- Statiska proxyservrar: Statiska datacenter- och internetleverantörsalternativ behåller en adress under prenumerationsperioden. De passar sessioner som kräver kontinuitet eller åtkomst på tillåtelselista.
- Roterande åtkomst: Roterande paket ändrar adresser mellan förfrågningar eller sessioner. Detta kan distribuera crawlertrafik utan att underhålla en separat lokal proxylista.
- Valmöjligheter för provperioder: Utvalda statiska paket inkluderar en tvådagars gratis provperiod med kortverifiering. Roterande provkörningspaket debiterar istället ett introduktionspris för första cykeln.
- Authentication: Användarnamnsinloggning och IP-baserad auktorisering stöder vanliga serverdistributioner. Team kan välja den metod som bäst passar deras crawlermiljö.
- Val av plats: Tillgängliga paket erbjuder regionala val vid beställning. Användare kan matcha en proxyplats med marknaden eller webbplatsen som studeras.
- Prenumerationskontroller: Instrumentpanelen visar aktiva paket och förnyelsestatus. Testanvändare kan avbryta prenumerationen före förnyelse för att undvika den angivna månadsavgiften.
- Protokollstöd: HTTP-, HTTPS- och SOCKS-anslutningar täcker många scrapersping bibliotek och webbläsare. Befintliga verktyg kan ansluta utan en leverantörsspecifik extraction SDK.
Fördelar
Nackdelar
👉 Hur man får PrivateProxy gratis?
- Öppet PrivateProxys hjälpsida och välj en kvalificerad statisk testperiod.
- Välj platsinformation och lägg till ett kort för verifiering.
- Den kostnadsfria provperioden varar i två dagar och förnyas om den inte avbryts omedelbart.
2-dagars gratis försök
9) ScraperAPI
ScraperAPI ger utvecklare en enda slutpunkt för att hämta sidor via hanterade proxypooler. Den hanterar adressrotation, automatiska återförsök och CA.PTCHA, geotargeting och valfritt JavaSkriptrendering. Strukturerade slutpunkter täcker utvalda handels- och sökmål, medan async API stöder större förfrågningsbatchar.
Instrumentpanelen visar API-inloggningsuppgifter, kreditanvändning, samtidighet och förfrågningsanalys. DataPipeline lägger till schemaläggning och leverans utan en separat crawlertjänst. ScraperAPI passar team som redan vet vilka sidor de ska begära men vill undvika proxyoperationer. Kreditkostnaderna varierar beroende på mål och aktiverade funktioner.
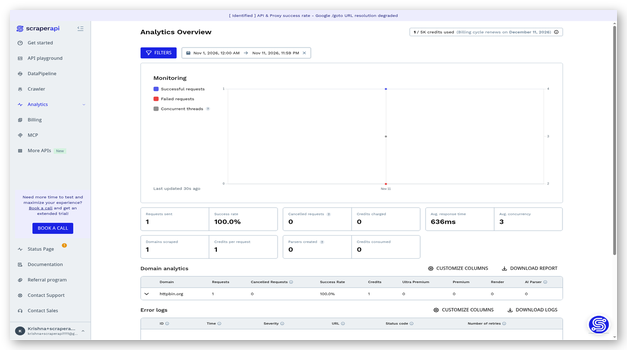
Funktioner:
- Enskild slutpunkt: En standard API-förfrågan skickar målet URL och autentiseringsnyckel. ScraperAPI hanterar proxyval och returnerar det resulterande sidsvaret.
- Automatiska återförsök: Misslyckade eller blockerade försök kan göras om via andra anslutningar. Detta minskar behovet av anpassad återförsökslogik i uppringarens register.ping ansökan.
- JavaSkriptrendering: Valfri rendering laddar innehåll på klientsidan innan ett svar returneras. Dynamiska produktsidor och applikationsgränssnitt blir tillgängliga via samma API.
- Strukturerad data: Dedikerade slutpunkter returnerar analyserade poster för stödda mål. Team kan undvika att underhålla selektorer för vanliga produkt-, sök- och listningssidor.
- DataPipeline: DataPipeline schemalägger samlingar och levererar färdiga filer till stödda destinationer. Analytiker kan hantera återkommande jobb utan att bygga ett fullständigt orkestreringslager.
- Kostnadsberäknare: Instrumentpanelsverktyg uppskattar kreditförbrukning för en URL och parameteruppsättning. Detta hjälper team att jämföra kostnader för rendering, premiumproxy och kringgåning.
- Gratis traktamente: Det publicerade gratisabonnemanget inkluderar 1 000 API-krediter och fem samtidiga anslutningar. Användare kan testa standardförfrågningar innan de väljer ett betalt abonnemang.
Fördelar
Nackdelar
👉 Hur man får ScraperAPI gratis?
- Besök ScraperAPIs prissida och skapa ett gratis konto.
- Kopiera API-nyckeln och testa en standardförfrågan.
- Gratisplanen inkluderar 1 000 krediter och fem samtidiga anslutningar varje månad.
1,000 XNUMX gratis krediter varje månad
10) ScrapingBee
ScrapingBee är ett API för att samla in sidor som kräver webbläsare, proxyservrar eller platskontroller. JavaSkriptrendering laddar interaktivt innehåll, medan klassiska, premium- och stealth-anslutningar hanterar olika svårighetsgrader för mål. Skärmdumps- och sök-API:er utökar samma konto bortom HTML-hämtning.
Instrumentpanelen innehåller en API-nyckel, en förfrågningsverktyg, en kredituppskattning och användningshistorik. Utvecklare kan lägga till anpassade rubriker eller JavaSkriptscenarier för klick och scrollning. AI extraction accepterar fältinstruktioner i enkelt språk. ScrapingBee är lättillgängligt för API-användare, även om aktiverade alternativ kan ändra kreditkostnaden kraftigt.
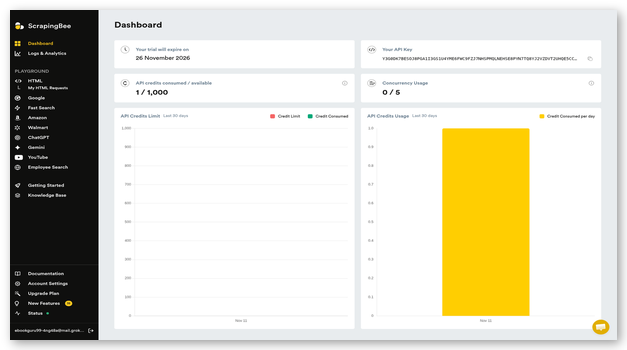
Funktioner:
- HTML-API: HTML API:et returnerar renderat eller orenderat sidinnehåll via en enda slutpunkt. Utvecklare kontrollerar proxynivå, plats, rubriker och webbläsarens beteende.
- JS-scenarier: Custom JavaSkriptscenarier kan klicka, rulla, vänta eller interagera innan inspelning. Detta stöder sidor där innehållet bara visas efter användaråtgärder.
- Proxynivåer: Klassiska, premium- och stealth-rutter hanterar olika blockeringsnivåer. Team kan börja med lägre kostnad och endast eskalera vid behov.
- AI-extraction: Frågor i enkelt språk och exempeltracRegler identifierar begärda fält. Detta minskar arbetet med att välja när team behöver ett snabbt strukturerat resultat från att byta sidor.
- Skärmdump API: Skärmdumpsförfrågningar tar hela sidor eller utvalda element. Övervakningsteam kan lagra visuella bevis tillsammans med exempel.tracted-värden och ändringsposter.
- Begäran om byggare: Instrumentpanelsbyggaren genererar kod och visar beräknad kreditkostnad. Utvecklare kan verifiera parametrar innan de lägger till dem i en applikation.
- Gratis krediter: Varje nytt konto får 1 000 API-krediter utan betalkort. Krediten stöder utvärdering men förnyas inte som en tidsbegränsad provperiod.
Fördelar
Nackdelar
👉 Hur man får ScrapingBee gratis?
- Öppet ScrapingBee och registrera ett nytt konto utan kort.
- Använd instrumentpanelens begärandebyggare för att generera ett testanrop.
- Varje nytt konto får 1 000 gratis API-krediter för utvärdering.
1 000 gratis registreringskrediter
Funktionsjämförelsetabell för de bästa webbscrapsping Verktyg
Hur valde vi den bästa gratis webbscrapingtjänsten?ping Verktyg?

At Guru99, vi har åtagit oss att tillhandahålla korrekt, relevant och objektiv information för att hjälpa användare att fatta välgrundade beslut. Vår redaktionella process fokuserar på att leverera informativa och pålitliga resurser, vilket säkerställer att innehållet är både trovärdigt och pålitligt. Efter recenserar över 18 av de bästa webbskräpping verktyg, inklusive gratis och betalda alternativ, har vi sammanställt ett omfattande urval baserat på deras funktioner, fördelar, nackdelar och prissättning. Den här guiden säkerställer en detaljerad förståelse av varje verktyg, och hjälper dig att välja det bästa för dina behov. Vi fokuserar på följande faktorer när vi granskar ett verktyg baserat på funktionalitet, användarvänlighet och mångsidighet.
- Användarvänlighet: Vi valde verktyg baserat på deras användarvänliga gränssnitt, så att nybörjare och experter kan skrapa data smidigt.
- Effektivitet: Experterna i vårt team prioriterade verktyg som var optimerade för effektivitet, vilket säkerställde snabb och korrekt dataöversikttraction utan kompromisser.
- Säkerhet: Vi såg till att lista verktyg med starka säkerhetsfunktioner för att skydda känslig data och upprätthålla integritet.
- anpassnings~~POS=TRUNC: Vi valde verktyg baserat på deras förmåga att hantera olika webbplatser och exempeltracdata i olika format med lätthet.
- Community Support: Vårt team övervägde verktyg med aktiva gemenskaper och pålitlig kundsupport för att lösa problem effektivt.
- Flexibilitet: Vi valde verktyg som möjliggör anpassning, vilket säkerställer att de möter de specifika behoven hos olika användare och projekt.
Vad är en webbscrapeping verktyg, och hur fungerar det?
En webbskräpping verktyget begär en webbsida, läser dess innehåll och extrackonverterar valda fält till ett strukturerat format. Vissa verktyg analyserar HTML direkt. Andra kör en webbläsare så JavaSkriptet kan laddas först. Hanterade API:er roterar även proxyservrar, försöker om blockerade förfrågningar och returnerar resultat via en slutpunkt. Arbetsflödet börjar vanligtvis med en URL och extracregel. Den slutar med poster i JSON, CSV eller en databas. Nybörjare bör först bestämma om de behöver sidor, strukturerade fält, skärmdumpar eller upprepad övervakning. Det valet avgör rätt verktygstyp.
Vilken modell för fri åtkomst passar din webbdesign?ping projekt?
Fri åtkomst kan innebära en permanent månatlig ersättning, engångskrediter för registrering, en tidsbegränsad provperiod eller en betald utvärdering. Dessa modeller är inte utbytbara. En förnybar plan passar små återkommande jobb. Engångskrediter fungerar bättre för att testa en integration. Tidsbegränsade provperioder hjälper till att utvärdera support och svåra mål snabbt. Betalda provperioder ger ofta proxytrafik av högre kvalitet än en gratisnivå. Kontrollera om ett kort krävs, vad som förbrukar krediter och om oanvänd kapacitet löper ut. Det bästa alternativet matchar din förfrågningsfrekvens, målsvårighetsgrad och tolerans för senare ombyggnad.
Vilka funktioner bör du leta efter vid webbscrapingping verktyg?
Användbara funktioner beror på jobbet, så börja med målet och den önskade produktionen. Dessa kontroller täcker de viktigaste köpbesluten:
- Rendering: JavaSkriptstöd är viktigt när de nödvändiga uppgifterna visas efter det första HTML-svaret.
- Åtkomstkontroll: Proxyrotation, sessioner och platsinriktning avgör om förfrågningar når regionala eller skyddade sidor.
- Produktion: JSON, CSV, Markdown, skärmdumpar och rå HTML tjänar olika analys- och bevisbehov.
- Operationer: Schemaläggning, återförsök, loggar, aviseringar och utgiftsgränser gör att återkommande jobb kan observeras och kontrolleras.
- Support: Tydlig dokumentation och responsivitet hjälper till att minska driftstopp när mål eller förfrågningsregler ändras.
Hur scrapar man?ping Jämför API:er med proxyservrar och webbläsarverktyg?
Ärrping API:er hanterar förfrågningar, återförsök och ofta rendering bakom en enda slutpunkt. De passar team som vill ha resultat utan att ha en nätverksinfrastruktur i drift. Proxytjänster dirigerar bara trafik, så användare behöver fortfarande crawlers, parsers, lagring och felhantering. Webbläsarverktyg körs. JavaSkripta och simulera åtgärder som att klicka eller skrolla. De hanterar interaktiva sidor men förbrukar mer datorresurser. Många produktionssystem kombinerar dessa metoder. En proxy kan stödja en anpassad crawler, medan en hanterad webbläsare hanterar svåra sidor. Välj den minst komplexa metoden som tillförlitligt returnerar den information som krävs.
Hur kan AI förbättra webbskräpping arbetsflöden?
AI kan översätta fältförfrågningar på ett enkelt språk till exempeltracregler, normalisera röriga värden och producera renare JSON eller Markdown. Det kan också hjälpa till att reparera selektorer när sidlayouter ändras. Dessa funktioner minskar installationstiden, särskilt för prototyper och forskning. De tar inte bort behovet av validering. Modeller kan felmärka fält, missa dold paginering eller slå samman orelaterade värden. Team bör jämföra exempel mot källsidan och övervaka förändringar över tid. AI fungerar bäst som en assistent kring kontrollerade förfrågningar, tydliga scheman och repeterbara kvalitetskontroller.
Hur gör man webbscraping?ping verktyg kopplas till dataarbetsflöden?
Webbskrapningping Verktyg ansluter vanligtvis via REST API:er, SDK:er, webhooks, molnlagring eller automatiseringsplattformar. Ett schemalagt jobb kan samla in sidor, spara poster i en datauppsättning och skicka en slutförd webhook. En annan tjänst kan sedan validera, transformera eller ladda data till ett lager. AI-arbetsflöden använder i allt högre grad MCP- eller Markdown-utdata för att leverera aktuella sidor till forskningsagenter. Integrationen bör också innehålla körningsstatus, tidsstämplar och fel. Utan den kontexten kan nedströmssystem inte skilja nya poster från ofullständiga eller misslyckade samlingar.
Är webbskräpping lagligt och säkert?
Webbskrapningping kan vara lagligt, men lagligheten beror på data, åtkomstmetod, jurisdiktion och avsedd användning. Ett ansvarsfullt projekt bör dokumentera dessa kontroller:
- Allmänhetens tillgång: Samla endast in information som är lagligt tillgänglig och relevant för ett definierat affärs- eller forskningssyfte.
- Webbplatsregler: RevVisa användarvillkor, robotvägledning, contracfaktiska gränser och tillämpliga lokala lagar innan data samlas in.
- Personlig information: Minimera insamling, säkra bevarade register och följ sekretessskyldigheter för identifierbar information.
- Begär laddning: Använd rimliga priser och cachning så att automatiserad trafik inte stör målwebbplatsen.
- Juridisk granskning: Sök kvalificerad rådgivning när projektet involverar känsliga uppgifter, konton, autentisering eller oklara begränsningar.
Hur kan du skydda webbskräpping datakvalitet?
Datakvalitet börjar med ett tydligt schema och representativa testsidor. Validera fälttyper, obligatoriska värden, paginering, dubbletter och tidsstämplar innan skalning. Spara ett litet rått svarsexempel bredvid analyserade poster så att fel kvarstår. tracmöjlig. Övervaka antal poster och antalet saknade fält över körningar. Layoutändringar skapar ofta rimliga men felaktiga utdata, vilket är svårare att upptäcka än en misslyckad begäran. Version extracregler och jämför stickprov efter varje ändring. För viktiga datamängder, lägg till oberoende kontroller mot betrodda källsidor innan du publicerar slutsatser.
Hur gör man webbscraping?ping Kostnaderna förändras i takt med att projekten skalas upp?
Kostnaderna ökar genom förfrågningsvolym, renderade sidor, premiumproxyservrar, samtidighet, lagring och support. URL kan förbruka flera krediter när JavaSkript, platsinriktning eller avancerad kringgåning är aktiverad. Misslyckade försök kan vara gratis med vissa API:er men fakturerbara med andra. Beräkna kostnaden från ett representativt urval, inte ett enkelt antal förfrågningar. Inkludera ingenjörstid för underhåll och övervakning av parser. Ett hanterat API kan kosta mer per resultat men ändå minska driftsarbetet. Sätt utgiftsgränser, granska användning per mål och separera experiment från produktionsuppgifter.
Vilka problem orsakar webben Scrapers att misslyckas, och hur kan de åtgärdas?
Scrapermisslyckas vanligtvis på grund av sidans beteende, åtkomstregler eller ex.tracantaganden ändrades. Varje korrigering bör åtgärda den observerade orsaken snarare än att försöka igen i blindo.
- Problem: En sida returnerar tom HTML eftersom innehållet laddas igenom JavaManus efter det första svaret.
Lösning: Operatören bör aktivera webbläsarrendering och vänta på en stabil väljare innan extracfylla i de begärda fälten. - Problem: Upprepade förfrågningar utlöser CAPTCHA:er, hastighetsgränser eller tillfälliga blockeringar under större inkassoomgångar.
Lösning: Teamet bör sänka förfrågningshastigheten, rotera lämpliga proxyservrar, återanvända sessioner noggrant och följa webbplatsens åtkomstregler. - Problem: En omdesignad sida flyttar fält och producerar tyst tomma eller felaktiga värden.
Lösning: Underhållaren bör använda versionsväljare, behålla råa exempel och avisera när ifyllnaden av obligatoriska fält sjunker under ett överenskommet tröskelvärde. - Problem: Paginering stoppas tidigt, vilket lämnar senare produkter, kommentarer eller listningar utanför den slutliga datamängden.
Lösning: Utvecklaren bör testa nästa-sida-logiken, registrera sidantal och jämföra insamlade totalsummor med synliga källindikatorer. - Problem: Kreditförbrukningen ökar oväntat när rendering, premiumrutter eller svåra mål är aktiverade.
Lösning: Ägaren bör först uppskatta representativa förfrågningar, sätta utgiftsgränser och separera dyra mål i övervakade arbetsflöden. - Problem: duplicera URLs eller omförsök skapar upprepade poster som förvränger antal och nedströmsanalys.
Lösning: Pipelinen bör tilldela stabila postnycklar, normalisera URLs, och deduplicera innan poster registreras i rapporter eller lagras.
Vilka trender kommer att forma webbskräpping verktyg härnäst?
Webbskrapningping plattformar går mot AI-styrda extraction, agentanslutningar och mer flexibel webbläsarinfrastruktur. Schema i enkelt språk kan förkorta installationstiden, medan MCP-integrationer låter researchagenter begära aktuella sidor via kontrollerade verktyg. Leverantörer kombinerar också scrapping, sökning, crawlning och webbläsaråtgärder bakom delade konton. Efterlevnad och datahärledning kommer att få mer uppmärksamhet i takt med att automatiserad insamling styr affärsbeslut. Den användbara trenden är större observerbarhet: team behöver tydliga förfrågningskostnader, källtidsstämplar, t.ex.tracversioner och orsaker till fel. Bättre automatisering bör göra dessa kontroller enklare, inte dölja dem.
Slutsats
Jag granskade kortlistan mot åtkomstbegränsningar, arbetsflödesdjup och skalningskrav. Tre alternativ erbjöd den tydligaste passformen för olika scrabb.ping behov.
- Oxylabs: Jag föredrog dess hanterade webb Scraper API för svåra mål, strukturerad leverans och produktionskontroller utan att underhålla separat webbläsar- och proxyinfrastruktur.
- Decodo: Min recension satte den först för tillgänglig gratis API-åtkomst, förberedda mallar, JavaSkriptrendering och utdata anpassade till data- eller AI-arbetsflöden.
- NodeMaven: Jag valde det för lag som redan äger scraping kod och behöver detaljerad platsinriktning, rotationskontroller och granskade proxyadresser.
