
SQL Server Architecture (förklarad)
 Redaktionellt team
⚡ Smart sammanfattning
SQL Server ArchiTecture följer en klient-server-modell organiserad i tre kärnlager: Protokolllager för nätverkskommunikation, Relationsmotor för frågebehandling och Storage Engine för datahantering och hämtning.
MS SQL Server är en klient-server-arkitektur. MS SQL Server-processen börjar med att klientapplikationen skickar en begäran. SQL Server accepterar, bearbetar och svarar på begäran med bearbetade data. Låt oss diskutera i detalj hela arkitekturen som visas nedan:
Som diagrammet nedan visar finns det tre huvudkomponenter i SQL Server Architecture:
- Protokolllager
- Relationsmotor
- Förvaringsmotor
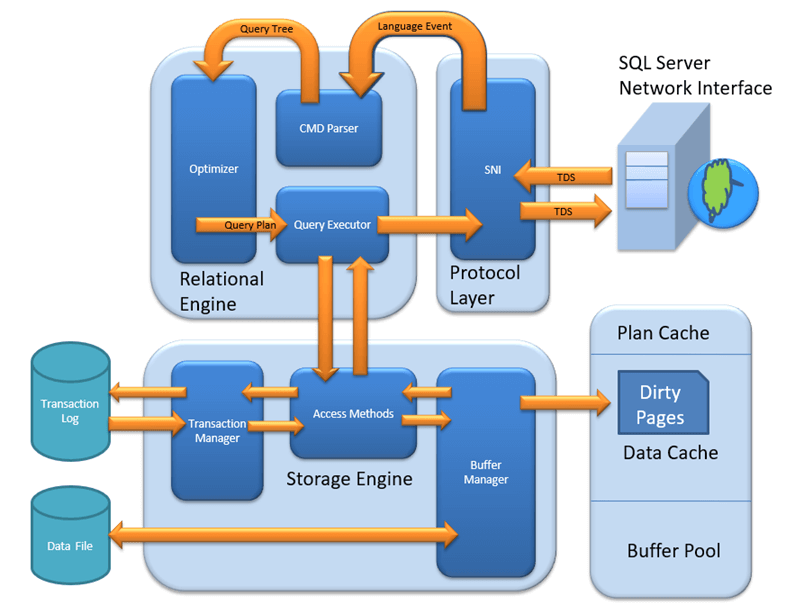
Protokolllager – SNI
SQL Server Protocol Layer, även känt som Server Network Interface (SNI), stöder tre typer av klient-server-arkitekturer. Varje protokoll hanterar ett annat nätverksscenario. Det är viktigt att förstå dessa protokoll innan man utforskar hur frågor bearbetas internt.
Delat minne
Tänk dig ett tidigt morgonsamtal. Tom och hans mamma är på samma logiska plats, deras hem. Tom ber om kaffe och mamma serverar det direkt. På liknande sätt tillhandahåller SQL Server protokollet Shared Memory när klienten och servern körs på samma maskin. Båda kommunicerar via delat minne utan någon nätverksoverhead.

Analogi: Tom mappar till klienten, mamma mappar till SQL Server, Home mappar till maskinen och verbal kommunikation mappar till protokollet för delat minne.

Konfigurationsanteckningar: In SQL Management Studio, kan alternativet ”Servernamn” för en lokal anslutning vara ”.”, ”localhost”, ”127.0.0.1” eller ”Maskin\Instans”.
TCP / IP-
Tänk dig nu att Tom vill ha kaffe från en butik som ligger 10 km bort. Tom är hemma och kaféet ligger på en livlig marknadsplats. De kommunicerar via ett mobilnät. På liknande sätt tillhandahåller SQL Server TCP / IP-protokoll när klienten och SQL Server finns på separata maskiner som är anslutna via ett nätverk.

Analogi: Tom mappas till klienten, kaféet mappas till SQL Server, hem- och marknadsplatsen mappas till fjärrplatser och mobilnätet mappas till TCP/IP-protokollet.

Konfigurationsanteckningar: I SQL Management Studio måste alternativet "Servernamn" för en TCP/IP-anslutning vara "Maskin\Instans av servern". SQL Server använder port 1433 som standard för TCP/IP-anslutningar.

Namngivna rör
Slutligen vill Tom ha grönt te från sin granne Sierra. De befinner sig på samma fysiska plats, är grannar, och kommunicerar via ett intranätverk. På liknande sätt tillhandahåller SQL Server protokollet Named Pipe när klienten och servern är anslutna via ett lokalt nätverk (LAN).

Analogi: Tom mappas till klienten, Sierra mappas till SQL Server, being neighbors mappas till LAN och intranätet mappas till Named Pipe-protokollet.
Konfigurationsanteckningar: Namngivna piper är inaktiverat som standard och måste aktiveras via SQL Configuration Manager.
Vad är TDS?
Nu när de tre typerna av klient-server-arkitektur är tydliga, här är en titt på TDS:
- TDS står för Tabular Data Stream.
- Alla tre protokollen använder TDS-paket.
- TDS är inkapslat i nätverkspaket, vilket möjliggör dataöverföring från klientmaskinen till servermaskinen.
- TDS utvecklades först av Sybase och ägs nu av Microsoft.
Följande tabell jämför de tre SQL Server-anslutningsprotokollen:
| Leverans | Delat minne | TCP / IP- | Namngivna rör |
|---|---|---|---|
| Nätverksomfattning | Samma maskin | Fjärrstyrning (WAN/Internet) | Endast LAN |
| Standardport | - | 1433 | 445 |
| Prestanda | Snabbast (ingen nätverksoverhead) | Bra (optimerad för WAN) | Bra (optimerad för LAN) |
| Aktiverad som standard | Ja | Ja | Nej |
| Bästa användningsfallet | Lokal utveckling och testning | Fjärråtkomst till produktion | Tillförlitliga LAN-miljöer |
Med protokollskiktet som hanterar nätverkskommunikation är nästa steg i SQL Server-arkitekturen att bearbeta själva frågan. Det är här relationsmotorn tar över.
Relationsmotor
Relationsmotorn är även känd som frågeprocessorn. Den innehåller SQL Server-komponenterna som avgör vad en fråga behöver göra och hur den kan köras mest effektivt. Den ansvarar för att köra användarfrågor genom att begära data från lagringsmotorn och bearbeta de returnerade resultaten.
Som visas i arkitekturdiagrammet finns det tre huvudkomponenter i relationsmotorn:
CMD Parser
Data som tas emot från protokolllagret skickas till relationsmotorn. CMD-parsern är den första komponenten som tar emot frågedata. Dess huvudsakliga uppgift är att kontrollera frågan för syntaktiska och semantiska fel och sedan generera ett frågeträd.

Syntaktisk kontroll: Precis som alla andra programmeringsspråk har SQL Server en fördefinierad uppsättning nyckelord och grammatikregler. SELECT, INSERT, UPDATE och många andra tillhör den fördefinierade nyckelordslistan. CMD-parsern verifierar att inmatningen följer dessa regler. Om användarens inmatning avviker från den förväntade syntaxen returnerar parsern ett fel.
Exempel: Tänk dig en ryss som går in på en japansk restaurang och beställer på ryska. Servitören förstår bara japanska och kan inte behandla beställningen. På samma sätt, om en användare skriver "SELECR" istället för "SELECT", returnerar CMD-parsern ett felmeddelande eftersom den inte känner igen nyckelordet.
Semantisk kontroll: Detta utförs av normaliseraren. Den kontrollerar om kolumnnamnen, tabellnamnen och andra objekt som efterfrågas faktiskt finns i schemat. Om de finns binder normaliseraren dem till frågan. Denna process kallas även bindning. När användarfrågor innehåller en VIEW ersätter normaliseraren den med den internt lagrade vydefinitionen.
Exempel: Springa SELECT * from USER_ID skulle orsaka att parsern utlöser ett fel under den semantiska kontrollen om tabellen USER_ID inte finns i databasen.
Skapa frågeträd: Det här steget genererar olika exekveringsträd som representerar de olika sätt en fråga kan köras på. Alla träd producerar samma önskade utdata.
Optimizer
Optimeraren skapar en exekveringsplan för användarens fråga. Denna plan avgör hur frågan ska exekveras. Alla frågor är inte optimerade. Optimering gäller för DML-kommandon (Data Modification Language) som SELECT, INSERT, DELETE och UPDATE. DDL-kommandon som CREATE och ALTER är inte optimerade utan kompileras till ett internt formulär.

Frågekostnaden beräknas baserat på faktorer som CPU-användning, minnesanvändning och in-/utdatabehov. Optimerarens roll är att hitta den billigaste kostnadseffektiva exekveringsplanen, inte nödvändigtvis den absolut bästa.
Exempel: Tänk dig att du vill öppna ett onlinebankkonto. En bank tar maximalt 2 dagar. Du har också en lista med 20 andra banker som kanske tar kortare tid eller inte. Att söka i alla 20 banker kanske inte hittar ett snabbare alternativ, och själva sökningen kostar tid. Det hade varit bättre att välja den första banken. På liknande sätt använder SQL Optimizer uttömmande och heuristiska algoritmer för att minimera körtiden för frågor.
Optimeraren söker i tre faser:
Fas 0: Sök efter Trivialplan
Detta är föroptimeringsstadiet. För vissa frågor finns det bara en praktisk plan, en så kallad trivialplan. Det finns ingen anledning att söka vidare eftersom ytterligare sökningar skulle ge samma exekveringsplan en extra kostnad.
Fas 1: Sök efter transaktionsbehandlingsplaner
Detta inkluderar sökning efter både enkla och komplexa planer. Den enkla plansökningen använder statistisk analys av kolumn- och indexdata, vanligtvis begränsad till ett index per tabell. Om ingen enkel plan hittas utförs en mer komplex sökning som involverar flera index per tabell.
Fas 2: Parallell bearbetning och optimering
Om de tidigare strategierna inte producerar en adekvat plan söker optimeraren efter parallella bearbetningsmöjligheter baserat på maskinens bearbetningskapacitet. Om parallell bearbetning inte är möjlig påbörjas en sista optimeringsfas som använder alla återstående alternativ för att hitta den bästa möjliga exekveringsplanen.
Frågeexekutor
Query Executor anropar Access-metoden i Storage Engine. Den tillhandahåller en exekveringsplan som innehåller den datahämtningslogik som krävs för exekvering. När data har mottagits från Storage Engine publiceras resultatet till protokollskiktet och skickas till slutanvändaren.

Efter att relationsmotorn har bestämt hur en fråga ska köras, hanterar lagringsmotorn de fysiska dataoperationerna. Detta lager hanterar hur data lagras, cachas och hämtas från disken.
Förvaringsmotor
Storage Engine ansvarar för att lagra data i ett lagringssystem som en disk eller ett SAN och hämta den vid behov. Innan vi undersöker Storage Engine-komponenterna är det viktigt att förstå hur data lagras fysiskt.

Datafiler och omfattningar
Datafiler lagrar fysiskt data i form av datasidor, där varje sida är 8 KB stor. Detta är den minsta lagringsenheten i SQL ServerDatasidor är logiskt grupperade i extensions. Inget objekt tilldelas en enskild sida direkt; istället sker underhåll via extensions. Varje sida har en sidrubrik (96 byte) som innehåller metadata som sidtyp, sidnummer, använt utrymme, ledigt utrymme och pekare till nästa och föregående sida.
Filtyper

Primär fil: Varje databas innehåller en primärfil. Den lagrar all viktig data relaterad till tabeller, vyer, triggers och andra objekt. Filtillägget är vanligtvis .mdf men kan vara vilket filtillägg som helst.
Sekundär fil: En databas kan innehålla flera sekundära filer, men behöver inte innehålla dem. Dessa är valfria och innehåller användarspecifik data. Filtillägget är vanligtvis .ndf men kan ha vilket filtillägg som helst.
Loggfil: Även känd som förhandsskrivna loggar. Filtillägget är .ldf. Loggfiler används för transaktionshantering, återställning från oönskade instanser och återställning av obekräftade transaktioner.
Lagringsmotorn har tre huvudkomponenter. Var och en spelar en specifik roll i hanteringen av dataåtkomst och integritet.
Åtkomstmetod
Access-metoden fungerar som ett gränssnitt mellan Query Executor och Buffer Manager eller Transaktionsloggar. Den utför inte själva exekveringen utan bestämmer typen av fråga:
- Om frågan är en SELECT-sats (DML), den skickas vidare till Buffer Chef för vidare bearbetning.
- Om frågan är en Icke-SELECT-sats (DDL och DML), skickas den till transaktionshanteraren. Detta inkluderar främst UPDATE-, INSERT- och DELETE-satser.

Buffer chef
Ocuco-landskapet Buffer Manager hanterar kärnfunktioner för plancache, dataparsning och hantering av dirty page.

Planera cache
Befintlig frågeplan: Ocuco-landskapet Buffer Manager kontrollerar om exekveringsplanen finns i den lagrade plancachen. Om den gör det används den cachade frågeplanen och dess tillhörande datacache direkt.
Förstagångs cacheplan: Om en förstagångsförfrågningsplan är komplex lagras den i plancachen. Detta säkerställer snabbare tillgänglighet nästa gång SQL Server tar emot samma fråga.
Dataanalys: Buffer Cache och datalagring
Ocuco-landskapet Buffer Manager ger åtkomst till nödvändiga data. Två tillvägagångssätt är möjliga beroende på om data finns i cachen:
Buffer Cache – Mjuk parsning
Ocuco-landskapet Buffer Chefen letar efter data i Buffer Cache. Om data finns använder Query Executor den direkt. Detta förbättrar prestandan eftersom hämtning av data från cachen kräver färre I/O-operationer jämfört med hämtning från disklagring.

Datalagring – hård parsning
Om data inte finns i Buffer Cache, den erforderliga datan söks i datalagring på disk. Datan lagras sedan också i datacachen för framtida bruk.

Transaktionsansvarig
Transaktionshanteraren anropas när åtkomstmetoden fastställer att en fråga är en icke-SELECT-sats. Den säkerställer datakonsistens och hållbarhet genom flera delkomponenter:

Logghanterare
Logghanteraren sparar track av alla uppdateringar som utförs i systemet via loggar som lagras i transaktionsloggar. Varje loggpost innehåller ett loggsekvensnummer tillsammans med transaktions-ID och datamodifieringspost. Denna mekanism tracks bekräftade och återställda transaktioner.
Låshanterare
Under en transaktion försätts den associerade datan i lagringen i ett låst tillstånd. Låshanteraren hanterar denna process och säkerställer datakonsistens och isolering. Dessa egenskaper kallas även ACID (Atomicity, konsistens, isolering, hållbarhet).
Utförandeprocess
Exekveringsprocessen följer dessa steg:
- Logghanteraren börjar logga och Låshanteraren låser tillhörande data.
- En kopia av uppgifterna sparas i Buffer cache.
- En kopia av data som ska uppdateras sparas i loggen Buffer, och alla händelser uppdaterar data i Data Buffer.
- Sidor som lagrar ändrad data kallas Smutsiga sidor.
Kontrollpunkts- och förhandsloggning
Kontrollpunktsprocessen körs ungefär en gång per minut och markerar alla smutsiga sidor för skrivning till disk. Sidan skickas dock först till loggfilens datasida från Buffer Logg. Denna mekanism kallas för förhandsloggning. De smutsiga sidorna finns kvar i cachen även efter att de har skrivits till disken.
lat Writer
När SQL Server observerar en hög belastning och buffertminne behövs för nya transaktioner, frigör den smutsiga sidor från cachen. Writer använder LRU-algoritmen (Minst Nyligen Använda) för att rensa sidor från buffertpoolen till disken.
Hur SQL Server bearbetar en fråga från början till slut
Det är värdefullt att förstå varje lager individuellt, men att se hur de fungerar tillsammans förtydligar helhetsbilden. När en klientapplikation skickar en SQL-fråga sker följande sekvens:
Ocuco-landskapet Protokolllager tar emot begäran via delat minne, TCP/IP eller namngivna rör och slår in den i ett TDS-paket. Relationsmotor sedan tar över: CMD-parsern kontrollerar syntax och semantik, optimeraren genererar den billigaste exekveringsplanen och frågeexekutorn börjar datahämtning.
Frågeexekutorn anropar Lagringsmotorns Åtkomstmetod, som dirigerar SELECT-frågor till Buffer Manager och modifieringsfrågor till Transaktionshanteraren. Buffer Chefen kontrollerar plancachen och Buffer Cache först (mjuk parsning). Om data inte cachas utförs en diskläsning (hård parsning). För skrivåtgärder koordinerar Transaktionshanteraren Log Manager, Lock Manager och kontrollpunktsprocessen för att säkerställa ACID-efterlevnad.
När lagringsmotorn returnerar den begärda informationen formaterar relationsmotorn resultatuppsättningen och protokolllagret levererar den tillbaka till klientapplikationen via samma TDS-protokoll.
Hur man väljer rätt protokoll för SQL Server-anslutningar
Att välja rätt protokoll beror på det fysiska förhållandet mellan klienten och servern, såväl som prestandakrav.
Använd delat minne när klientapplikationen körs på samma maskin som SQL Server. Detta är det snabbaste alternativet eftersom det eliminerar all nätverksoverhead. Det är idealiskt för lokal utveckling, testning och distributioner på en enda maskin.
Använd TCP/IP när klienten och servern är på olika maskiner anslutna via ett WAN eller internet. Detta är det vanligaste protokollet i produktionsmiljöer. SQL Server lyssnar på port 1433 som standard, och detta protokoll stöder krypterade anslutningar via TLS.
Använd namngivna pipes när klienten och servern är på samma betrodda LAN och prestanda på interna nätverk är en prioritet. Named Pipes är inaktiverat som standard och måste aktiveras via SQL Server Configuration Manager. Det är mindre vanligt i moderna distributioner men är fortfarande användbart för äldre intranätapplikationer.
