
SAP HANA Analytic View: Hur man skapar och använder
 Mason Garcia
⚡ Smart sammanfattning
SAP HANA Analytic View modellerar data som ett stjärnschema och ansluter till en central faktatabell för att attributa vyer så att transaktionsdata kan aggregeras direkt för flerdimensionell analys inuti. SAP HANA Studio.
Vad är en analytisk vy i SAP HANA?
En analytisk synvinkel i SAP HANA är baserat på stjärnschemamodellering och representerar ett OLAP-, eller flerdimensionellt, modelleringsobjekt. Det bildar en kubliknande struktur som används för att analysera data, och det passar alla scenarier där aggregerade data från de underliggande tabellerna behövs.
I en analytisk vy kopplas dimensionstabeller till faktatabellen som innehåller transaktionsdata. En dimensionstabell innehåller beskrivande data såsom produkt, produktnamn, leverantör eller kund. En faktatabell innehåller beskrivande data tillsammans med mätbara data såsom belopp och moms.
Eftersom aggregeringen sker i minnet vid frågetillfället behöver inga aggregerade tabeller lagras. Vyn definieras en gång i SAP HANA-modellering och återanvänds av varje rapport som läser den.
Exempel på SAP HANA analytisk vy
Här skapas en analytisk vy för en inköpsorder, baserad på attributvy ”AT_PRODUCT” skapades tidigare. Tabellerna Inköpsorderrubrik och Inköpsorderdetaljer tillhandahåller transaktionsdata.
Kör båda skripten nedan i SQL konsol av SAP HANA Studio innan modelleringsstegen börjar.
SQL-skript för att skapa tabellen “PURCHASE_ORDER” i “DHK_SCHEMA”
CREATE COLUMN TABLE "DHK_SCHEMA"."PURCHASE_ORDER"
(
PO_NUMBER NVARCHAR(10) primary key,
COMPANY NVARCHAR (4),
PO_CATEGORY NVARCHAR(2),
PRODUCT_ID NVARCHAR(10),
VENDOR NVARCHAR(10),
TERMS NVARCHAR(4),
PUR_ORG NVARCHAR(4),
PUR_GRP NVARCHAR(3),
CURRENCY NVARCHAR(5),
QUOTATION_NO NVARCHAR(10),
PO_STATUS VARCHAR(1),
CREATED_BY NVARCHAR(20),
CREATED_AT DATE
);

INSERT	INTO "DHK_SCHEMA"."PURCHASE_ORDER" VALUES(1000001,1000,'MM','A0001','V000001','CASH' ,1000,'GR1','INR',1000011,'A','HANAUSER','2016-01-07');
INSERT INTO "DHK_SCHEMA"."PURCHASE_ORDER" VALUES(1000002,2000,'MM','A0002','V000001','CASH',1000,'GR1','INR',1000012,'A','HANAUSER','2016-01-06');
INSERT INTO "DHK_SCHEMA"."PURCHASE_ORDER" VALUES(1000003,2000,'MM','A0003','V000001','CASH',1000,'GR1','INR',1000013,'A','HANAUSER','2016-01-07');
INSERT INTO "DHK_SCHEMA"."PURCHASE_ORDER" VALUES(1000004,2000,'MM','A0004','V000001','CASH',1000,'GR1','INR',1000014,'A','HANAUSER','2016-01-07');
SQL-skript för att skapa tabellen “PURCHASE_DETAIL” i “DHK_SCHEMA”
CREATE	 COLUMN TABLE "DHK_SCHEMA"."PURCHASE_DETAIL"
(
PO_NUMBER NVARCHAR(10) primary key,
COMPANY NVARCHAR(4),
PO_CATEGORY NVARCHAR(2),
PRODUCT_ID NVARCHAR(10),
PLANT NVARCHAR(4),
STORAGE_LOC NVARCHAR(4),
VENDOR NVARCHAR(10),
TERMS NVARCHAR(4),
PUR_ORG NVARCHAR(4),
PUR_GRP NVARCHAR(3),
CURRENCY NVARCHAR(5),
QUANTITY SMALLINT,
QUANTITY_UNIT VARCHAR(4),
ORDER_PRICE DECIMAL(8,2),
NET_AMOUNT DECIMAL(8,2),
GROSS_AMOUNT DECIMAL(8,2),
TAX_AMOUNT DECIMAL(8,2)
);


INSERT	INTO "DHK_SCHEMA"."PURCHASE_DETAIL"	VALUES(1000001,1000,'MM','A0001',1001,101,
'V000001','CASH',1000,'GR1','INR',10,'UNIT',50000.00,40000.00,50000.00,10000.00);
INSERT	INTO "DHK_SCHEMA"."PURCHASE_DETAIL"	VALUES(1000002,2000,'MM','A0002',1002,102,
'V000002','CASH',1000,'GR1','INR',10,'UNIT',60000.00,48000.00,60000.00,12000.00);
INSERT	INTO "DHK_SCHEMA"."PURCHASE_DETAIL"	VALUES(1000003,2000,'MM','A0003',1003,103,
'V000001','CASH',1000,'GR1','INR',20,'UNIT',40000.00,32000.00,40000.00,8000.00);
INSERT	INTO "DHK_SCHEMA"."PURCHASE_DETAIL"	VALUES(1000004,2000,'MM','A0004',1004,104,
'V000002','CASH',1000,'GR1','INR',20,'UNIT',20000.00,16000.00,20000.00,4000.00);
De två skripten skapar tabellerna ”PURCHASE_ORDER” och ”PURCHASE_DETAIL” tillsammans med deras data.
Hur man skapar en analytisk vy i SAP HANA
En analytisk vy med namnet ”AN_PURCHASE_ORDERS” skapas nedan från attributvyn ”AT_PRODUCT” och tabellerna ”PURCHASE_ORDER” och ”PURCHASE_DETAIL”. De tio stegen följer ordningen på redigeringsskärmarna.
Steg 1) Skapa en ny analysvy från paketträdet som visas nedan.
- Välj underpaketet Modellering under DHK_SCHEMA-paketet.
- Högerklicka och välj Nytt.
- Välj alternativet Analytisk vy.

Steg 2) Informationsvyredigeraren öppnas för den analytiska vyn. Slutför skapandedialogrutan som visas nedan.
- Ange namnet på den analytiska vyn "AN_PURCHASE_ORDERS" och en etikett för den.
- Välj vytypen "Analytisk vy".

När inmatningarna är klara klickar du på knappen Slutför. Informationsvyredigeraren visas sedan för den analytiska vyn.
Steg 3) Lägg till tabellerna från schemat till datafältet Foundation nod under scenariofönstret. Scenariofönstern innehåller tre noder.
- Semantik: Denna nod representerar vyns utdatastruktur.
- Stjärnanslutning: Den här noden skapar kopplingen som kopplar attributvyerna till faktatabellen.
- Data Foundation: Den här noden innehåller faktatabellerna för den analytiska vyn. Flera tabeller kan läggas till, men mått kan bara väljas från en av dem.
Dra och släpp tabellerna "PURCHASE_ORDER" och "PURCHASE_DETAIL" från DHK_SCHEMA till datafältet. Foundation nod, som visas nedan.

Steg 4) Lägg till attributvyn till Star Join-noden.
- Välj attributvyn ”AT_PRODUCT” från modelleringspaketet.
- Dra och släpp attributvyn till Star Join-noden, som visas nedan.

Steg 5) I samma fönster arbetar du i detaljpanelen enligt anvisningarna.
- Klicka på Data Foundation nod. Tabellerna som läggs till visas i detaljavsnittet.
- Koppla tabellen ”PURCHASE_ORDER” till tabellen ”PURCHASE_DETAIL” i fältet ”PO_NUMBER”.
- Ange kopplingstyp och kardinaliteten.
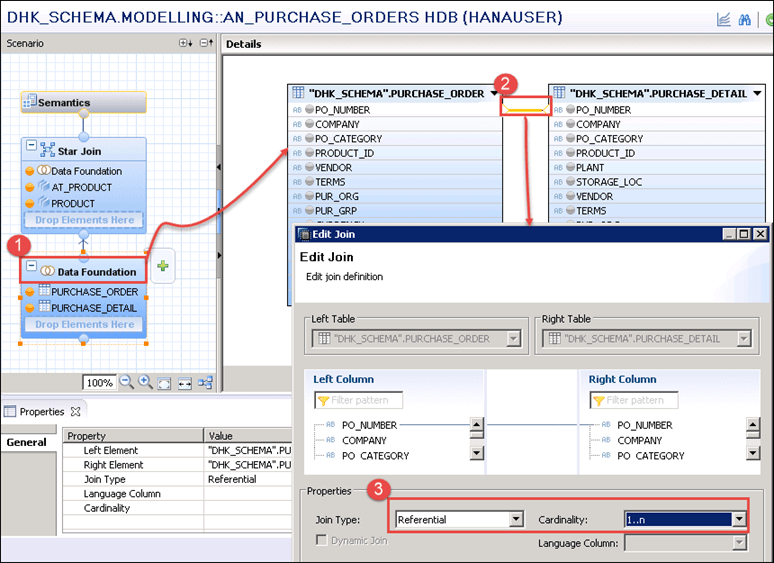
Klicka på OK-knappen för att behålla kopplingen.
Steg 6) Markera följande kolumner i samma fönster.
- Välj PO_NUMBER, COMPANY, PO_CATEGORY, PRODUCT_ID, PLANT och STORAGE_LOC från tabellen ”PURCHASE_DETAIL”.
- Välj kolumnen VALUTA från tabellen ”KÖPSDETALJ”.
- Välj GROSS_AMOUNT och SKATTEBELOPP.
- Välj kolumnerna PO_STATUS, CREATED_BY och CREATED_AT från tabellen ”PURCHASE_ORDER”, som är inköpsorderrubriken.

Varje vald kolumn, markerad med orange, visas i utdata från den analytiska vyn.
Steg 7) Koppla attributvyn till faktatabellen i datagrunden. Klicka på noden Star Join i scenariofönstret, som visas nedan.

Attributvyn och faktatabellen visas i detaljfönstret. Koppla attributvyn till databasen i kolumnen "PRODUCT_ID", som visas nedan.

Klicka på länken för att ansluta. Ett popup-fönster för Redigera koppling visas, där kopplingstypen är definierad som "Referensiell" och kardinaliteten som 1…1.

Klicka på OK-knappen för att bekräfta stjärnkopplingen.
Steg 8) Definiera attributen, måtten och nyckeln för vyn. Välj noden Semantik i scenariofönstret, som visas nedan.

- Välj fliken Kolumner i detaljfönstret.
- Definiera kolumntypen som attribut eller mått. Varje kolumn här är ett attribut förutom "GROSS_AMOUNT", som definieras som ett mått.

Steg 9) Validera och aktivera analysvyn från verktygsfältet.
- Validera den analytiska vyn.
- Aktivera den analytiska vyn.

Den analytiska vyn "AN_PURCHASE_ORDERS" är nu skapad och aktiverad i mappen Analytic i underpaketet Modelling, som visas nedan.

Steg 10) Förhandsgranska data i den analytiska vyn.
- Gå till verktygsfältet och klicka på ikonen "Förhandsgranskning av data".
- Välj Öppna i Data Preview Editor.

Tre flikar finns tillgängliga i redigeraren för dataförhandsgranskning. Analys Tab hämtar attribut och mått genom att dra och släppa dem till etikettaxeln och värdeaxeln och visar utdata som ett diagram, en tabell, ett rutnät eller HTML, som nedan.

Ocuco-landskapet Distinkta värden Fliken visar de distinkta värdena för ett valt attribut åt gången, som nedan.

Ocuco-landskapet Rådata Fliken visar posterna i tabellformat, enligt nedan.

Obs: En analytisk vy accepterar endast attributvyer som sina dimensioner och stöder inte fackliga operator. Radnivåbegränsningar på den aktiverade vyn tillämpas via analytiska privilegier.
Attributvyer och analysvyer är föråldrade från och med SAP HANA 2.0 och är inte tillgängliga i SAP HANA Cloud, så nya kubliknande modeller byggs som grafiska beräkningsvyer av datakategorin Kub med stjärnkoppling. Stegen ovan gäller fortfarande för befintliga SAP HANA 2.0-system, och modelleringskoncepten överförs. Mer bakgrund finns i SAP HANA serien.
