
Vad är återhämtningstestning? med exempel
 Redaktionellt team
⚡ Smart sammanfattning
Återställningstester verifierar att programvara kan återgå till normal drift efter en krasch, ett nätverksavbrott eller ett hårdvarufel, genom att återställa systemet till en fungerande punkt och bearbeta transaktioner igen fram till felet.
Vad är återhämtningstestning?
Återhämtningstestning är en teknik för mjukvarutestning som verifierar programvarans förmåga att återhämta sig från fel som programvaru- eller hårdvarukrascher och nätverksfel. Syftet med återställningstestning är att avgöra om programvarudrift kan fortsätta efter en katastrof eller en integritetsförlust. Återställningstestning innebär att återställa programvaran till den punkt där integriteten var känd och att bearbeta transaktioner igen fram till felpunkten.
Inom mjukvaruutveckling är återställningstestning en typ av icke-funktionell testning — den täcker aspekter som inte är knutna till en specifik funktion eller användaråtgärd, såsom skalbarhet eller säkerhet. Den utförs av professionella testare, och tillräcklig säkerhetskopiering av data förvaras på säkra platser i förväg.
Exempel på återställningstest
Två scenarier visar tekniken i sin enklaste form. I vart och ett av dem tvingas ett fel fram avsiktligt, sedan övervakas applikationen medan den återupptas.
- Nätverksavbrott: Medan ett program tar emot data från nätverket, dra ur anslutningskabeln. Efter en stund, sätt i den igen och analysera programmets förmåga att fortsätta ta emot data från den punkt där anslutningen bröts.
- Återställning av session: Starta om systemet medan en webbläsare har ett bestämt antal sessioner öppna och kontrollera om webbläsaren återställer alla.
Illustrationen nedan visar samma idé i visuell form.
Tiden det tar att återhämta sig beror på:
- Antalet omstartpunkter
- Mängden data som lagras av applikationen
- Utbildning och färdigheter hos de personer som utför återhämtningsaktiviteter, och de verktyg som finns tillgängliga för återhämtning
När det finns flera fel bör återhämtningstestning göras på ett strukturerat sätt snarare än allt på en gång – utföras för ett segment och sedan ett annat.
Återhämtningsprocessens livscykel
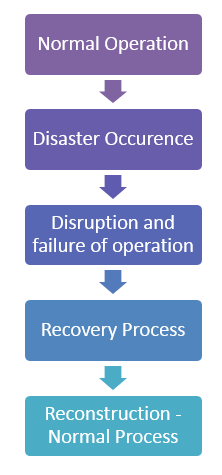
Innan man utformar testfall är det bra att se var ett återställningstest ingriper. Återställningsprocessens livscykel har fem steg:
- Normal drift
- Katastrofhändelse
- Avbrott och misslyckande i verksamheten
- Katastrofrensning genom återställningsprocessen
- Rekonstruktion av alla processer och information, vilket återställer hela systemet till normal drift
Flödesschemat nedan visar de fem stegen i ordning.
Låt oss diskutera dessa fem steg i detalj:
- Normal drift. Ett system av hårdvara, mjukvara och firmware, integrerade för att uppnå ett gemensamt mål, utför sitt avsedda jobb utan avbrott inom en viss tidsperiod.
- Katastrofhändelse. Ett avbrott kan uppstå på grund av fel i programvaran, till exempel av inmatningsinitierat fel, en krasch orsakad av hårdvarufel eller skador till följd av brand, stöld eller strejk.
- Störningar och misslyckande. Detta är den mest smärtsamma fasen, som leder till affärsförluster, brutna relationer, förlorade möjligheter, förlorade arbetstimmar och, oundvikligen, ekonomiska förluster och goodwillförluster. En katastrofåterställningsplan håller denna fas minimal.
- Katastrofhantering. Om en reservplan och riskreduceringsprocesser redan finns på plats kostar återställningen mycket mindre tid och ansträngning. Ett utsett team, där varje persons roll är definierad i förväg, fastställer ansvaret och förhindrar en lång störningsperiod.
- Rekonstruktion. Detta kan innebära flera sessioner av operationer för att återskapa alla mappar tillsammans med konfigurationsfiler. Korrekt dokumentation och en definierad rekonstruktionsprocess krävs för korrekt återställning.
Återställningsstrategi
Återställningsteamet bör ha sin egen strategi för att hämta viktig kod och data för att återställa verksamheten till det normala. Den strategin är unik för varje organisation, baserad på hur kritiska de system den hanterar är, och för kritiska system handlar det om en uppsättning val:
- En enda säkerhetskopia, eller mer än en
- Flera säkerhetskopior på ett ställe, eller på olika platser
- Online-säkerhetskopiering eller offline-säkerhetskopiering
- Säkerhetskopieringar körs automatiskt enligt en policy eller utlöses manuellt
- Ett oberoende restaureringsteam, eller utvecklingsteamet som utför arbetet
Varje val har en kostnadsfaktor, och flera säkerhetskopior kan förbruka mer fysiska resurser eller kräva ett oberoende team. Beroende spelar också roll: företag exponeras genom den kod och data de lagrar hos en enda leverantör, och en storskalig AWS Avbrott har upprepade gånger orsakat att välkända konsumenttjänster stängts av samtidigt. Oberoende återställningsförmåga är avgörande i sådana fall.
Hur man gör återställningstestning
Strategin är avgjord, nästa fråga är hur själva testet konfigureras. Följande punkter bör beaktas vid utförande av återhämtningstestning.
- Skapa en testbädd så nära faktiska driftsättningsförhållanden som möjligt: gränssnitt, protokoll, firmware, hårdvara och programvara ska matcha produktionen.
- Även om uttömmande tester kan vara tidskrävande och kostsamma, bör en identisk konfiguration och en fullständig kontroll fortfarande utföras.
- Om möjligt, testa på den hårdvara som slutligen ska återställas till – särskilt när du återställer till en annan maskin än den som skapade säkerhetskopian.
- Vissa säkerhetskopieringssystem förväntar sig att hårddisken har exakt samma storlek som den som säkerhetskopieringen togs från.
- Hantera föråldring: hårddisktekniken utvecklas snabbt, och en gammal hårddisk kanske inte är kompatibel med en ny. Återställa till en virtuell maskin hjälper, eftersom virtualiseringsprogramvara kan härma befintlig hårdvara, inklusive diskstorlekar.
- Online-backupsystem är inget undantag från testning. De flesta leverantörer skyddar användare från mediaproblem genom feltolerant lagring, så fel uppstår sent.
- Även om online-backupsystem är extremt tillförlitliga måste återställningssidan testas för att bekräfta att det inte finns några problem med hämtning, säkerhet eller kryptering.
Eftersom återhämtningsövningarna sker från början till slut är dessa löprundor vanligtvis schemalagda parallellt systemtestning snarare än på enhetsnivå.
Testprocedur efter restaurering
Att återställa data är bara halva arbetet; den återställda kopian måste fortfarande bevisas användbar. De flesta stora företag har oberoende revisorer som regelbundet genomför återställningsövningar. En omfattande katastrofåterställningsplan är dyr att underhålla och testa, så mindre organisationer förlitar sig ofta på säkerhetskopior och extern lagring istället.
När mappar och filer har återställts bekräftar följande kontroller att de har återställts korrekt:
- Byt namn på den skadade dokumentmappen så att den återställda kopian inte kan förväxlas med den.
- Räkna filerna i de återställda mapparna och matcha antalet mot den ursprungliga mappen.
- Öppna några filer med programmet som normalt använder dem och bekräfta att informationen kan bläddras och uppdateras som vanligt.
- Öppna flera filer av olika typer — bilder, MP3och dokument, en del stora och en del små.
- Använd de verktyg för fil- och katalogjämförelse som de flesta operativsystem förse.
