
T-test i R-programmering: Ett exempel och ett parat exempel
 Evelyn Clarke
⚡ Smart sammanfattning
T-test i R jämför medelvärden med hjälp av funktionen t.test(), där ett urval täcks mot ett fast mål, två oberoende grupper och parade upprepade mätningar. Denna genomgång kör varje variant, läser p-värdet korrekt och verifierar de underliggande antagandena.
Vad är statistisk slutledning?
Statistisk inferens är konsten att generera slutsatser om datafördelningen. En dataforskare ställs ofta inför frågor som bara kan besvaras vetenskapligt. Därför är statistisk inferens en strategi för att testa om en hypotes är sann, dvs. validerad av data.
En vanlig strategi för att bedöma en hypotes är t-testet, som visar om två medelvärden är lika. Det är också känt som StudenttestEtt t-test kan beräknas för:
- En enda vektor mot ett fast värde (ett-sampel t-test)
- Två vektorer från två separata grupper (oberoende två-sampel t-test)
- Två vektorer mätta på samma försökspersoner (parat t-test)
Varje t-test antar att data är slumpmässigt urvalade och att värdena (eller, för ett parat test, skillnaderna) kommer från en approximativt normalfördelad population. Den oberoende versionen med två urval antar dessutom att de två grupperna är oberoende av varandra, och den klassiska formen antar att deras varianser är lika.
Vad är T-Test i R-programmering?
Grundidén bakom ett T-test är att använda statistik för att utvärdera två motsatta hypoteser:
- H0nollhypotesen, att populationsmedelvärdet är lika med det värde som testas
- H1: den alternativa hypotesen, att populationsmedelvärdet skiljer sig från det värdet
T-testet är utformat för små stickprovsstorlekar, där normalapproximationen är otillförlitlig. Det kräver att data är approximativt normalfördelade.
T-testsyntax i R
Den grundläggande syntaxen för t.test() i R är:
t.test(x, y = NULL,
       mu = 0, var.equal = FALSE)
arguments:
- x : A vector to compute the one-sample t-test
- y: A second vector to compute the two sample t-test
- mu: Mean of the population under the null hypothesis
- var.equal: Specify whether the variances of the two vectors are equal. By default, set to `FALSE`
- paired: Set to `TRUE` when the two vectors are repeated measures on the same subjects
Innan du kör något, matcha din datalayout med rätt variant av testet.
Typer av T-test i R
Att välja fel variant är det vanligaste misstaget vid t-test, så börja med att matcha din datalayout med rätt anrop.
| Typ | Använd den när | R-samtal |
|---|---|---|
| Ett prov | En grupp jämfördes med ett känt målvärde | t.test(x, mu = värde) |
| Oberoende tvåprov (Welch) | Två separata grupper, varianser möjligen ojämna | t.test(x, y) |
| Oberoende tvåprov (poolat) | Två separata grupper med lika varians | t.test(x, y, var.equal = TRUE) |
| parat | Samma försökspersoner mättes två gånger | t.test(x, y, parat = SANT) |
| Ensidig | Du bryr dig bara om skillnaden i en riktning | t.test(x, mu = värde, alternativ = "större") |
Utöver tre grupper är ett t-test inte längre lämpligt. Växla till ANOVA test, vilket håller den totala felfrekvensen på 5 procent istället för att blåsa upp den över upprepade parvisa jämförelser.
Ett prov T-test i R
One Sample t-testet, eller studenttestet, jämför medelvärdet av en vektor med ett teoretiskt medelvärde,  . Formeln som används för att beräkna t-testet är:

Här,
 hänvisar till medelvärdet
 till det teoretiska medelvärdet
- s är standardavvikelsen
- n antalet observationer.
 hänvisar till medelvärdet
För att utvärdera den statistiska signifikansen för t-testet måste du beräkna p-värde. De p-värde sträcker sig från 0 till 1 och tolkas enligt följande:
- Ett p-värde lägre än 0.05 innebär att du kan förkasta nollhypotesen. Observera att att förkasta H0 inte är samma sak som att bevisa att H1 är sann, det betyder bara att data är osannolika under H0.
- Ett p-värde högre än 0.05 indikerar att du inte har tillräckligt med bevis för att förkasta nollhypotesen.
Du kan konstruera p-värdet genom att titta på motsvarande absoluta värde för t-testet i Studentfördelningen med en frihetsgrader lika med 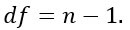
Till exempel, med 5 observationer jämför du ditt t-värde mot Studentfördelningen med 4 frihetsgrader vid 95 procents konfidensnivå. För att förkasta nollhypotesen i ett tvåsidigt test måste det absoluta t-värdet överstiga 2.776.
Se tabellen nedan:

Ett exempel på T-test i R
Anta att du är ett företag som producerar cookies. Varje kaka ska innehålla 10 gram socker. Kakorna tillverkas av en maskin som tillsätter sockret i en skål innan allt blandas. Du tror att maskinen inte tillsätter 10 gram socker för varje kaka. Om ditt antagande är sant måste maskinen fixas. Du lagrade sockernivån för trettio kakor.
Anmärkningar: Du kan skapa en randomiserad vektor med funktionen rnorm(). Denna funktion genererar normalfördelade värden. Den grundläggande syntaxen är:
rnorm(n, mean, sd)
arguments
- n: Number of observations to generate
- mean: The mean of the distribution. Optional
- sd: The standard deviation of the distribution. Optional
Du kan skapa en fördelning med 30 observationer med ett medelvärde på 9.99 och en standardavvikelse på 0.04.
set.seed(123)
sugar_cookie <- rnorm(30, mean = 9.99, sd = 0.04)
head(sugar_cookie)
Produktion:
## [1] 9.967581 9.980793 10.052348 9.992820 9.995172 10.058603
Du kan använda ett t-test med ett prov för att kontrollera om sockernivån skiljer sig från receptet. Du kan rita ett hypotestest:
- H0: Den genomsnittliga nivån av socker är lika med 10
- H1: Den genomsnittliga nivån av socker är annorlunda än 10
Du använder en signifikansnivå på 0.05.
# H0 : mu = 10
t.test(sugar_cookie, mu = 10)
Här är utgången:

P-värdet för t-testet med ett stickprov är 0.1079, vilket är över tröskelvärdet på 0.05. 95-procentigt konfidensintervall för medelvärdet går från 9.973 till 10.002 gram, och det innehåller målvärdet 10. Du kan därför inte förkasta H0: det finns inte tillräckligt med bevis för att maskinen avviker från receptet.
Oberoende två-sampel T-test i R
Det oberoende t-testet med två stickprov är den vanligaste varianten, och det gäller när de två uppsättningarna mätningar kommer från olika försökspersoner: två verkstäder, två maskiner, två behandlingsarmar.
Anta att en fabrik har två produktionslinjer och du vill veta om de fyller burkar till samma vikt.
set.seed(123)
line_a <- rnorm(25, mean = 500, sd = 8)
line_b <- rnorm(25, mean = 505, sd = 8)

# Welch test, the safe default
t.test(line_a, line_b)

# Pooled test, only when the variances are equal
t.test(line_a, line_b, var.equal = TRUE)
Läs utdata i fyra steg.
- t är den standardiserade storleken på gapet mellan de två medelvärdena. Dess tecken återspeglar endast den ordning i vilken du skickade vektorerna.
- df är frihetsgraderna. Welch producerar ett bråkvärde; det poolade testet ger ett heltal lika med n1 + n2 – 2.
- p-värde är sannolikheten att se ett så stort gap om de verkliga medelvärdena var identiska.
- Konfidensintervall begränsar den sanna skillnaden. När den innehåller noll är skillnaden inte signifikant på den nivån.
Om dina data finns i en enda dataram med en kolumn med värden och en faktorkolumn, använd formelgränssnittet istället, vilket är lättare att läsa och undviker att dela upp data manuellt:
t.test(weight ~ line, data = jars)
Vilken version ska användas. Lämna var.equals standardvärde på FALSE om du inte har testat och bekräftat lika varianser. Welchs korrigering kostar nästan ingenting i kraft när varianserna råkar matcha, och den skyddar dig när de inte gör det.
Parat T-test i R
Parat t-test, även kallat beroende stickprovs-t-test, används när samma grupp mäts två gånger. Typiska tillämpningar är:
- A / B-test: Jämför två varianter
- Fallkontrollstudierföre och efter en behandling på samma försökspersoner
Parat T-testexempel i R
Ett dryckesföretag är intresserade av att veta resultatet av ett rabattprogram på försäljningen. Företaget bestämde sig för att följa den dagliga försäljningen i en av sina butiker där programmet marknadsförs. I slutet av programmet vill företaget veta om det finns en statistisk skillnad mellan den genomsnittliga försäljningen i butiken före och efter programmet.
- Företaget tracKörde försäljningen varje dag innan programmet startade. Detta är vår första vektor.
- Programmet marknadsförs under en vecka och försäljningen registreras varje dag. Detta är vår andra vektor.
- Du kommer att utföra t-testet för att bedöma programmets effektivitet. Detta kallas ett parat t-test eftersom värdena för båda vektorerna kommer från samma distribution (dvs samma butik).
Hypotestestningen är:
- H0: Ingen skillnad i medelvärde
- H1: De två sätten är olika
Kom ihåg att det klassiska t-testet antar en okänd men lika stor varians i båda grupperna. Verkliga data uppfyller sällan detta exakt, och att ignorera skillnaden kan förvränga resultatet.
Lösningen är Welchs t-test, vilket minskar antagandet om lika varians. R tillämpar det som standard eftersom var.equal är FALSE om du inte anger något annat. I denna datauppsättning genererades båda vektorerna med samma standardavvikelse, så du kan säkert sätta var.equal = TRUE.
Du skapar två slumpmässiga vektorer från en gaussisk fördelning med ett högre medelvärde för försäljningen efter programmet.
set.seed(123)
# sales before the program
sales_before <- rnorm(7, mean = 50000, sd = 50)
# sales after the program.This has higher mean
sales_after <- rnorm(7, mean = 50075, sd = 50)
# draw the distribution
t.test(sales_before, sales_after,var.equal = TRUE)

P-värdet är 0.04606, strax under tröskelvärdet 0.05, så du förkastar H0 och drar slutsatsen att de två medelvärdena skiljer sig signifikant. Rabattprogrammet verkar ha ökat försäljningen.
⚠️ Viktigt: anropet ovan jämför de två vektorerna som oberoende prover. Eftersom båda serierna är mätningar på samma verkstad, adderar det statistiskt korrekta anropet parat = SANT:
t.test(sales_before, sales_after, paired = TRUE)
Den parade formen testar medelvärdet av dag-för-dag-skillnaderna istället för skillnaden mellan två medelvärden. Den tar bort variationen på verkstadsnivå som delas av båda vektorerna och har därför större statistisk styrka.
Hur man kontrollerar T-testantaganden i R
Ett t-tests p-värde är bara meningsfullt när dess antaganden gäller. Var och en har en direkt kontroll.
1. Normalitet. En- och två-stickprovstesterna antar att värdena är ungefär normala; det parade testet antar att skillnader Inspektera ett QQ-diagram och bekräfta med Shapiro-Wilk-testet:
qqnorm(sugar_cookie); qqline(sugar_cookie)
shapiro.test(sugar_cookie)

# for a paired design, test the differences
shapiro.test(sales_after - sales_before)
Ett Shapiro-Wilk p-värde över 0.05 innebär att normaliteten inte kan förkastas. Med mer än cirka 30 observationer per grupp gör den centrala gränsvärdessatsen t-testet robust till måttlig skevhet ändå.
2. Lika varians. Endast det poolade två-stickprovstestet behöver detta. Testa det med ett F-test:
var.test(line_a, line_b)
Ett p-värde över 0.05 stöder lika varianser, vilket motiverar att var.equal = TRUE.
3. Oberoende. Detta följer av studiedesignen och kan inte testas i efterhand. Om samma försöksperson bidrar till båda vektorerna är det oberoende testet helt enkelt fel verktyg och du behöver parat = SANT.
När ett antagande fallerar. För tydligt icke-normala data med små stickprov, använd de rangbaserade alternativen: wilcox.test(x, y) ersätter t-testet med två stickprov och wilcox.test(x, y, paired = TRUE) ersätter den parade versionen. Ingen av dem kräver normalitet, även om båda utbyter lite makt när data faktiskt är normala.
T-test i R: Viktiga slutsatser och testreferenser
- Statistisk slutledning är konsten att dra slutsatser om fördelningen av data.
- T-testet tillhör familjen av slutsatsstatistik. Det används ofta för att ta reda på om det finns en statistisk skillnad mellan medelvärdena för två grupper.
- Ett-sample t-test, eller Students test, jämför medelvärdet av en vektor med ett teoretiskt medelvärde.
- Det parade t-testet, eller det beroende stickprovets t-test, tillämpas när samma grupp mäts två gånger.
Tabellen nedan sammanfattar varje test som behandlats ovan:
| Testa | Hypotes att testa | p-värde | Code | Valfritt argument |
|---|---|---|---|---|
| ett-prov t-test | Medelvärdet för en vektor skiljer sig från det teoretiska medelvärdet | 0.05 |
t.test(x, mu = mean)
|
|
| parat prov t-test | Medelvärde A skiljer sig från medelvärde B för samma försökspersoner | 0.05 |
t.test(A, B, paired = TRUE) |
var.equal = TRUE
|
Om du är villig att anta lika varianser i ett oberoende tvåprovstest, sätt var.equal = TRUE. Låt standardvärdet vara FALSE för att köra den säkrare Welch-korrigeringen.
