
Funktioner i R-programmering med exempel
 Redaktionellt team
⚡ Smart sammanfattning
Funktioner i R paketerar en uppsättning instruktioner under ett namn, så en upprepad uppgift körs från ett enda anrop. Inbyggda matematik- och statistikhjälpmedel, användardefinierade funktioner, miljöscoping, och villkorliga argument täcks här med bearbetade exempel.
Vad är en funktion i R?
A fungera, i en programmeringsmiljö, är en uppsättning instruktioner. En programmerare bygger en funktion för att undvika upprepa samma uppgifteller minska Komplexiteten.
En funktion bör vara
- skriven för att utföra en specifik uppgift
- kan innehålla argument eller inte
- innehålla en kropp
- kan returnera ett eller flera värden, eller kanske inte.
En allmän inställning till en funktion är att använda argumentdelen som ingångar, mata kropp del och slutligen tillbaka en produktion. Syntaxen för en funktion är följande:
function (arglist)  {
  #Function body
}
R viktiga inbyggda funktioner
Det finns många inbyggda funktioner i R. R matchar dina indataparametrar med dess funktionsargument, antingen efter värde eller position, och kör sedan funktionskroppen. Funktionsargument kan ha standardvärden: om du inte anger dessa argument kommer R att ta standardvärdet.
Anmärkningar:
Det är möjligt att se källkoden för en funktion genom att köra namnet på själva funktionen i konsolen.
Typing Ett funktionsnamn utan parenteser skriver ut dess källkod, som konsolen nedan visar.

Vi kommer att se tre grupper av funktioner i aktion
- Allmän funktion
- Matematik funktion
- Statistisk funktion
Allmänna funktioner
Vi är redan bekanta med allmänna funktioner som cbind(), rbind(), range(), sortera(), och order(). Var och en av dessa funktioner har en specifik uppgift, tar argument för att returnera en utdata. Följande är viktiga funktioner man måste känna till-
diff() funktion
Om du jobbar på tidsföljder, måste du stilla serien genom att ta deras fördröjningsvärden. En stationär process tillåter konstant medelvärde, varians och autokorrelation över tid. Detta förbättrar främst prediktionen av en tidsserie. Detta kan göras med funktionen diff(). Vi kan bygga slumpmässiga tidsseriedata med en trend och sedan använda funktionen diff() för att stationära serien. Funktionen diff() accepterar ett argument, en vektor, och returnerar lämplig laggad och itererad differens.
AnmärkningarVi behöver ofta skapa slumpmässiga data, men för inlärning och jämförelse vill vi att talen ska vara identiska mellan maskiner. För att säkerställa att vi alla genererar samma data använder vi funktionen set.seed() med godtyckliga värden på 123. set.seed() fixerar startpunkten för pseudoslumptalsgeneratorn, så att varje maskin producerar samma sekvens. Utan set.seed() returnerar varje körning en annan sekvens.
set.seed(123)
## Create the data
x = rnorm(1000)
ts <- cumsum(x)
## Stationary the serie
diff_ts <- diff(ts)
par(mfrow=c(1,2))
## Plot the series
plot(ts, type='l')
plot(diff(ts), type='l')
De två panelerna nedan placerar den ursprungliga kumulativa serien bredvid den differenterade serien, som nu fluktuerar kring ett konstant medelvärde.

length() funktion
I många fall vill vi veta längden på en vektor för beräkning eller för att kunna användas i en for-loop. Funktionen length() räknar antalet rader i vektorn x. Följande koder importerar cars-datasetet och returnerar antalet rader.
Anmärkningar: length() returnerar antalet element i en vektor. Om funktionen skickas till en matris eller en dataframe, returneras antalet kolumner.
dt <- cars
## number columns
length(dt)
Produktion:
## [1] 1
## number rows
length(dt[,1])
Produktion:
## [1] 50
Matematiska funktioner
Utöver de allmänna hjälparna har R en uppsättning matematiska funktioner som opererar element för element på en vektor.
| Operator | BESKRIVNING |
|---|---|
| abs (x) | Tar det absoluta värdet av x |
| log(x,bas=y) | Tar logaritmen av x med basen y; om bas inte anges, returnerar den naturliga logaritmen |
| exp(x) | Returnerar exponentialen för x |
| sqrt (x) | Returnerar kvadratroten av x |
| factorial(x) | Returnerar faktorvärdet av x (x!) |
# sequence of number from 44 to 55 both including incremented by 1
x_vector <- seq(45,55, by = 1)
#logarithm
log(x_vector)
Produktion:
##  [1] 3.806662 3.828641 3.850148 3.871201 3.891820 3.912023 3.931826
##  [8] 3.951244 3.970292 3.988984 4.007333
#exponential
exp(x_vector)
#squared root
sqrt(x_vector)
Produktion:
##  [1] 6.708204 6.782330 6.855655 6.928203 7.000000 7.071068 7.141428
##  [8] 7.211103 7.280110 7.348469 7.416198
#factorial
factorial(x_vector)
Produktion:
##  [1] 1.196222e+56 5.502622e+57 2.586232e+59 1.241392e+61 6.082819e+62
##  [6] 3.041409e+64 1.551119e+66 8.065818e+67 4.274883e+69 2.308437e+71
## [11] 1.269640e+73
Statistiska funktioner
Där matematiska funktioner transformerar värden, sammanfattar de statistiska funktionerna dem. Standardinstallationen av R innehåller ett brett utbud av statistiska funktioner. I den här handledningen kommer vi kortfattat att titta på de viktigaste.
Grundläggande statistikfunktioner
| Operator | BESKRIVNING |
|---|---|
| medelvärde(x) | Medelvärde av x |
| median(x) | Median av x |
| var(x) | Varians av x |
| sd(x) | Standardavvikelse för x |
| skala (x) | Standardpoäng (z-poäng) för x |
| kvantil (x) | Kvartilerna för x |
| sammanfattning(x) | Sammanfattning av x: medelvärde, min, max osv. |
speed <- dt$speed
speed
# Mean speed of cars dataset
mean(speed)
Produktion:
## [1] 15.4
# Median speed of cars dataset
median(speed)
Produktion:
## [1] 15
# Variance speed of cars dataset
var(speed)
Produktion:
## [1] 27.95918
# Standard deviation speed of cars dataset
sd(speed)
Produktion:
## [1] 5.287644
# Standardize vector speed of cars dataset
head(scale(speed), 5)
Produktion:
##           [,1]
## [1,] -2.155969
## [2,] -2.155969
## [3,] -1.588609
## [4,] -1.588609
## [5,] -1.399489
# Quantile speed of cars dataset
quantile(speed)
Produktion:
##   0%  25%  50%  75% 100%
##    4   12   15   19   25
# Summary speed of cars dataset
summary(speed)
Produktion:
##    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
##     4.0    12.0    15.0    15.4    19.0    25.0
Fram till denna punkt har vi lärt oss många inbyggda R-funktioner.
AnmärkningarVar försiktig med argumentets klass, dvs. numeriskt, booleskt eller strängvärde. Om vi till exempel behöver skicka ett strängvärde måste vi omge strängen med citattecken: "ABC".
Skrivfunktion i R
Ibland behöver vi skriva vår egen funktion eftersom vi måste utföra en viss uppgift och ingen färdig funktion finns. En användardefinierad funktion involverar en namn, argument och en kropp.
function.name <- function(arguments)
{
    computations on the arguments
    some other code
}
Anmärkningar: En bra praxis är att namnge en användardefinierad funktion som skiljer sig från en inbyggd funktion. Det undviker förvirring.
En argumentfunktion
I nästa utdrag definierar vi en enkel kvadratisk funktion. Funktionen accepterar ett värde och returnerar kvadraten på värdet.
square_function<- function(n)
{
  # compute the square of integer `n`
  n^2
}
# calling the function and passing value 4
square_function(4)
Code Förklaring
- Funktionen heter square_function; det kan kallas vad vi vill.
- Den får argumentet "n". Vi angav inte typen av variabel så att användaren kan skicka ett heltal, en vektor eller en matris
- Funktionen tar ingången "n" och returnerar kvadraten på ingången. När du är klar med funktionen kan vi ta bort den med funktionen rm().
# efter att du skapat funktionen
rm(square_function)
square_function
På konsolen kan vi se ett felmeddelande: Fel: objektet 'square_function' hittades inte som talar om att funktionen inte existerar.
Miljö Scoping
I R, den miljö är en samling objekt som funktioner, variabler, dataframes etc.
R öppnar en miljö varje gång RStudio startas.
Den tillgängliga toppnivåmiljön är global miljö, kallad R_GlobalEnv. Och vi har lokal miljö.
Vi kan lista innehållet i den aktuella miljön.
ls(environment())
Produktion
## [1] "diff_ts"         "dt"              "speed"           "square_function"
## [5] "ts"              "x"               "x_vector"
Du kan se alla variabler och funktioner som skapats i R_GlobalEnv.
Listan ovan kommer att variera beroende på vilken kod du kör tidigare i RStudio.
Observera att n, argumentet för funktionen square_function finns inte i denna globala miljö.
En ny miljö skapas för varje funktion. I exemplet ovan skapar funktionen square_function() en ny miljö inuti global miljö.
För att klargöra skillnaden mellan global och lokal miljö, låt oss studera följande exempel
Dessa funktioner tar ett värde x som ett argument och lägger till det till y definiera utanför och inuti funktionen

Funktionen f returnerar utgången 15. Detta beror på att y definieras i den globala miljön. Vilken variabel som helst som definieras i den globala miljön kan användas lokalt. Variabeln y har värdet 10 under alla funktionsanrop och är tillgänglig när som helst.
Låt oss se vad som händer om variabeln y är definierad inuti funktionen.
Vi måste släppa "y" innan vi kör den här koden med rm r
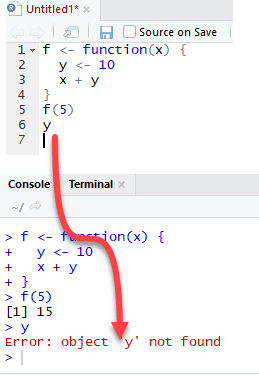
Utdata är också 15 när vi anropar f(5) men returnerar ett fel när vi försöker skriva ut värdet y. Variabeln y finns inte i den globala miljön.
Slutligen använder R den senaste variabeldefinitionen för att passera in i kroppen av en funktion. Låt oss överväga följande exempel:

R ignorerar y-värdena som definierats utanför funktionen eftersom vi uttryckligen skapade en ay-variabel inuti funktionens kropp.
Multi argument funktion
Vi kan skriva en funktion med mer än ett argument. Tänk på funktionen som kallas "tider". Det är en enkel funktion som multiplicerar två variabler.
times <- function(x,y) {
  x*y
	}
times(2,4)
Produktion:
## [1] 8
När ska vi skriva funktion?
Dataforskare behöver utföra många repetitiva uppgifter. För det mesta kopierar och klistrar vi in bitar av kod upprepade gånger. Till exempel rekommenderas normalisering av en variabel starkt innan vi kör en maskininlärning algoritm. Formeln för att normalisera en variabel är:

Vi vet redan hur man använder funktionen min() och max() i R. Vi använder tibble-biblioteket för att skapa dataramen. Tibble är hittills den mest bekväma funktionen för att skapa en datamängd från grunden.
library(tibble)
# Create a data frame
data_frame <- tibble(
  c1 = rnorm(50, 5, 1.5),
  c2 = rnorm(50, 5, 1.5),
  c3 = rnorm(50, 5, 1.5),
)
Vi kommer att gå vidare i två steg för att beräkna funktionen som beskrivs ovan. I det första steget skapar vi en variabel som heter c1_norm, vilket är en omskalning av c1. I steg två kopierar och klistrar vi bara in koden för c1_norm och ändrar den med c2 och c3.
Detalj av funktionen med kolumnen c1:
Nominator: : data_frame$c1 -min(data_frame$c1))
Nämnare: max(data_frame$c1)-min(data_frame$c1))
Därför kan vi dela dem för att få det normaliserade värdet av kolumn c1:
(data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
Vi kan skapa c1_norm, c2_norm och c3_norm:
Create c1_norm: rescaling of c1
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
# show the first five values
head(data_frame$c1_norm, 5)
Produktion:
## [1] 0.3400113 0.4198788 0.8524394 0.4925860 0.5067991
Det fungerar. Vi kan kopiera och klistra in
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
ändra sedan c1_norm till c2_norm och c1 till c2. Vi gör samma sak för att skapa c3_norm
data_frame$c2_norm <- (data_frame$c2 - min(data_frame$c2))/(max(data_frame$c2)-min(data_frame$c2))
data_frame$c3_norm <- (data_frame$c3 - min(data_frame$c3))/(max(data_frame$c3)-min(data_frame$c3))
Vi skalade om variablerna c1, c2 och c3 perfekt.
Den här metoden är dock benägen att göra misstag. Vi kan kopiera och glömma att ändra kolumnnamnet efter inklistring. Därför är det en bra idé att skriva en funktion varje gång du behöver klistra in samma kod mer än två gånger. Vi kan omforma koden till en formel och anropa den närhelst det behövs. För att skriva vår egen funktion måste vi ge:
- Namn: normalisera.
- antalet argument: Vi behöver bara ett argument, vilket är den kolumn vi använder i vår beräkning.
- Kroppen: detta är helt enkelt formeln vi vill returnera.
Vi kommer att gå vidare steg för steg för att skapa funktionen normalisera.
Steg 1) Vi skapar nominatorn, som är x – min(x). I R kan vi lagra nominatorn i en variabel som denna:
nominator <- x-min(x)
Steg 2) Vi beräknar nämnaren: max(x) – min(x). Vi kan upprepa idén från steg 1 och lagra beräkningen i en variabel:
denominator <- max(x)-min(x)
Steg 3) Vi utför uppdelningen mellan nämnare och nämnare.
normalize <- nominator/denominator
Steg 4) För att returnera värde till anropande funktion måste vi skicka normalize inuti return() för att få utdata från funktionen.
return(normalize)
Steg 5) Vi är redo att använda funktionen genom att wrapaping allt innanför fästet.
normalize <- function(x){
  # step 1: create the nominator
  nominator <- x-min(x)
  # step 2: create the denominator
  denominator <- max(x)-min(x)
  # step 3: divide nominator by denominator
  normalize <- nominator/denominator
  # return the value
  return(normalize)
}
Låt oss testa vår funktion med variabeln c1:
normalize(data_frame$c1)
Det fungerar perfekt. Vi skapade vår första funktion.
En funktion är ett mer omfattande sätt att utföra en repetitiv uppgift. Vi kan använda normaliseringsformeln över olika kolumner, som nedan:
data_frame$c1_norm_function <- normalize (data_frame$c1)
data_frame$c2_norm_function <- normalize	(data_frame$c2)
data_frame$c3_norm_function <- normalize	(data_frame$c3)
Även om exemplet är enkelt kan vi utläsa kraften i en formel. Ovanstående kod är lättare att läsa och undviker de misstag som uppstår vid inklistring av kod.
Fungerar med skick
Funktionen normalize() gör alltid samma sak. Ibland behöver vi inkludera villkor i en funktion för att tillåta att koden returnerar olika utdata.
I maskininlärningsuppgifter måste vi dela upp datasetet mellan en tåguppsättning och en testuppsättning. Tåguppsättningen låter algoritmen lära sig av data. För att testa vår modells prestanda kan vi använda testsetet för att returnera prestandamåttet. R har ingen funktion för att skapa två datamängder. Vi kan skriva vår egen funktion för att göra det. Vår funktion tar två argument och kallas split_data(). Tanken bakom är enkel, vi multiplicerar längden på datasetet (dvs antalet observationer) med 0.8. Till exempel, om vi vill dela datamängden 80/20, och vår datauppsättning innehåller 100 rader, kommer vår funktion att multiplicera 0.8*100 = 80. 80 rader kommer att väljas ut för att bli vår träningsdata.
Vi kommer att använda luftkvalitetsdataset för att testa vår användardefinierade funktion. Luftkvalitetsdataset har 153 rader. Vi kan se det med koden nedan:
nrow(airquality)
Produktion:
## [1] 153
Vi kommer att gå tillväga enligt följande:
split_data <- function(df, train = TRUE)
Arguments:
-df: Define the dataset
-train: Specify if the function returns the train set or test set. By default, set to TRUE
Vår funktion har två argument. Argumenttåget är en boolesk parameter. Om den är satt till TRUE skapar vår funktion tågdatasetet, annars skapar den testdatasetet.
Vi kan fortsätta som vi gjorde med normalize()-funktionen. Vi skriver koden som om det bara vore engångskod och sedan lindar vi in allt med villkoret i kroppen för att skapa funktionen.
Steg 1:
Vi måste beräkna längden på datasetet. Detta görs med funktionen nrow(). Nrow returnerar det totala antalet rader i datamängden. Vi kallar den variabla längden.
length<- nrow(airquality)
length
Produktion:
## [1] 153
Steg 2:
Vi multiplicerar längden med 0.8. Det kommer att returnera antalet rader att välja. Det ska vara 153*0.8 = 122.4
total_row <- length*0.8
total_row
Produktion:
## [1] 122.4
Vi vill välja 122 rader bland de 153 raderna i luftkvalitetsdatauppsättningen. Vi skapar en lista som innehåller värden från 1 till total_row. Vi lagrar resultatet i variabeln som kallas split
split <- 1:total_row
split[1:5]
Produktion:
## [1] 1 2 3 4 5
split väljer de första 122 raderna från datamängden. Till exempel kan vi se att vår variabeldelning samlar värdena 1, 2, 3, 4, 5 och så vidare. Dessa värden kommer att vara indexet när vi väljer de rader som ska returneras.
Steg 3:
Vi måste välja raderna i luftkvalitetsdataset baserat på värdena som lagras i den delade variabeln. Detta görs så här:
train_df <- airquality[split, ]
head(train_df)
Produktion:
##[1]    Ozone Solar.R Wind Temp Month Day
##[2]  51    13     137 10.3   76     6  20
##[3]  15    18      65 13.2   58     5  15
##[4]  64    32     236  9.2   81     7   3
##[5]  27    NA      NA  8.0   57     5  27
##[6]  58    NA      47 10.3   73     6  27
##[7]  44    23     148  8.0   82     6  13
Steg 4:
Vi kan skapa testdatauppsättningen genom att använda de återstående raderna, 123:153. Detta görs genom att använda – framför split.
test_df <- airquality[-split, ]
head(test_df)
Produktion:
##[1] Ozone Solar.R Wind Temp Month Day
##[2]  123    85     188  6.3   94     8  31
##[3]  124    96     167  6.9   91     9   1
##[4]  125    78     197  5.1   92     9   2
##[5]  126    73     183  2.8   93     9   3
##[6]  127    91     189  4.6   93     9   4
##[7]  128    47      95  7.4   87     9   5
Steg 5:
Vi kan skapa villkoret inuti kroppen av funktionen. Kom ihåg att vi har ett argumenttåg som är ett booleskt satt till TRUE som standard för att returnera tåguppsättningen. För att skapa villkoret använder vi if-syntaxen:
  if (train ==TRUE){
    train_df <- airquality[split, ]
      return(train)
  } else {
    test_df <- airquality[-split, ]
      return(test)
  }
Detta är det, vi kan skriva funktionen. Vi behöver bara ändra luftkvaliteten till df eftersom vi vill prova vår funktion till ev dataram, inte bara luftkvalitet:
split_data <- function(df, train = TRUE){
  length<- nrow(df)
  total_row <- length *0.8
  split <- 1:total_row
  if (train ==TRUE){
    train_df <- df[split, ]
      return(train_df)
  } else {
    test_df <- df[-split, ]
      return(test_df)
  }
}
Låt oss testa vår funktion på luftkvalitetsdatasetet. Vi borde ha ett tågset med 122 rader och ett testset med 31 rader.
train <- split_data(airquality, train = TRUE)
dim(train)
Produktion:
## [1] 122 6
test <- split_data(airquality, train = FALSE)
dim(test)
Produktion:
## [1] 31 6
