
R Data Frame: Hur man skapar, lägger till, väljer och delar
 Evelyn Clarke
⚡ Smart sammanfattning
R Data Frame lagrar kolumner av olika typer med samma längd, vilket gör den till den rektangulära standardstrukturen för analys. Hakparenteser segmenterar rader och kolumner, dollartecknet visas i en kolumn och subset() filtrerar efter villkor.
Vad är en dataram?
A dataram är en lista med vektorer som är lika långa. En matris innehåller bara en typ av data, medan en dataram accepterar olika datatyper (numeriska, tecken-, faktor-, etc.).
Den definitionen placerar dataramen mellan två grannar som du ständigt kommer att möta i R. A matris är rektangulär men enkelformad, och en lista är flertypad men ojämn. Dataramen lånar en egenskap från varje.
| Structure | Kolumntyper | Elementlängder | Typisk användning |
|---|---|---|---|
| vektor | Endast en typ | Enkel sekvens | En variabel |
| Matris | Endast en typ | Rektangulär | Numerisk algebra |
| Lista | Vilken blandning av typer som helst | Kan variera per element | Godtyckliga samlingar |
| Dataram | Vilken blandning av typer som helst | Varje kolumn är lika lång | Tabellanalys |
Eftersom en dataram egentligen är en lista under, fungerar accessorerna som används på listor även här, vilket är anledningen till att dollartecknet visas igen senare i den här handledningen.
Hur man skapar en dataram
Vi kan skapa en dataram i R genom att skicka variablerna a, b, c och d till funktionen data.frame(). Vi kan skapa dataframen och namnge kolumnerna med names(), genom att helt enkelt ange namnet på varje variabel.
data.frame(df, stringsAsFactors = TRUE)
Argument:
- df: Det kan vara en matris att konvertera som en dataram eller en samling variabler som ska sammanfogas
- stringsAsFactors: Styr om teckenvektorer blir faktorkolumner. Det fabriksnya standardvärdet var SANT i äldre versioner och har varit FALSKT sedan R 4.0.0, så skicka det explicit när beteendet är viktigt.
Vi kan skapa en dataram i R för vår första datamängd genom att kombinera fyra variabler av samma längd.
# Create a, b, c, d variables
a <- c(10,20,30,40)
b <- c('book', 'pen', 'textbook', 'pencil_case')
c <- c(TRUE,FALSE,TRUE,FALSE)
d <- c(2.5, 8, 10, 7)
# Join the variables to create a data frame
df <- data.frame(a,b,c,d)
df
Produktion:
##     a         b     c     d
## 1  10        book  TRUE   2.5
## 2  20         pen  FALSE  8.0
## 3  30    textbook  TRUE   10.0
## 4  40 pencil_case  FALSE  7.0
Varje vektor blev en kolumn, och de fyra värdena i varje vektor blev de fyra raderna. Observera att argumenten var namnlösa, så R härledde kolumnrubrikerna från själva variabelnamnen.
Vi kan se kolumnrubrikerna har samma namn som variablerna. Vi kan ändra kolumnnamn i R med funktionen names(). Kontrollera R create dataframe-exemplet nedan:
# Name the data frame
names(df) <- c('ID', 'items', 'store', 'price')
df
Produktion:
##   ID       items store price
## 1 10        book  TRUE   2.5
## 2 20         pen FALSE   8.0
## 3 30    textbook  TRUE  10.0
## 4 40 pencil_case FALSE   7.0
Att tilldela names() ersätter varje rubrik samtidigt, så ersättningsvektorn måste ha exakt en post per kolumn. För att byta namn på en enskild kolumn istället, indexera names-vektorn, som i names(df)[2] <- 'product'.
# Print the structure
str(df)
Produktion:
## 'data.frame':    4 obs. of  4 variables:
##  $ ID   : num  10 20 30 40
##  $ items: Factor w/ 4 levels "book","pen","pencil_case",..: 1 2 4 3
##  $ store: logi  TRUE FALSE TRUE FALSE
##  $ price: num  2.5 8 10 7
Versionsanteckning. Utdata ovan producerades i en R-version äldre än 4.0.0, där data.frame() konverterade teckenvektorer till faktorer som standard, vilket är anledningen till att objekt rapporteras som en faktor med fyra nivåer. Basdokumentationen i R registrerar att denna fabriksnya standardinställning ändrad till stringsAsFactors = FALSE för R 4.0.0Om man kör samma kod i en aktuell version lämnas objekten kvar som en vanlig teckenkolumn, och str() skriver ut chr istället. Lägg till stringsAsFactors = TRUE till data.frame()-anropet för att reproducera den utskrivna utdatan, eller läs faktor handledning för när faktorer faktiskt önskas.
Slice Data Frame
När ramen är byggd är nästa uppgift att dra ut delar av den igen. Slicing är det grundläggande R-sättet att göra det, och det använder samma hakparenteser som vektorer, bara med två positioner istället för en.
Det är möjligt att SLICE-a värden i en dataframe. Vi väljer raderna och kolumnerna som ska returneras inom parenteser föregångna av namnet på dataframen.
En dataram är sammansatt av rader och kolumner, df[A, B]. A representerar raderna och B kolumnerna. Vi kan skära antingen genom att ange rader och/eller kolumner.
Från bild 1 nedan representerar den vänstra delen rader, och den högra delen är kolonner. Observera att symbolen : betyder till. Till exempel, 1:3 avser att välja värden från 1 till 3.

I diagrammet nedan visar vi hur man kommer åt olika val i dataframen:
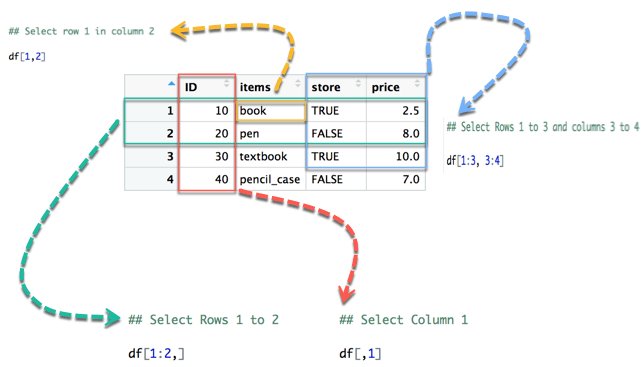
- Den gula pilen väljer v 1 i kolumn 2
- Den gröna pilen väljer rader 1 till 2
- Den röda pilen väljer kolumn 1
- Den blå pilen väljer rader 1 till 3 och kolonner 3 till 4
Observera att om vi låter den vänstra delen vara tom kommer R att välja alla rader. I analogi, om vi låter den högra delen vara tom, kommer R att välja alla kolumner.
Vi kan köra koden i konsolen:
## Select row 1 in column 2
df[1,2]
Produktion:
## [1] book
## Levels: book pen pencil_case textbook
Raden Levels visas eftersom objekt är en faktor i den här sessionen. I R 4.0.0 och senare skriver samma anrop ut den enkla strängen "bok" utan Levels-rad.
## Select Rows 1 to 2
df[1:2,]
Produktion:
##   ID items store price
## 1 10  book  TRUE   2.5
## 2 20   pen FALSE   8.0
## Select Columns 1
df[,1]
Produktion:
## [1] 10 20 30 40
Om man väljer en enskild kolumn med df[,1] tas frame wrappern bort och en vanlig vektor returneras. Lägg till drop = FALSE, som i df[, 1, drop = FALSE], när en dataframe med en kolumn behövs istället.
## Select Rows 1 to 3 and columns 3 to 4
df[1:3, 3:4]
Produktion:
##   store price
## 1  TRUE   2.5
## 2 FALSE   8.0
## 3  TRUE  10.0
Det är också möjligt att välja kolumnerna med deras namn. Till exempel koden nedan extracts två kolumner: ID och store.
# Slice with columns name
df[, c('ID', 'store')]
Produktion:
##   ID store
## 1 10  TRUE
## 2 20 FALSE
## 3 30  TRUE
## 4 40 FALSE
Namn är säkrare än positioner i produktionskod, eftersom infogning eller omordning av en kolumn i tysthet ändrar vad df[, 3] refererar till medan df[, 'store'] fortsätter att peka på samma data.
Lägg till en kolumn till dataram
Du kan också lägga till en kolumn i en dataframe. Du behöver använda symbolen $ för att namnge den nya variabeln och lägga till en kolumn i en dataframe i R.
# Create a new vector
quantity <- c(10, 35, 40, 5)

# Add `quantity` to the `df` data frame
df$quantity <- quantity
df
Produktion:
##   ID       items store price quantity
## 1 10        book  TRUE   2.5       10
## 2 20         pen FALSE   8.0       35
## 3 30    textbook  TRUE  10.0       40
## 4 40 pencil_case FALSE   7.0        5
Obs: Antalet element i vektorn måste vara lika med antalet element i dataframen. Kör följande kommando för att lägga till en kolumn i dataframen i R
quantity <- c(10, 35, 40)
# Add `quantity` to the `df` data frame
df$quantity <- quantity
Ger fel:
Error in `lt;-.data.frame`(`*tmp*`, quantity, value = c(10, 35, 40))
replacement has 3 rows, data has 4
Meddelandet namnger ersättningsoperatorn för dataframes och anger båda antalen, så det talar om exakt vad som ska åtgärdas. R återanvänder bara en ersättning när dess längd delar radantalet jämnt, vilket är anledningen till att ett längd-1-värde som df$currency <- 'EUR' accepteras medan en längd-3-vektor mot fyra rader vägras. cbind() lägger till en kolumn på samma sätt, och rbind() är dess motsvarighet för att lägga till rader.
Välj en kolumn i en dataram
Ibland behöver vi lagra en kolumn i en dataframe för framtida bruk eller utföra en operation på en kolumn. Vi kan använda $-tecknet för att välja kolumnen från en dataframe.
# Select the column ID
df$ID
Produktion:
## [1] 1 2 3 4
Läs utdata noggrant. ID byggdes från vektorn c(10, 20, 30, 40), så en livekonsol skriver ut 10 20 30 40 här; 1 2 3 4 som visas ovan är radpositioner snarare än de lagrade värdena. [1] i början av raden är helt enkelt indexet för det första elementet på den raden, inte en del av data.
Tre rutter når samma kolumn: df$ID, df[['ID']] och df[, 'ID']. Dollartecknet utför partiell matchning, så df$I skulle fortfarande hitta ID, vilket är bekvämt i konsolen och riskabelt i ett sparat skript.
Delinställ en dataram
I föregående avsnitt valde vi en hel kolumn utan villkor. Är det möjligt att delmängd baserat på om ett visst villkor var sant eller inte.
Vi använder subset()-funktionen.
subset(x, condition)
arguments:
- x: data frame used to perform the subset
- condition: define the conditional statement
Vi vill endast returnera varor med ett pris över 5, så vi kan göra:
# Select price above 5
subset(df, subset = price > 5)
Produktion:
ID       items store price
2 20         pen FALSE     8
3 30    textbook  TRUE    10
4 40 pencil_case FALSE     7
Radnamnen 2, 3 och 4 är de ursprungliga radnamnen som överförts från df, vilket är så du kan se att den första raden filtrerades bort. subset() accepterar också ett select-argument för att välja kolumner samtidigt, och motsvarande parentesform är df[df$price > 5, ]. Parentesformen behåller NA-rader där villkoret saknas, medan subset() tar bort dem, så de två är inte alltid utbytbara.
