
ANOVA i R: Envägs- och tvåvägstest med exempel
 Evelyn Clarke
⚡ Smart sammanfattning
ANOVA i R jämför medelvärdena för tre eller fler grupper genom att dela upp den totala variationen i komponenter mellan grupper och inom grupper. Denna genomgång kör envägs- och tvåvägstester på giftdatasetet, kontrollerar antaganden och isolerar olika par med Tukey HSD.
Vad är ANOVA?
Variansanalys (ANOVA) är en statistisk teknik som används för att jämföra medelvärdena för två eller flera grupper. Testet fungerar genom att dela upp den totala variationen i en mätning i den del som förklaras av grupptillhörighet och den del som blir kvar som slumpmässigt brus. ANOVA i R berättar därför om minst ett gruppmedelvärde skiljer sig från de andra, inte vilket. Det är en direkt förlängning av t-test till situationer där faktorvariabeln har mer än två nivåer.
Innan du kör ett test är det bra att veta vilken medlem av ANOVA-familjen som passar din design.
Typer av ANOVA-tester i R
”ANOVA” är en familj av tester snarare än en enda procedur. Att välja rätt medlem beror på hur många faktorer du har och hur data samlades in.
| Testa | När ska du använda den | R-samtal |
|---|---|---|
| Envägs ANOVA | En faktor med tre eller fler nivåer | aov(y ~ x, data = df) |
| Tvåvägs ANOVA | Två oberoende faktorer | aov(y ~ x1 + x2, data = df) |
| Tvåvägs med interaktion | Effekten av en faktor beror på den andra | aov(y ~ x1 * x2, data = df) |
| Upprepade mätningar ANOVA | Samma försökspersoner mättes mer än en gång | aov(y ~ x + Fel(subjekt/x)) |
| ANCOVA | En kontinuerlig kovariabel måste kontrolleras för | aov(y ~ x + kovariat, data = df) |
| MANOVA | Två eller flera svarsvariabler samtidigt | manova(cbind(y1, y2) ~ x) |
Den här handledningen täcker de tre första. De återstående varianterna använder samma aov()-gränssnitt, så när du väl kan läsa en utdatatabell kan du läsa dem alla.
ANOVA vs T-test i R: Viktiga skillnader
Båda testerna jämför medelvärden, så det är värt att vara exakt om var det ena ersätter det andra.
| Kriterier | T-test | ANOVA |
|---|---|---|
| Antal grupper | Exakt två | Två eller flera |
| Teststatistik | t | F, lika med t i kvadrat när det finns två grupper |
| Resultat | Anger skillnadens riktning | Rapporterar endast att det finns en skillnad |
| Uppföljning behövs | Ingen | Post hoc-test såsom Tukey HSD |
| R-funktion | t.test() | aov() |
Frestelsen med tre grupper är att köra tre separata t-tester. Motstå den. Varje test har sin egen felfrekvens på 5 procent, så tre jämförelser ökar risken för ett falskt positivt resultat till ungefär 14 procent. ANOVA besvarar samma fråga med ett enda test, och Tukey HSD hanterar sedan den parvisa detaljnivån med felfrekvensen i schack. För fallet med två grupper, se handledning för t-test.
Envägs ANOVA
Det finns många situationer där du behöver jämföra medelvärdet mellan flera grupper. Marknadsavdelningen vill till exempel veta om tre team har samma försäljningsprestanda.
- Lag: Faktor på 3 nivåer: A, B och C
- Försäljning: Ett mått på prestanda
ANOVA-testet kan avgöra om de tre grupperna har liknande prestationer.
För att klargöra om uppgifterna kommer från samma population kan du utföra en enkelriktad variansanalys (nedan kallat envägs-ANOVA). Liksom alla andra statistiska tester ger den bevis för huruvida H0-hypotesen kan förkastas. Observera att att inte förkasta H0 inte är detsamma som att bevisa att den är sann.
Hypotes i envägs ANOVA-test
- H0: Medelvärdena mellan grupperna är identiska
- H1: Åtminstone är medelvärdet för en grupp olika
Med andra ord, om H0 inte förkastas, finns det inte tillräckligt med bevis för att dra slutsatsen att medelvärdet för en grupp skiljer sig från de andra.
Detta test liknar t-testet, men ANOVA är det rätta valet när det finns fler än två grupper. Med exakt två grupper är de två testerna ekvivalenta och F-statistiken är lika med kvadraten på t-statistiken.
antaganden
Envägs-ANOVA vilar på tre villkor: observationerna är slumpmässigt urvalade och oberoende av varandra, residualerna inom varje grupp är approximativt normalfördelade och variansen är densamma i varje grupp (varianshomogenitet). Avsnittet om att kontrollera antaganden nedan visar hur man testar vart och ett i R.
Tolka ANOVA-test
F-statistiken används för att testa om data kommer från signifikant olika populationer, dvs olika urvalsmedelvärden.
För att beräkna F-statistiken måste du dividera variation mellan grupper över variation inom gruppen.
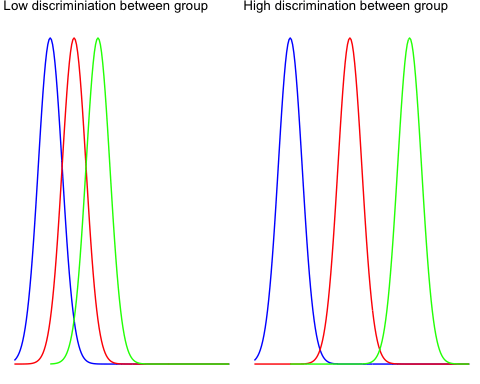
Ocuco-landskapet mellan-gruppen Variabiliteten återspeglar hur långt varje gruppmedelvärde ligger från det totala medelvärdet. Jämför de två graferna nedan för att förstå konceptet.
Den vänstra grafen visar väldigt liten variation mellan de tre grupperna, så alla tre gruppmedelvärden ligger nära övergripande betyda.
Den högra grafen plottar tre fördelningar långt ifrån varandra utan överlappning, så gapet mellan det totala medelvärdet och varje gruppmedelvärde är stort.
Ocuco-landskapet inom gruppen Variabilitet mäter hur långt individuella observationer avviker från medelvärdet för sin egen grupp. Vissa punkter ligger långt från sitt gruppmedelvärde, och inomgruppens term fångar exakt den spridningen, vilket är urvalsfelet.
För att visuellt förstå konceptet inom gruppvariabilitet, titta på grafen nedan.
Den vänstra delen visar fördelningen av tre olika grupper. Du ökade spridningen för varje urval och det är tydligt att den individuella variansen är stor. F-statistiken faller, så du skulle misslyckas med att förkasta nollhypotesen.
Den högra delen visar stickprov med samma medelvärden men mycket lägre spridning. Det höjer F-statistiken och pekar till förmån för den alternativa hypotesen.

Du kan använda båda måtten för att konstruera F-statistiken. Det är väldigt intuitivt att förstå F-statistiken. Om täljaren ökar betyder det att variationen mellan grupperna är hög, och det är troligt att grupperna i urvalet kommer från helt olika fördelningar.
Med andra ord indikerar en låg F-statistik liten eller ingen meningsfull skillnad mellan gruppens medelvärden.
Exempel Envägs ANOVA-test
Du kommer att använda giftdataset för att implementera envägs ANOVA-testet. Datauppsättningen innehåller 48 rader och 3 variabler:
- Tid: Djurets överlevnadstid
- gift: Typ av gift som används: faktornivå: 1,2 och 3
- behandla: Typ av behandling som används: faktornivå: 1,2 och 3
Innan du börjar beräkna ANOVA-testet måste du förbereda data enligt följande:
- Steg 1: Importera data
- Steg 2: Ta bort onödig variabel
- Steg 3: Konvertera variabel gift enligt beställd nivå
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/poisons.csv"
df <- read.csv(PATH) %>%
select(-X) %>%
mutate(poison = factor(poison, ordered = TRUE))
glimpse(df)
Produktion:
## Observations: 48
## Variables: 3
## $ time   <dbl> 0.31, 0.45, 0.46, 0.43, 0.36, 0.29, 0.40, 0.23, 0.22, 0...
## $ poison <ord> 1, 1, 1, 1, 2, 2, 2, 2, 3, 3, 3, 3, 1, 1, 1, 1, 2, 2, 2...
## $ treat  <fctr> A, A, A, A, A, A, A, A, A, A, A, A, B, B, B, B, B, B, ...
Vårt mål är att testa följande antagande:
- H0: Det finns ingen skillnad i genomsnittlig överlevnadstid mellan grupper
- H1: Genomsnittet för överlevnadstid är olika för minst en grupp.
Med andra ord vill du veta om det finns en statistisk skillnad mellan medelöverlevnadstiden beroende på vilken typ av gift som ges till marsvinet.
Du kommer att gå tillväga enligt följande:
- Steg 1: Kontrollera formatet på det variabla giftet
- Steg 2: Skriv ut den sammanfattande statistiken: antal, medelvärde och standardavvikelse
- Steg 3: Rita en boxplot
- Steg 4: Beräkna envägs ANOVA-testet
- Steg 5: Kör en parvis jämförelse med Tukey HSD
Steg 1) Kontrollera giftnivåerna med koden nedan. Du bör se tre teckenvärden, eftersom det muterade verbet konverterade kolumnen till en ordnad faktor.
levels(df$poison)
Produktion:
## [1] "1" "2" "3"
Steg 2) Du beräknar medelvärdet och standardavvikelsen.
df %>%
	group_by(poison) %>%
	summarise(
		count_poison = n(),
		mean_time = mean(time, na.rm = TRUE),
		sd_time = sd(time, na.rm = TRUE)
	)
Produktion:
##
# A tibble: 3 x 4
##   poison count_poison mean_time    sd_time
##    <ord>        <int>     <dbl>      <dbl>
## 1      1           16  0.617500 0.20942779
## 2      2           16  0.544375 0.28936641
## 3      3           16  0.276250 0.06227627
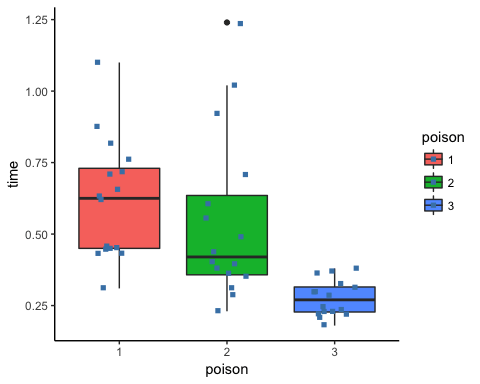
Steg 3) I steg tre kan du grafiskt kontrollera om det är skillnad mellan fördelningen. Observera att du inkluderar den skakiga punkten.
ggplot(df, aes(x = poison, y = time, fill = poison)) +
    geom_boxplot() +
    geom_jitter(shape = 15,
        color = "steelblue",
        position = position_jitter(0.21)) +
    theme_classic()
Produktion:
Steg 4) Du kan köra envägs ANOVA-testet med kommandot aov. Den grundläggande syntaxen för ett ANOVA-test är:
aov(formula, data)
Arguments:
- formula: The equation you want to estimate
- data: The dataset used
Formelns syntax är:
y ~ X1+ X2+...+Xn # X1 +  X2 +... refers to the independent variables
y ~ . # use all the remaining variables as independent variables
Nu kan du besvara frågan: finns det någon skillnad i överlevnadstid mellan marsvinen, med tanke på vilken typ av gift som administreras?
Lagra modellen i ett objekt och skicka den till summary() för att få en läsbar utskrift av resultaten.
anova_one_way <- aov(time~poison, data = df)
summary(anova_one_way)
Code Förklaring
- aov(tid ~ gift, data = df): Kör ANOVA-testet med följande formel
- summary(anova_one_way): Skriv ut sammanfattningen av testet
Produktion:
##             Df Sum Sq Mean Sq F value   Pr(>F)
## poison       2  1.033  0.5165   11.79 7.66e-05 ***
## Residuals   45  1.972  0.0438
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
P-värdet är 7.66e⁻⁶, långt under det vanliga tröskelvärdet på 0.05, och de tre stjärnorna markerar den starkaste signifikanskoden. Man kan förkasta H₂ och dra slutsatsen att minst en giftgrupp har en annan genomsnittlig överlevnadstid.
Hur man kontrollerar ANOVA-antaganden i R
Ett ANOVA p-värde är bara tillförlitligt när de tre tidigare angivna villkoren uppfylls. Var och en har en direkt kontroll i R, och alla körs på det anpassade modellobjektet.
1. Oberoende observationer. Detta är en egenskap hos studiedesignen, inte hos data, så inget test kan rädda den. Varje försökskanin måste mätas en gång och slumpmässigt tilldelas sin grupp. Om samma försöksperson förekommer i flera rader behöver du istället en modell med upprepade mätningar.
2. Residualernas normalitet. ANOVA antar att residualerna, inte rådata, är ungefär normala. Kontrollera QQ-diagrammet och bekräfta med Shapiro-Wilk-testet:
par(mfrow = c(2, 2))
plot(anova_one_way)          # four diagnostic plots

shapiro.test(residuals(anova_one_way))
Punkter som omsluter diagonalen i Normal QQ-diagrammet indikerar normala residualer. Ett Shapiro-Wilk p-värde över 0.05 innebär att man inte kan förkasta normalitet.
3. Varians homogenitet. Varje grupp bör visa en liknande spridning. Residuals vs Fitted-diagrammet bör se ut som ett platt band snarare än en tratt. Bekräfta detta med Levenes test, vilket är mer robust mot icke-normalitet än Bartletts:
library(car)
leveneTest(time ~ poison, data = df)

bartlett.test(time ~ poison, data = df)
Ett p-värde över 0.05 stöder lika varianser.
Vad man ska göra när ett antagande misslyckas. Om varianserna är ojämna, kör oneway.test(time ~ poison, data = df, var.equal = FALSE), Welch-korrektionen. Om residualerna är tydligt icke-normala och urvalet är litet, byt till Kruskal-Wallis rangtest, kruskal.test(time ~ poison, data = df). Med stora balanserade urval är ANOVA ganska robust till måttliga avvikelser från normalitet, så ett gränsfall till Shapiro-Wilk-resultat är sällan fatalt.
Parvis jämförelse
Ett signifikant F-test visar att gruppens medelvärden inte alla är lika, men inte vilket par som skiljer sig åt. Tukeys Honest Significant Difference-test svarar på det genom att jämföra varje par samtidigt som den familjevisa felfrekvensen kontrolleras.
TukeyHSD(anova_one_way)
Produktion:

Läs utdata en rad per par. diff kolumnen innehåller skillnaden mellan de två gruppmedelvärdena, lwr och lov begränsade 95-procentigt konfidensintervall för den skillnaden, och p adj är p-värdet justerat för multipla jämförelser. Ett par skiljer sig signifikant när dess intervall exkluderar noll, motsvarande när p adj är under 0.05. I denna datauppsättning är jämförelserna som involverar gift 3 de signifikanta, vilket matchar boxplottet: grupp 3 har en klart lägre genomsnittlig överlevnadstid än grupperna 1 och 2, medan grupperna 1 och 2 är statistiskt oskiljbara från varandra.
Tvåvägs ANOVA
En tvåvägs ANOVA lägger till en andra faktor till formeln. Den fungerar precis som envägstestet, bara det att formeln ändras:
y ~ x1 + x2
Här är y den kvantitativa responsvariabeln, medan x1 och x2 båda är kategoriska faktorer.
Hypotes i tvåvägs ANOVA-test
- H0: Gruppmedelvärdena är lika för båda faktorvariablerna
- H1: Minst ett gruppmedelvärde skiljer sig åt, för minst en av de två faktorerna
Du lägger till variabeln behandling i modellen. Denna variabel registrerar den behandling som marsvinet fått. Den additiva formeln nedan testar om varje faktor påverkar överlevnadstiden på egen hand, efter att den andra har beaktats.
Justera koden genom att lägga till treat bredvid den första oberoende variabeln.
anova_two_way <- aov(time~poison + treat, data = df)
summary(anova_two_way)
Produktion:
##             Df Sum Sq Mean Sq F value  Pr(>F)
## poison       2 1.0330  0.5165   20.64 5.7e-07 ***
## treat        3 0.9212  0.3071   12.27 6.7e-06 ***
## Residuals   42 1.0509  0.0250
## ---
Båda p-värdena (5.7e⁻⁶ för gift och 6.7e⁻⁶ för behandling) ligger långt under 0.05, så du förkastar H0 för båda faktorerna och drar slutsatsen att en förändring av antingen giftet eller behandlingen påverkar överlevnadstiden.
Lägga till en interaktionsterm
Den additiva modellen ovan antar att giftets effekt är densamma oavsett behandling. För att testa detta antagande, ersätt plustecknet med en asterisk, vilket passar både huvudeffekterna och deras interaktion:
anova_interaction <- aov(time~poison * treat, data = df)
summary(anova_interaction)
Om raden för gift:behandling inte är signifikant är den additiva modellen det bättre valet eftersom den använder färre frihetsgrader.
ANOVA i R: Snabb testreferens
Tabellen nedan listar varje test som använts ovan, R-anropet som kör det och hypotesen som det utvärderar:
| Testa | Code | Hypotes | P-värde |
|---|---|---|---|
| Envägs ANOVA |
aov(y ~ X, data = df)
|
H1: Genomsnittet är olika för minst en grupp | 0.05 |
| Parvis |
TukeyHSD(ANOVA summary) |
0.05 | |
| Tvåvägs ANOVA |
aov(y ~ X1 + X2, data = df)
|
H1: Minst ett gruppmedelvärde skiljer sig åt för endera faktorn | 0.05 |
