
CSS-väljare in Selenium
 Krishna Rungta
⚡ Smart sammanfattning
CSS-väljare in Selenium är en kraftfull lokaliseringsstrategi som identifierar element med hjälp av HTML-taggar, ID:n, klasser, attribut och inre textmönster. Den här resursen förklarar varje CSS-selektortyp med steg-för-steg-exempel för Selenium ID.
Vad är en CSS-väljare i Selenium?
A CSS-väljare in Selenium är ett strängmönster som identifierar ett webbelement genom en kombination av HTML-tagg, id, klass och attribut. CSS-väljare är något mer avancerade än att lokalisera via ID eller namn, men de är den mest populära strategin bland erfarna användare. Selenium användare eftersom de kan nå element som inte har något ID- eller Name-attribut alls.
CSS-väljare i Selenium finns i många former, men den här guiden fokuserar på de fem vanligaste mönstren som används i Selenium ID:
- Tagg och ID
- Tagg och klass
- Tagg och attribut
- Tag, klass och attribut
- Inre text
När man använder den här strategin i Selenium IDE, alltid prefixet Target ruta med "css=” som visas i varje exempel nedan.
Varför använda CSS-selektorer i Selenium?
CSS-selektorer är den föredragna lokaliseringsstrategin för många Selenium automationsingenjörer eftersom de balanserar hastighet, flexibilitet och läsbarhet. Moderna webbapplikationer använder ofta dynamiskt genererade ID:n eller tar bort namnattribut helt och hållet, vilket gör att CSS-selektorer är det enda tillförlitliga sättet att rikta in sig på ett specifikt element på sidan.
De främsta fördelarna med att använda CSS-selektorer inkluderar:
- Prestanda: CSS-väljare bearbetas av webbläsarens inbyggda motor, så de körs snabbare än motsvarande XPath-uttryck, särskilt i äldre webbläsare som Internet Explorer.
- Flexibilitet: De kombinerar tagg, klass, attribut och logik för partiell matchning, vilket gör det möjligt för testare att rikta in sig på element som saknar ett stabilt ID.
- Läsbarhet: Syntaxen speglar hur utvecklare redan skriver CSS-regler, vilket förkortar inlärningskurvan för både QA-ingenjörer och front-end-team.
- Stabilitet mellan webbläsare: CSS-väljare fungerar konsekvent i hela Chrome, Firefox, Edge och Safari, vilket minskar risken för osäkra testfel.
Tagg och ID – CSS-väljare
Det här exemplet använder textrutan E-post på Facebooks inloggningssida. Elementet har ID:t ”e-mail", och det nåddes redan i avsnittet "Lokalisera via ID". Nu riktas samma element in med hjälp av en Selenium CSS-väljare med ID-attributet.
syntax
css=tag#id
- tag = HTML-taggen för det element som används
- # = hashtecknet, vilket alltid måste finnas när man använder en Selenium CSS-väljare med ID
- id = ID för elementet som nås
Tänk på att ID alltid föregås av ett hash-tecken (#).
Steg 1) Navigera till www.facebook.comAnvänd din webbläsares DevTools (eller ett äldre verktyg som Firebug) och kontrollera textrutan "E-post eller telefon".
Observera att HTML-taggen är "ingång” och dess ID är ”e-mail". Den kompletta CSS-väljaren blir därför "css=ingång#e-post".

Steg 2) Stiga på "css=ingång#e-post" in i Target Låda av Selenium IDE och klicka på knappen Sök. Selenium IDE markerar det matchande elementet på sidan.

Tagg och klass – CSS-väljare
En CSS-väljare i Selenium som använder en HTML-tagg och ett klassnamn följer samma idé som tagg och ID, men en punkt (.) ersätter hashtecknet.
syntax
css=tag.class
- tag = HTML-taggen för det element som används
- . = punkttecknet, vilket alltid måste finnas när man använder en CSS-selektor med klassen
- class = klassen för det element som nås
Steg 1) Öppna demosidan https://demo.guru99.com/test/facebook.html och granska textrutan ”E-post eller telefon”. Observera att HTML-taggen är ”ingång” och dess klass är ”inmatningstext".

Steg 2) In Selenium IDE, ange “css=input.inputtext"I Target rutan och klicka på Sök. Selenium IDE känner igen textrutorna e-post eller telefon.
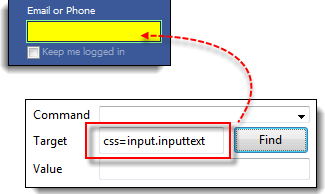
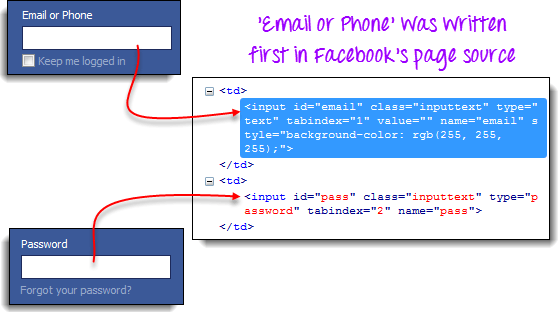
Observera att när flera element delar samma HTML-tagg och klass, känns endast det första matchande elementet i källkoden igen. Kontrollera textrutan Lösenord på samma sida och observera att den delar samma klass som textrutan E-post eller Telefon.

Endast textrutan E-post eller Telefon var markerad i föregående illustration eftersom den visas först i sidkällan.
Tagg och attribut – CSS-väljare
Den här strategin kombinerar en HTML-tagg med ett specifikt attribut som tillhör det element du vill komma åt.
syntax
css=tag[attribute=value]
- tag = HTML-taggen för det element som används
- [ och ] = hakparenteser som omsluter attributet och dess motsvarande värde
- attribut = attributet som ska användas. Välj ett som är unikt för elementet, till exempel namn eller id.
- värde = motsvarande värde för det valda attributet.
Steg 1) Navigera till Mercury Anmälningssida för turer https://demo.guru99.com/test/newtours/register.php och granska textrutan ”Efternamn”. Notera dess HTML-tagg (”input”) och dess namnattribut (”lastName”).

Steg 2) In Selenium IDE, ange “css=input[namn=efternamn]"I Target rutan och klicka på Sök. Selenium IDE har lyckats hitta fältet Efternamn.

När flera element delar samma HTML-tagg och attribut, känns endast det första igen. Beteendet är identiskt med att hitta element med samma tagg och klass.
Tagg, klass och attribut – CSS-väljare
syntax
css=tag.class[attribute=value]
- tag = HTML-taggen för det element som används
- . = punkttecknet, vilket alltid måste finnas när man använder en CSS-selektor med klassen
- class = klassen för det element som nås
- [ och ] = hakparenteser som omsluter ett specifikt attribut och dess motsvarande värde
- attribut = attributet som ska användas. Välj ett som är unikt för elementet, till exempel namn eller id.
- värde = motsvarande värde för det valda attributet.
Steg 1) Öppna demosidan https://demo.guru99.com/test/facebook.html och granska inmatningsrutorna ”E-post eller telefon” och ”Lösenord”. Notera deras HTML-tagg, klass och attribut. Det här exemplet använder ”flikindex"attributet".

Steg 2) Gå först till textrutan ”E-post eller telefon” med ett tabindex-värde på 1. Skriv in ”css=input.inputtext[tabindex=1]" in i Selenium Idus Target rutan och klicka på Sök. Fältet E-postadress eller Telefonnummer är markerat.

Steg 3) För att rikta in dig på lösenordsinmatningsrutan, ersätt helt enkelt tabindex-värdet. Ange “css=input.inputtext[tabindex=2]"I Target rutan och klicka på Sök. Selenium IDE har lyckats hitta textrutan Lösenord.

Inre text – CSS-väljare
HTML-etiketter får sällan id-, namn- eller klassattribut. Så hur kommer man åt dem i SeleniumSvaret finns genom deras inre text. Innertexter är de faktiska strängmönster som HTML-etiketten visar på sidan.
syntax
css=tag:contains("inner text")
- tag = HTML-taggen för det element som används
- inre text = elementets synliga textinnehåll
Steg 1) Navigera till Mercury Tours hemsida https://demo.guru99.com/test/newtours/ och granska etiketten ”Lösenord”. Notera dess HTML-tagg (”font” i det här fallet) och observera att elementet inte har några klass-, id- eller namnattribut.

Steg 2) Typ css=font:contains(“Lösenord:”) in Selenium Idus Target rutan och klicka på Sök. Selenium IDE lokaliserar lösenordsetiketten enligt nedan.

Steg 3) Den här gången, ersätt den inre texten med ”Boston” så att Target blir "css=font:innehåller("Boston")Klicka på Sök. Etiketten ”Boston till San Francisco” är markerad, vilket visar att Selenium IDE kan hitta en lång etikett även om bara det första ordet i dess inre text anges.

CSS-väljare kontra XPath i Selenium
Både CSS Selectors och XPath används för att identifiera webbelement i Selenium, men de har olika styrkor. Tabellen nedan jämför de två lokaliseringsstrategierna utifrån nyckeldimensioner:
| Kriterier | CSS-väljare | XPath |
|---|---|---|
| Fart | Snabbare, körs på webbläsarens inbyggda motor | Långsammare, särskilt i äldre webbläsare |
| Riktning | Endast vidarebefordran (förälder till barn) | Framåt och bakåt (barn till förälder) |
| syntax | Kortare och liknande CSS-regler | Längre, hierarkiska sökvägsuttryck |
| Textmatchning | Begränsad till pseudoklassen :contains() | Strong text() och contains() funktioner |
| Bäst för | Statiska layouter och moderna webbappar | Komplex DOM-traversering och textbaserade lokaliseringsverktyg |
Bästa praxis för att skriva CSS-selektorer i Selenium
Att skriva pålitliga CSS-selektorer går utöver att känna till syntaxen. Följande metoder hjälper testare att skapa stabila, underhållbara Selenium skript som överlever UI-ändringar:
- Föredra unika attribut: Välj alltid attributen id, data-test-id eller name som explicit läggs till för automatisering. Dessa förblir stabila även när den visuella layouten ändras.
- Undvik alltför kapslade selektorer: Långa kedjor som t.ex.
div > div > ul > li > agår lätt sönder när utvecklare omstrukturerar markupen. Håll selektorerna så korta som möjligt. - Använd partiella matchningar klokt: Mönster som
[class*="btn-primary"]tolererar små ändringar av klassnamn, men de kan också matcha oavsiktliga element. - Undvik indexbaserade positioner: Väljare som
nth-child(3)är ömtåliga eftersom tillägg av ett syskonelement förändrar varje position. - Validera selektorer i DevTools: Innan du springer en Selenium skript, klistra in väljaren i Chrome DevTools-konsolen med hjälp av
document.querySelector()för att bekräfta att den returnerar exakt ett element. - Kombinera attribut för unikhet: När en klass delas av många element, lägg till ett attributfilter som t.ex.
input.form-control[name="email"]att oklara målet. - Dokumentera och återanvänd: Centralisera selektorer inuti en Page Object-klass så att en enda uppdatering åtgärdar varje test som refererar till samma element.
Att följa dessa riktlinjer minskar flagnande egenskaper, förbättrar testkörningshastigheten och gör Selenium sviterna är enklare att underhålla med tiden.
Sammanfattning: Snabbreferens för CSS-selektorsyntax
Tabellen nedan sammanställer alla Selenium CSS Selector-mönster som behandlas i den här guiden:
| Metod | Target syntax | Exempelvis |
|---|---|---|
| Tagg och ID | css=tag#id | css=ingång#e-post |
| Tagg och klass | css=tag.klass | css=input.inputtext |
| Tagg och attribut | css=tag[attribut=värde] | css=input[namn=efternamn] |
| Tag, klass och attribut | css=tag.klass[attribut=värde] | css=input.inputtext[tabindex=1] |
| Inre text | css=tagg:innehåller("text") | css=font:contains(“Lösenord:”) |
