
Apache Oozie Handledning: Arbetsflödesdiagram, Schemaläggare
 Prafulla Ranadive
⚡ Smart sammanfattning
Apache Oozie är arbetsflödesschemaläggaren för Hadoop som kör beroende jobb som riktade acykliska grafer, och kombinerar en arbetsflödesmotor för MapReduce-, Pig- och Hive-åtgärder med en koordinatormotor som drivs av tid och datatillgänglighet.
Vad är Apache Oozie?
Apache Oozie är en arbetsflödesschemaläggare för HadoopDet är ett system som kör arbetsflödet för beroende jobb. Här kan användare skapa riktade acykliska grafer av arbetsflöden, vilka kan köras parallellt och sekventiellt i Hadoop.
Den består av två delar:
- Arbetsflödesmotor: En arbetsflödesmotors ansvar är att lagra och köra arbetsflöden som består av Hadoop-jobb, t.ex. MapReduce, Pig, Bikupa.
- Koordinatormotor: Den kör arbetsflödesjobb baserat på fördefinierade scheman och tillgänglighet av data.
Oozie är skalbart och kan hantera den snabba exekveringen av tusentals arbetsflöden (vart och ett bestående av dussintals jobb) i ett Hadoop-kluster. Diagrammet nedan visar var schemaläggaren sitter i förhållande till klustret och de jobb den driver.

Oozie är också väldigt flexibelt. Man kan enkelt starta, stoppa, pausa och köra om jobb. Oozie gör det väldigt enkelt att köra om misslyckade arbetsflöden. Man kan lätt förstå hur svårt det kan vara att komma ikapp missade eller misslyckade jobb på grund av driftstopp eller fel. Det är till och med möjligt att hoppa över en specifik misslyckad nod.
Projektstatus: Apache Oozie har pensionerats av Apache Software Foundation i februari 2025 och flytten till Apache-vinden färdigställdes i april 2025. Den slutgiltiga versionen är fortfarande 5.2.1 från februari 2021, och källkodsförrådet är nu skrivskyddat. Befintliga kluster kör det fortfarande, vilket är anledningen till att mekaniken nedan är värd att känna till, men nya pipelines byggs normalt på Apache Airflow.
Hur fungerar Oozie?
Oozie körs som en tjänst i klustret, och klienter skickar in arbetsflödesdefinitioner för omedelbar eller senare bearbetning.
Ett Oozie-arbetsflöde består av åtgärdsnoder och kontrollflödesnoder.
En åtgärdsnod representerar en arbetsflödesuppgift, t.ex. att flytta filer till HDFS, kör ett MapReduce-, Pig- eller Hive-jobb, importerar data med hjälp av Sqoop, eller köra ett shellskript eller ett program skrivet i Java.
En kontrollflödesnod styr arbetsflödeskörningen mellan åtgärder genom att tillåta konstruktioner som villkorlig logik, där olika grenar kan följas beroende på resultatet av en tidigare åtgärdsnod.
Startnod, slutnod och felnod faller under denna kategori av noder.
- Starta nod anger början av arbetsflödesjobbet.
- Slutnod signalerar slutet på jobbet.
- Felnod anger förekomsten av ett fel och motsvarande felmeddelande som ska skrivas ut.
I slutet av ett arbetsflödes exekvering används en HTTP-återanrop av Oozie för att uppdatera klienten med arbetsflödets status. Återgång till eller utgång från en åtgärdsnod kan också utlösa återanropet.
Oozie-kontrollnoder och åtgärdstyper
Utöver start, slut och fel stöder arbetsflödets XML ett litet ordförråd av kontrollnoder som formar grafen.
- beslut: Utvärderar ett uttryck och skickar arbetsflödet nerför en av flera grenar, motsvarande en switch-sats.
- gaffel: Delar upp banan så att två eller fler åtgärder körs parallellt.
- Ansluta sig: Väntar på att varje gren i en matchande förgrening ska vara klar innan den fortsätter.
- döda: Avslutar arbetsflödet omedelbart och registrerar felmeddelandet.
Åtgärdsnoder täcker själva arbetet, och var och en har sitt eget XML-element:
- map-reduce, pig, hive och sqoop åtgärder startar motsvarande Hadoop-jobb.
- Java kör en huvudklass på klustret; skal och ssh köra skript.
- fs utför HDFS-hushållningping såsom flytta, radera, mkdir och chmod.
- e-mail meddelar mottagarna, och underarbetsflöde anropar ett annat arbetsflödesprogram.
Exempel på arbetsflödesdiagram
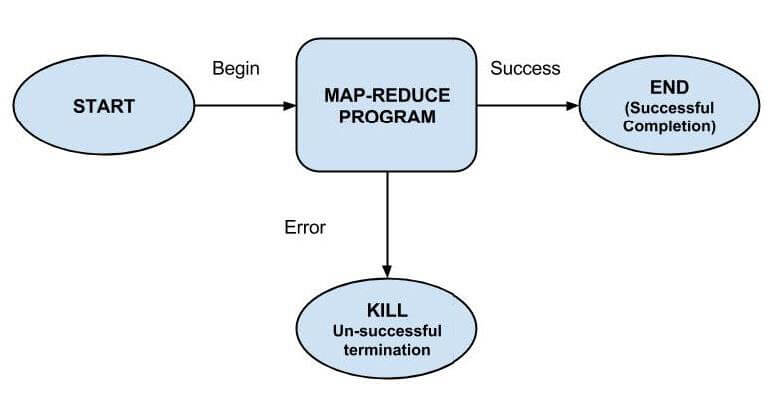
Diagrammet nedan tracskapar ett litet arbetsflöde från startnoden, via en MapReduce-åtgärd, till antingen slutnoden eller felsökvägen när åtgärden misslyckas.
Typer av Oozie-jobb
Oozie beskriver arbete på tre nivåer. Varje lager omsluter det underliggande, så ett paket styr i slutändan många individuella arbetsflöden.
| Jobbtyp | Vad det definierar | Triggad av |
|---|---|---|
| Arbetsflöde | En riktad acyklisk graf över aktions- och kontrollnoder, skriven i workflow.xml | Manuell inlämning, eller en koordinator |
| Samordnare | Ett återkommande schema för ett arbetsflöde, med starttid, sluttid och frekvens | Klocktid och tillgänglighet av indata |
| Bunt | En samling koordinatorapplikationer som hanteras tillsammans som en enda datapipeline | En starttid tillämpad på alla dess koordinatorer |
Skillnaden spelar roll i praktiken: ett arbetsflöde svarar på "vad som körs", en koordinator svarar på "när det körs" och ett paket svarar på "vad som börjar och slutar tillsammans".
Paketering och distribution av ett Oozie Workflow-program
En arbetsflödesapplikation består av arbetsflödesdefinitionen och alla tillhörande resurser, såsom MapReduce Jar-filer, Pig-skript etc. Applikationer måste följa en enkel katalogstruktur och distribueras till HDFS så att Oozie kan komma åt dem.
Ett exempel på en katalogstruktur visas nedan:
<name of workflow>/
├── lib/
│   └── hadoop-examples.jar
└── workflow.xml
Det är nödvändigt att behålla workflow.xml (en arbetsflödesdefinitionsfil) i den översta katalogen (den överordnade katalogen som innehåller arbetsflödesnamnet). Lib-katalogen innehåller Jar-filer som innehåller MapReduce-klasser. En arbetsflödesapplikation som följer denna layout kan byggas med vilket byggverktyg som helst, t.ex. Ant eller Maven.
En sådan build behöver kopieras till HDFS med ett kommando, till exempel:
% hadoop fs -put hadoop-examples/target/<name of workflow dir> name of workflow
Steg för att köra ett Oozie-arbetsflödesjobb
I det här avsnittet kommer vi att se hur man kör ett arbetsflödesjobb. För att köra detta kommer vi att använda kommandoradsverktyget Oozie (ett klientprogram som kommunicerar med Oozie-servern).
1. Exportera OOZIE_URL miljövariabel, som anger för oozie-kommandot vilken Oozie-server som ska användas (här använder vi en som körs lokalt):
% export OOZIE_URL="http://localhost:11000/oozie"
2. Kör arbetsflödesjobbet med:
% oozie job -config ch05/src/main/resources/max-temp-workflow.properties -run
Alternativet -config hänvisar till en lokal Java egenskapsfilen som innehåller definitioner för parametrarna i XML-filen för arbetsflödet, samt oozie.wf.application.path, som talar om för Oozie var arbetsflödesapplikationen finns i HDFS.
Exempel på innehåll i egenskapsfilen:
nameNode=hdfs://localhost:8020
jobTracker=localhost:8021
oozie.wf.application.path=${nameNode}/user/${user.name}/<name of workflow>
3. Hämta statusen för arbetsflödesjobbet.
Status för ett arbetsflödesjobb kan ses med hjälp av underkommandot 'job' med alternativet '-info', där jobb-ID:t anges efter '-info'.
e.g., % oozie job -info <job id>
Utdata visar en status som är antingen KÖRANDE, AVSTÖDDA eller LYCKADES.
4. Resultat av lyckat arbetsflödeskörning kan ses med ett Hadoop-kommando som:
% hadoop fs -cat <location of result>
Varför använda Oozie?
Huvudsyftet med att använda Oozie är att hantera olika typer av jobb som bearbetas i ett Hadoop-system.
Beroenden mellan jobb specificeras av en användare i form av riktade acykliska grafer. Oozie konsumerar denna information och hanterar deras exekvering i rätt ordning enligt angivna arbetsflöden. På så sätt sparas användarens tid för att hantera ett komplett arbetsflöde. Dessutom har Oozie en möjlighet att ange exekveringsfrekvensen för ett visst jobb.
Funktioner hos Oozie
- Oozie har ett klient-API och ett kommandoradsgränssnitt som kan användas för att starta, kontrollera och övervaka jobb från en Java ansökan.
- Med hjälp av dess webbtjänst-API:er kan man styra jobb varifrån som helst.
- Oozie har en bestämmelse om att utföra jobb som är schemalagda att köras regelbundet.
- Oozie har en möjlighet att skicka e-postmeddelanden när jobb är slutförda.
Oozie vs Apache Airflow
Eftersom Oozie är pensionerad jämför de flesta team som utvärderar en schemaläggare idag vad de redan kör mot Apache Airflow. De två verktygen löser samma problem från motsatta håll.
| Aspect | Apache Oozie | Apache luftflöde |
|---|---|---|
| Definitionsspråk | Arbetsflöden skrivna som XML | DAG:er skrivna som Python koda |
| Omfattning | Byggt kring Hadoop-åtgärder som MapReduce, Pig, Hive och Sqoop | Allmänt ändamål, med operatörer för molntjänster, databaser och containrar |
| Schemaläggning | Koordinatorjobb drivna av tid och datatillgänglighet | Schemalägg intervall plus sensorer som väntar på externa förhållanden |
| Projektstatus | Pensionerades till Apache Attic år 2025; slutgiltig utgåva 5.2.1 | Aktivt utvecklat Apache-projekt på toppnivå |
Oozie är fortfarande det enklare alternativet på ett kluster som redan kör det, eftersom åtgärderna mappas en-till-en på Hadoop-komponenter. Luftflöde är det praktiska valet för allt nytt, särskilt där en pipeline når bortom Hadoop.
