
Hash-tabell i datastruktur: Python Exempelvis
 Sarah Chen
⚡ Smart sammanfattning
Hashtabellen i datastrukturen lagrar värden som nyckel-värdepar, och använder en hashfunktion för att mappa varje nyckel till ett index för snabb sökning. Den här resursen förklarar hashfunktioner, kollisioner, kedjning, probning, operationer och Python exempel inklusive den inbyggda ordboken.
Vad är Hashing?
En hash är ett värde som har en fast längd, och det genereras med hjälp av en matematisk formel. Hashvärden används vid datakomprimering, kryptologi etc. Vid dataindexering används hashvärden eftersom de har fast längdstorlek oavsett vilka värden som användes för att generera dem. Det gör att hashvärden tar minimalt med utrymme jämfört med andra värden av varierande längd.
En hashfunktion använder en matematisk algoritm för att omvandla nyckeln till en hash. En kollision uppstår när en hashfunktion producerar samma hashvärde för mer än en nyckel.
Vad är en Hash-tabell?
A HASH TABELL är en datastruktur som lagrar värden med hjälp av ett par nycklar och värden. Varje värde tilldelas en unik nyckel som genereras med hjälp av en hashfunktion.
Namnet på nyckeln används för att komma åt dess tillhörande värde. Detta gör det mycket snabbt att söka efter värden i en hashtabell, oavsett antalet objekt i hashtabellen.
Hash-funktioner
Till exempel, om vi vill lagra personalposter och varje anställd identifieras unikt med hjälp av ett anställdsnummer.
Vi kan använda medarbetarnumret som nyckel och tilldela personaldata som värde.
Ovanstående tillvägagångssätt kommer att kräva extra ledigt utrymme i storleksordningen (m * n2) där variabeln m är storleken på array, och variabeln n är antalet siffror för anställds nummer. Detta tillvägagångssätt introducerar ett problem med lagringsutrymme.
En hashfunktion löser ovanstående problem genom att hämta anställningsnumret och använda det för att generera ett hash-heltal, fasta siffror och optimera lagringsutrymmet. Syftet med en hashfunktion är att skapa en nyckel som ska användas för att referera till det värde vi vill lagra. Funktionen accepterar värdet som ska sparas och använder sedan en algoritm för att beräkna nyckelns värde.
Följande är ett exempel på en enkel hashfunktion
h(k) = k1 % m
HÄR,
- h(k) är hashfunktionen som accepterar en parameter k. Parametern k är värdet som vi vill beräkna nyckeln för.
- k1 % m är algoritmen för vår hashfunktion där k1 är värdet vi vill lagra och m är storleken på listan. Vi använder moduloperatorn för att beräkna nyckeln.
Exempelvis
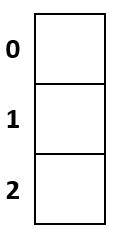
Låt oss anta att vi har en lista med en fast storlek på 3 och följande värden
[1,2,3]
Vi kan använda ovanstående formel för att beräkna de positioner som varje värde ska uppta.
Följande bild visar de tillgängliga indexen i vår hashtabell.
Steg 1) Beräkna positionen som kommer att upptas av det första värdet som så
h(1) = 1 % 3
= 1
Värdet 1 kommer att ockupera utrymmet på index 1
Steg 2) Beräkna positionen som kommer att upptas av det andra värdet
h(2) = 2 % 3
= 2
Värdet 2 kommer att ockupera utrymmet på index 2
Steg 3) Beräkna positionen som kommer att upptas av det tredje värdet.
h(3) = 3 % 3
= 0
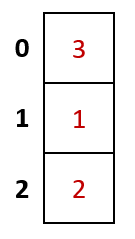
Värdet 3 kommer att ockupera utrymmet på index 0
SLUTRESULTAT
Vår ifyllda hashtabell blir nu som följer.
Egenskaper hos en bra hashfunktion
En bra hashfunktion bör ha följande egenskaper.
- Formeln för att generera hashen bör använda datans värde som ska lagras i algoritmen.
- Hashfunktionen ska generera unika hashvärden även för indata som har samma mängd.
- Funktionen ska minimera antalet kollisioner. Kollisioner uppstår när samma värde genereras för mer än ett värde.
- Värdena måste fördelas konsekvent över alla möjliga hash.
kollision
En kollision uppstår när algoritmen genererar samma hash för mer än ett värde.
Låt oss titta på ett exempel.
Anta att vi har följande lista med värden
[3,2,9,11,7]
Låt oss anta att storleken på hashtabellen är 7, och vi kommer att använda formeln (k1 % m) där m är storleken på hashtabellen.
Följande tabell visar hash-värdena som kommer att genereras.
| Nyckel | Hash-algoritm (k1 % m) | Hashvärde |
|---|---|---|
| 3 | 3 % 7 | 3 |
| 2 | 2 % 7 | 2 |
| 9 | 9 % 7 | 2 |
| 11 | 11 % 7 | 4 |
| 7 | 7 % 7 | 0 |
Som vi kan se från ovanstående resultat har värdena 2 och 9 samma hashvärde, och vi kan inte lagra mer än ett värde vid varje position.
Det givna problemet kan lösas genom att antingen använda kedja eller sondering. Följande avsnitt diskuterar kedja och sondering i detalj.
Kedjning
Chaining är en teknik som används för att lösa problemet med kollision genom att använda länkade listor som var och en har unika index.
Följande bild visualiserar hur en kedjad lista ser ut
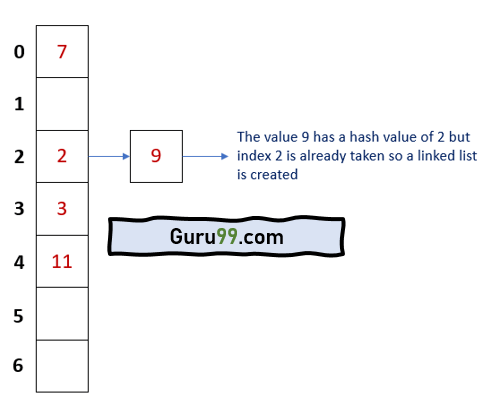
Både 2 och 9 upptar samma index, men de lagras som länkade listor. Varje lista har en unik identifierare.
Fördelar med kedjade listor
Följande är fördelarna med kedjade listor:
- Kedjelistor har bättre prestanda vid infogning av data eftersom infogningsordningen är O(1).
- Det är inte nödvändigt att ändra storlek på en hashtabell som använder en kedjad lista.
- Den kan enkelt rymma ett stort antal värden så länge det finns ledigt utrymme.
sondering
Den andra tekniken som används för att lösa kollision är sondering. När vi använder sonderingsmetoden, om en kollision inträffar, kan vi helt enkelt gå vidare och hitta en tom lucka för att lagra vårt värde.
Följande är metoderna för sondering:
| Metod | BESKRIVNING |
|---|---|
| Linjär sondering | Precis som namnet antyder söker den här metoden efter tomma platser linjärt med start från den position där kollisionen inträffade och framåt. Om slutet av listan nås och ingen tom plats hittas. Sonderningen börjar i början av listan. |
| Kvadratisk sondering | Denna metod använder kvadratiska polynomuttryck för att hitta nästa tillgängliga lediga plats. |
| Double hashing | Denna teknik använder en sekundär hashfunktionsalgoritm för att hitta nästa lediga tillgängliga slot. |
Med vårt exempel ovan skulle hashtabellen efter att ha använt sondering se ut som följer:

Hash-tabelloperationer
Här är Operationer som stöds av Hash-tabeller:
- Införande - det här Operation används för att lägga till ett element i hashtabellen
- Söka - det här Operation används för att söka efter element i hashtabellen med hjälp av nyckeln
- Radera - det här Operation används för att ta bort element från hashtabellen
Infoga data operation
Insert-operationen används för att lagra värden i hashtabellen. När ett nytt värde lagras i hashtabellen tilldelas det ett indexnummer. Indextalet beräknas med hjälp av hash-funktionen. Hashfunktionen löser eventuella kollisioner som uppstår vid beräkning av indextalet.
Sök efter datadrift
Sökoperationen används för att slå upp värden i hashtabellen med hjälp av indexnumret. Sökoperationen returnerar värdet som är kopplat till sökindexnumret. Om vi till exempel lagrar värdet 6 vid index 2, kommer sökoperationen med indexnummer 2 att returnera värdet 6.
Ta bort dataoperation
Raderingsoperationen används för att ta bort ett värde från en hashtabell. För att ta bort Operationen görs med hjälp av indexnumret. När ett värde har raderats frigörs indexnumret. Den kan användas för att lagra andra värden med hjälp av infogningsoperationen.
Hash-tabellimplementering med Python Exempelvis
Låt oss titta på ett enkelt exempel som beräknar hashvärdet för en nyckel
def hash_key( key, m):
    return key % m


m = 7

print(f'The hash value for 3 is {hash_key(3,m)}')
print(f'The hash value for 2 is {hash_key(2,m)}')
print(f'The hash value for 9 is {hash_key(9,m)}')
print(f'The hash value for 11 is {hash_key(11,m)}')
print(f'The hash value for 7 is {hash_key(7,m)}')
Hash-bord Code Förklaring
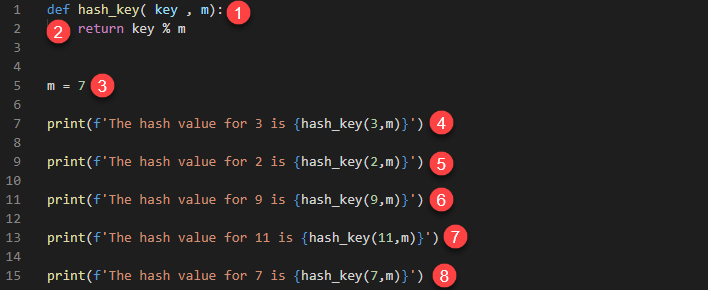
HÄR,
- Definierar en funktion hash_key som accepterar parametrarna nyckel och m.
- Använder en enkel moduloperation för att bestämma hashvärdet
- Definierar en variabel m som initieras till värdet 7. Detta är storleken på vår hashtabell
- Beräknar och skriver ut hashvärdet på 3
- Beräknar och skriver ut hashvärdet på 2
- Beräknar och skriver ut hashvärdet på 9
- Beräknar och skriver ut hashvärdet på 11
- Beräknar och skriver ut hashvärdet på 7
Att köra ovanstående kod ger följande resultat.
The hash value for 3 is 3
The hash value for 2 is 2
The hash value for 9 is 2
The hash value for 11 is 4
The hash value for 7 is 0
Python Ordboksexempel
Python levereras med en inbyggd datatyp som heter Dictionary. En ordbok är ett exempel på en hashtabell. Den lagrar värden med hjälp av ett par nycklar och värden. Hashvärdena genereras automatiskt åt oss och eventuella kollisioner löses åt oss i bakgrunden.
Följande exempel visar hur du kan använda en ordboksdatatyp i python 3
employee = {
    'name': 'John Doe',
    'age': 36,
    'position': 'Business Manager.'
}

print (f"The name of the employee is {employee['name']}")
employee['position'] = 'Software Engineer'
print (f"The position of {employee['name']} is {employee['position']}")
employee.clear()

print (employee)
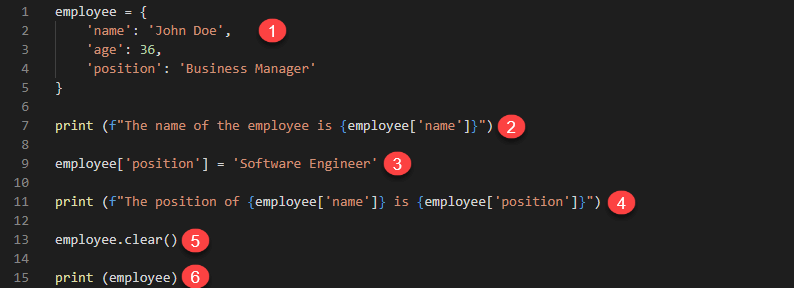
HÄR,
- Definierar en ordboksvariabel anställd. Nyckelnamnet används för att lagra värdet John Doe, ålder lagrar 36, och position lagrar värdet Business Manager.
- Hämtar värdet på nyckelnamnet och skriver ut det i terminalen
- Uppdaterar nyckelpositionens värde till värdet Software Engineer
- Skriver ut värdena för nycklarnas namn och position
- Tar bort alla värden som finns lagrade i vår ordboksvariabelanställd
- Skriver ut anställds värde
Att köra ovanstående kod ger följande resultat.
The name of the employee is John Doe.
The position of John Doe is a Software Engineer.
{}
Komplexitetsanalys
Hash-tabeller har en genomsnittlig tidskomplexitet på O (1) i bästa fall. Den värsta tidskomplexiteten är O(n). Det värsta scenariot inträffar när många värden genererar samma hash-nyckel och vi måste lösa kollisionen genom att sondera.
Verkliga applikationer
I den verkliga världen används hashtabeller för att lagra data för
- Databaser
- Associativa matriser
- uppsättningar
- Minne cache
Fördelar med hashtabeller
Här är fördelar/fördelar med att använda hashtabeller:
- Hash-tabeller har hög prestanda när du letar upp data, infogar och tar bort befintliga värden.
- Tidskomplexiteten för hashtabeller är konstant oavsett antalet objekt i tabellen.
- De presterar mycket bra även när de arbetar med stora datamängder.
Nackdelar med hashtabeller
Här är nackdelarna med att använda hashtabeller:
- Du kan inte använda ett nollvärde som nyckel.
- Kollisioner kan inte undvikas när nycklar genereras med hjälp av. hashfunktioner. Kollisioner uppstår när en nyckel som redan används genereras.
- Om hashfunktionen har många kollisioner kan detta leda till att prestandan minskar.
