
ETL (Extract, Transformera och Ladda) Process i ett datalager
 David Carter
Smart sammanfattning
ETL (Extrac(t, Transformera och Ladda) Processen i datalager beskriver det systematiska flödet av dataförflyttning från flera heterogena källor till ett centraliserat arkiv. Den säkerställer konsekvens, noggrannhet och databeredskap för analys genom strukturerade extraction, transformation och optimerade laddningsmekanismer.
Vad är ETL?
ETL är en process som extrachämtar data från olika källsystem, transformerar sedan data (som att tillämpa beräkningar, sammanfogningar etc.) och laddar slutligen data till datalagersystemet. Den fullständiga formen av ETL är Extract, Transformera och Ladda.
Det är frestande att tro att skapandet av ett datalager helt enkelt innebär extrachämta data från flera källor och ladda in dem i en databas. I verkligheten kräver det dock en komplex ETL-process. ETL-processen kräver aktiva insatser från olika intressenter, inklusive utvecklare, analytiker, testare och toppchefer, och är tekniskt utmanande.
För att bibehålla sitt värde som ett verktyg för beslutsfattare måste datalagersystemet förändras i takt med affärsförändringar. ETL är en återkommande aktivitet (dagligen, veckovis eller månadsvis) i ett datalagersystem och behöver vara agilt, automatiserat och väldokumenterat.


Varför behöver du ETL?
Det finns många anledningar till att anta ETL i organisationen:
- Det hjälper företag att analysera sina affärsdata för att fatta viktiga affärsbeslut.
- Transaktionsdatabaser kan inte besvara komplexa affärsfrågor som kan besvaras med ett ETL-exempel.
- Ett datalager tillhandahåller ett gemensamt datalager
- ETL tillhandahåller en metod för att flytta data från olika källor till ett datalager.
- Allt eftersom datakällor ändras uppdateras datalagret automatiskt.
- Ett väl utformat och dokumenterat ETL-system är nästan avgörande för att ett datalagerprojekt ska lyckas.
- Tillåt verifiering av regler för datatransformation, aggregering och beräkning.
- ETL-processen möjliggör jämförelse av exempeldata mellan käll- och målsystemet.
- ETL-processen kan utföra komplexa transformationer och kräver ett extra område för att lagra data.
- ETL hjälper till att migrera data till ett datalager och konvertera olika format och typer till ett enhetligt system.
- ETL är en fördefinierad process för att komma åt och manipulera källdata till måldatabasen.
- ETL i ett datalager erbjuder en djupgående historisk kontext för verksamheten.
- Det bidrar till att förbättra produktiviteten eftersom det kodifierar och återanvänder utan behov av tekniska färdigheter.
Med en tydlig förståelse för ETL:s värde, låt oss dyka in i trestegsprocessen som får allt att fungera.
ETL-process i datalager
ETL är en 3-stegsprocess
Steg 1) Exempeltraction
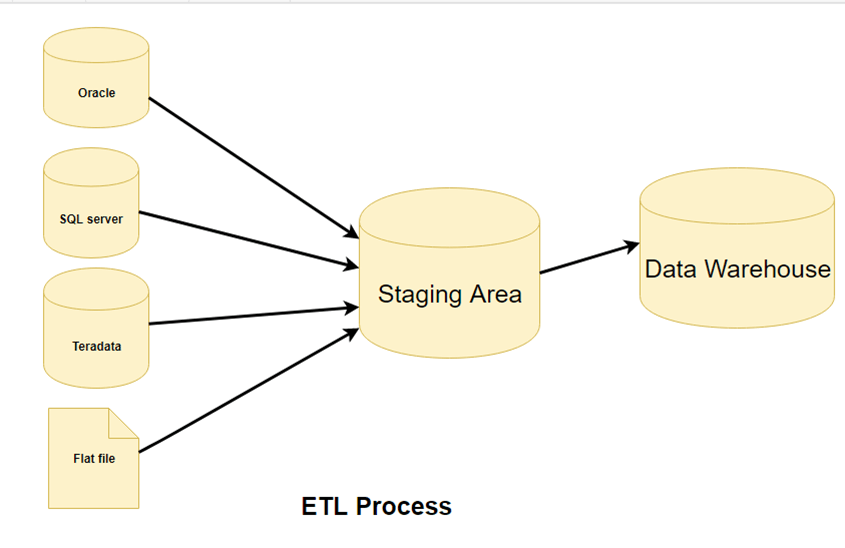
I detta steg av ETL-arkitekturen existerar datatracfrån källsystemet till staging-området. Transformationer, om några, görs i staging-området så att källsystemets prestanda inte försämras. Om korrupt data kopieras direkt från källan till datalagrets databas kommer återställning att vara en utmaning. Staging-området ger en möjlighet att validera extractestad data innan den flyttas till datalagret.
Datalagret behöver integrera system som har olika DBMS, hårdvara, Operasystem och kommunikationsprotokoll. Källor kan bland annat inkludera äldre applikationer som stordatorer, anpassade applikationer, kontaktpunkter som bankomater, samtalsväxlar, textfiler, kalkylblad, ERP, data från leverantörer och partners.
Därför behöver man en logisk datakarta innan data existerartracted och fysiskt laddad. Denna datakarta beskriver förhållandet mellan källor och måldata.
Tre dataexempeltracmetoder:
- Fullständig Extraction
- Delvis extraction- utan uppdateringsmeddelande.
- Delvis extraction- med uppdateringsmeddelande
Oavsett vilken metod som används, t.ex.traction bör inte påverka källsystemens prestanda och svarstid. Dessa källsystem är liveproduktionsdatabaser. Eventuell nedgång eller låsning kan påverka företagets resultat.
Vissa valideringar görs under Extraction:
- Stämma av poster med källdata
- Se till att ingen spam/oönskad data laddas
- Kontroll av datatyp
- Ta bort alla typer av duplicerade/fragmenterade data
- Kontrollera om alla nycklar sitter på plats.
Steg 2) Transformation
DataextracData som hämtas från källservern är rå och inte användbar i sin ursprungliga form. Därför behöver den rensas, mappas och transformeras. Faktum är att detta är det viktigaste steget där ETL-processen tillför värde och ändrar data så att insiktsfulla BI-rapporter kan genereras.
Det är ett av de viktiga ETL-koncepten där man tillämpar en uppsättning funktioner på t.ex.tracted data. Data som inte kräver någon transformation kallas direkt rörelse or genomgångsdata.
I transformationssteget kan du utföra anpassade operationer på data. Till exempel om användaren vill ha summan av försäljningsintäkter som inte finns i databasen. Eller om förnamnet och efternamnet i en tabell finns i olika kolumner. Det är möjligt att sammanfoga dem innan laddning.

Följande är data Integrity Problem:
- Olika stavningar av samma person, som Jon, John, etc.
- Det finns flera sätt att beteckna ett företagsnamn, som till exempel Google, Google Inc.
- Användning av olika namn som Cleaveland och Cleveland.
- Det kan förekomma fall där olika kontonummer genereras av olika applikationer för samma kund.
- I vissa fall förblir de filer som krävs tomma
- Ogiltig produkt hämtad vid kassan, eftersom manuell inmatning kan leda till misstag.
Valideringar görs under detta skede
- Filtrering – Välj bara vissa kolumner att ladda
- Använda regler och uppslagstabeller för datastandardisering
- Character Set Conversion och kodningshantering
- Konvertering av måttenheter, som datum- och tidskonverteringar, valutakonverteringar, numeriska konverteringar etc.
- Kontroll av validering av datatröskelvärde. Till exempel kan ålder inte vara mer än två siffror.
- Dataflödesvalidering från mellanlagringsområdet till mellantabellerna.
- Obligatoriska fält ska inte lämnas tomma.
- Rengöring (till exempel kartaping NULL till 0 eller Kön Man till "M" och Kvinna till "F", etc.)
- Dela upp en kolumn i flera kolumner och sammanfoga flera kolumner till en enda kolumn.
- Transponera rader och kolumner,
- Använd uppslagningar för att slå samman data
- Använda komplex datavalidering (t.ex. om de två första kolumnerna i en rad är tomma, avvisas raden automatiskt från bearbetning)
Steg 3) Laddar
Att ladda data till måldatabasen för datalagret är det sista steget i ETL-processen. I ett typiskt datalager måste en enorm mängd data laddas under en relativt kort period (nätter). Därför bör laddningsprocessen optimeras för prestanda.
Vid belastningsfel bör återställningsmekanismer konfigureras för att starta om från felpunkten utan förlust av dataintegritet. Datalageradministratörer måste övervaka, återuppta och avbryta belastningar i enlighet med rådande serverprestanda.
Typer av laddning:
- Initial belastning — fylla i alla datalagertabeller
- Inkrementell belastning — tillämpa löpande förändringar vid behov med jämna mellanrum.
- Fullständig uppdatering — radera innehållet i en eller flera tabeller och ladda om med färska data.
Ladda verifiering
- Se till att nyckelfältsdata varken saknas eller är null.
- Testa modelleringsvyer baserat på måltabellerna.
- Kontrollera de kombinerade värdena och beräknade måtten.
- Datakontroller i dimensionstabellen såväl som i historiktabellen.
- Kontrollera BI-rapporterna på den inlästa fakta- och dimensionstabellen.
ETL-pipelining och parallell bearbetning
ETL-pipelining möjliggör extraction, transformation och laddning ska ske samtidigt istället för sekventiellt. Så snart en del av data existerartracted, den transformeras och laddas medan ny data extractionen fortsätter. Detta parallell behandling förbättrar prestandan avsevärt, minskar driftstopp och maximerar systemresursutnyttjandet.
Denna parallella bearbetning är avgörande för realtidsanalys, storskalig dataintegration och molnbaserade ETL-system. Genom överlappningping uppgifter, pipelined ETL säkerställer snabbare dataflytt, högre effektivitet och mer konsekvent dataleverans för moderna företag.
Hur AI förbättrar moderna ETL-pipelines?
Artificiell intelligens revolutjoniserar ETL genom att göra datapipelines anpassningsbara, intelligenta och självoptimerande. AI-algoritmer kan automatiskt mappa scheman, upptäcka avvikelser och förutsäga transformationsregler utan manuell konfiguration. Detta gör det möjligt för ETL-arbetsflöden att hantera föränderliga datastrukturer utan ansträngning samtidigt som datakvaliteten bibehålls.
Moderna AI-förbättrade ETL-plattformar utnyttjar tekniker som AutoML för automatisk funktionsutveckling och NLP-driven schemakartläggning.ping som förstår semantiska relationer mellan fält och algoritmer för avvikelsedetektering som identifierar problem med datakvaliteten i realtid. Dessa funktioner minskar avsevärt den manuella ansträngning som traditionellt krävs vid ETL-utveckling och underhåll.
Maskininlärning förbättrar prestandajusteringen, vilket säkerställer snabbare och mer exakt dataintegration. Genom att introducera automatisering och prediktiv intelligens levererar AI-driven ETL realtidsinsikter och driver större effektivitet över moln- och hybriddataekosystem.
För att implementera de koncept som diskuterats ovan förlitar sig organisationer på specialiserade ETL-verktyg. Här är några av de ledande alternativen som finns tillgängliga på marknaden.
ETL-verktyg
Det finns många ETL-verktyg tillgängliga på marknaden. Här är några av de mest framträdande:
1. MarkLogic:
MarkLogic är en datalagerlösning som gör dataintegration enklare och snabbare med hjälp av en rad företagsfunktioner. Den kan fråga olika typer av data som dokument, relationer och metadata.
https://www.marklogic.com/product/getting-started/
2. Oracle:
Oracle är den branschledande databasen. Den erbjuder ett brett utbud av datalagerlösningar för både lokal drift och molndrift. Den hjälper till att optimera kundupplevelserna genom att öka den operativa effektiviteten.
https://www.oracle.com/index.html
3. Amazon RötShift:
Amazon Redshift är ett datalagerverktyg. Det är ett enkelt och kostnadseffektivt verktyg för att analysera alla typer av data med hjälp av standard SQL och befintliga BI-verktyg. Det tillåter också att köra komplexa frågor mot petabyte av strukturerad data.
https://aws.amazon.com/redshift/?nc2=h_m1
Här är en komplett lista med användbara datalagerverktyg.
Bästa praxis för ETL-processen
Följande är de bästa metoderna för ETL-processsteg:
- Försök aldrig rensa all data:
Alla organisationer skulle vilja ha all data ren, men de flesta är inte redo att betala för att vänta, eller är inte redo att vänta. Att rensa allt skulle helt enkelt ta för lång tid, så det är bättre att inte försöka rensa all data. - Balansera städning med affärsprioriteringar:
Undvik att överrensa all data, men se till att kritiska fält och fält med hög påverkan rensas för att säkerställa tillförlitlighet. Fokusera rensningsinsatserna på dataelement som direkt påverkar affärsbeslut och rapporteringsnoggrannhet. - Bestäm kostnaden för att rensa data:
Innan du rengör alla smutsiga data är det viktigt för dig att bestämma rengöringskostnaden för varje smutsigt dataelement. - För att påskynda frågebehandlingen, ha hjälpvyer och index:
För att minska lagringskostnaderna, lagra sammanfattade data på diskband. Dessutom krävs en avvägning mellan mängden data som ska lagras och dess detaljerade användning. Avvägning på nivån av granularitet för data för att minska lagringskostnaderna.
