
Datalager Architecture, Komponenter & Diagram Concepts
 Redaktionellt team
⚡ Smart sammanfattning
Datalager ArchiTektur definierar hur historisk och kumulativ data från många källor organiseras i nivåer och sammankopplade komponenter, vilket möjliggör tillförlitlig rapportering, analys och en enda version av sanningen för organisatoriskt beslutsfattande och prognostisering.
Datalager Concepts
A datalagret finns för att ge ett företag en enda version av sanningen för beslutsfattande och prognoser. Det är ett informationssystem som innehåller historiska och kumulativa data hämtade från en eller flera källor.
Genom att organisera data för analys snarare än transaktioner förenklar ett datalager rapporterings- och analysarbetet för en hel organisation.

Data Warehouses egenskaper
Ett datalager har fyra definierande egenskaper som skiljer det från en rutinmässig operativ databas:
- Ämnesinriktad
- Integrerade
- Tidsvariant
- Icke-flyktiga
Ämnesinriktad
Ett datalager är ämnesorienterat eftersom det levererar information om ett tema snarare än ett företags pågående verksamhet. Typiska ämnen inkluderar försäljning, marknadsföring och distribution.
Istället för daglig bearbetning betonar lagret modellering och analys för beslutsfattande. Det erbjuder en enkel och koncis bild av varje ämne och utelämnar data som inte stöder beslutsprocessen.
Integrerade
Integration är nära kopplad till ämnesorientering. I ett datalager innebär integration att etablera en gemensam måttenhet för all liknande data som hämtas från olika databaser, och att lagra den informationen på ett gemensamt, universellt acceptabelt sätt.
Ett datalager byggs genom att integrera data från olika källor, såsom stordatorer, relationsdatabaser och platta filer. Det måste också hålla konsekventa namngivningskonventioner, format och kodning.
Denna konsekvens i namngivning, attributmått och kodningsstruktur är det som möjliggör effektiv analys. Betrakta följande exempel:
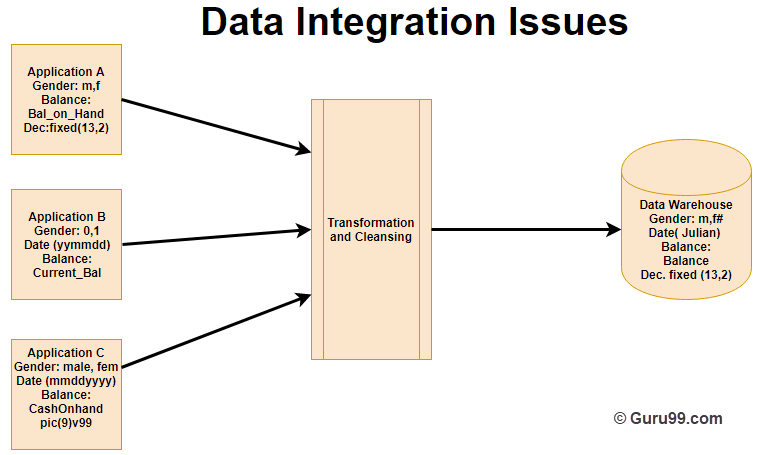
I exemplet ovan lagrar tre applikationer märkta A, B och C information om kön, datum och saldo, men varje applikation lagrar den på olika sätt:
- Applikation A lagrar könsfältet som logiska värden som M eller F.
- Applikation B lagrar könsfältet som ett numeriskt värde.
- Applikation C lagrar fältet för kön som ett teckenvärde.
- Samma variation gäller för fälten Datum och Saldo.
Efter omvandlings- och rensningsprocessen lagras all denna data i ett gemensamt format i datalagret.
Tidsvariant
Tidshorisonten för ett datalager är mycket bredare än för ett operativt system. Data identifieras med en viss period och erbjuder en historisk synvinkel, så de bär alltid med sig ett tidselement, antingen explicit eller implicit.
Ett ställe där denna tidsvarians förekommer är i postnyckelns struktur. Varje primärnyckel i lagret bör innehålla ett tidselement, såsom dag, vecka eller månad.
En annan aspekt av tidsvarians är att när data väl har införts i lagret kan de inte uppdateras eller ändras.
Icke-flyktiga
Ett datalager är också icke-flyktigt, vilket innebär att tidigare data inte raderas när ny data anländer. Informationen är skrivskyddad och uppdateras regelbundet, vilket hjälper analytiker att studera historisk data och förstå vad som hände och när.
Eftersom det inte behöver transaktionsbehandling, återställning eller samtidighetskontroll, utelämnar ett datalager de aktiviteter för borttagning, uppdatering och infogning som är vanliga i en operativ applikation. Endast två dataoperationer utförs i datalager:
- Laddning av data
- Datatillgång
Tabellen nedan belyser några viktiga skillnader mellan en operativ applikation och ett datalager:
| Operationell tillämpning | Datalager |
|---|---|
| Komplexa program måste kodas för att säkerställa att datauppgraderingsprocesser bibehåller hög integritet hos slutprodukten. | Den här typen av problem uppstår inte eftersom datauppdatering inte utförs. |
| Data placeras i normaliserad form för att säkerställa minimal redundans. | Data lagras inte i normaliserad form. |
| Tekniken som behövs för att stödja problem med transaktioner, dataåterställning, rollback och lösning av dödlägen är ganska komplex. | Det erbjuder relativ enkelhet i tekniken. |
Datalager Architecture
Datalager ArchiStrukturen är komplex eftersom systemet lagrar historisk och kumulativ data från flera källor. Det finns tre metoder för att konstruera lagerlagren: enskikts-, tvåskikts- och treskikts-.
Enskiktsarkitektur syftar till att minimera mängden data som lagras genom att ta bort redundans. Det används sällan i praktiken.
Tvåstegsarkitektur separerar de fysiskt tillgängliga källorna från datalagret. Det är inte lätt att utöka, stöder färre slutanvändare och kan drabbas av anslutningsproblem på grund av nätverksbegränsningar.
Tredelad arkitektur är den mest använda designen av ett datalager.
Den består av de övre, mellersta och nedre nivåerna:
- Nedre nivå: Databasen i lagret fungerar som den nedre nivån. Det är vanligtvis ett relationsdatabas-system, och data rensas, transformeras och laddas in i detta lager med hjälp av backend-verktyg.
- Mellannivå: Mellannivån är en OLAP-server implementerad med antingen ROLAP- eller MOLAP-modellen. Den presenterar en abstracen ted-vy av databasen och fungerar som en medlare mellan slutanvändaren och databasen.
- Toppnivå: Den översta nivån är ett frontend-klientlager. Det innehåller de verktyg och API:er som används för att ansluta och hämta data från lagret, såsom frågeverktyg, rapporteringsverktyg, hanterade frågeverktyg, analysverktyg och data mining-verktyg.
Datawarehouse-komponenter
Komponenterna och den övergripande arkitekturen i ett datalager fungerar tillsammans som visas i diagrammet nedan.
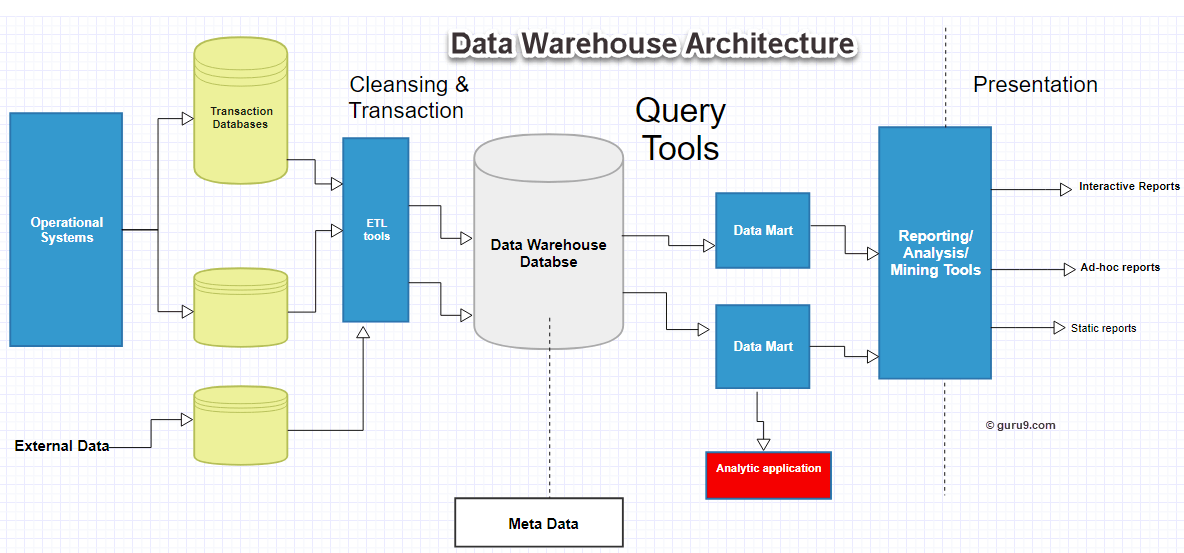
Datalagret är baserat på en RDBMS-server, ett centralt informationsarkiv omgivet av nyckelkomponenter som håller hela miljön funktionell, hanterbar och tillgänglig.
Ett datalager har fem huvudkomponenter, som beskrivs nedan.
Data Warehouse Database
Den centrala databasen är grunden för lagermiljön och implementeras på RDBMS teknik. Eftersom ett traditionellt RDBMS är anpassat för transaktionsbehandling snarare än lagerhållning, kan resurskrävande operationer som ad hoc-frågor, flertabellskopplingar och aggregeringar göra det långsammare.
Av den anledningen används alternativa databasmetoder:
- Relationsdatabaser distribueras parallellt för att möjliggöra skalbarhet, med hjälp av modeller för delat minne eller delat ingenting på olika multiprocessor- eller massivt parallella konfigurationer.
- Nya indexstrukturer används för att kringgå relationstabellskanningar och förbättra hastigheten.
- Flerdimensionella databaser (MDDB) används för att övervinna begränsningarna hos relationella lagermodeller. Ett exempel är Essbase från Oracle.
Inköps-, förvärvs-, sanerings- och transformationsverktyg (ETL)
Verktygen för datakälla, transformation och migrering utför alla konverteringar, sammanfattningar och ändringar som behövs för att omvandla data till ett enhetligt lagerformat. De kallas även Ex.tract, Transform och Load (ETL) verktyg.
Deras funktionalitet inkluderar följande:
- Anonymisera data enligt lagstadgade bestämmelser.
- Eliminera oönskad data från operativa databaser innan lastning i lagret.
- Sök och ersätt vanliga namn och definitioner för data som kommer från olika källor.
- Beräkna sammanfattningar och härledda data.
- Fyll i saknade data med standardvärden.
- Avduplicera upprepad data som kommer från flera källor.
Dessa ETL-verktyg kan generera cron-jobb, bakgrundsjobb, Cobol-program och shell-skript som regelbundet uppdaterar lagret och hjälper till att underhålla metadata.
Eftersom de använder många olika system måste ETL-verktyg också hantera heterogenitet i databaser och data.
metadata
Metadata kanske låter avancerat, men det är helt enkelt data om data som definierar lagret. Det används för att bygga, underhålla och hantera lagret.
Inom arkitekturen specificerar metadata källan, användningen, värdena och funktionerna för data och definierar hur data kan ändras och bearbetas, så att de förblir nära kopplade till lagret.
Till exempel kan en rad i en försäljningsdatabas innehålla:
4030 KJ732 299.90
Detta är meningslöst tills metadata förklarar att det representerar modellnumret 4030, säljagent-ID:t KJ732 och ett totalt försäljningsbelopp på 299.90 USD.
Metadata är därför en viktig ingrediens för att omvandla data till kunskap, och det hjälper till att besvara frågor som:
- Vilka tabeller, attribut och nycklar innehåller lagret?
- Var kom uppgifterna ifrån?
- Hur många gånger laddas datan om?
- Vilka transformationer och rening tillämpades?
Metadata faller inom två kategorier:
- Teknisk metadata: Detta beskriver lagret för de konstruktörer och administratörer som bygger och driver det.
- Affärsmetadata: Detta ger slutanvändarna ett enkelt sätt att förstå informationen som lagras i lagret.
Frågeverktyg
Ett primärt mål med datalager är att ge företag den information de behöver för att fatta strategiska beslut, och frågeverktyg är hur användare interagerar med systemet.
Dessa verktyg delas in i fyra kategorier:
- Fråge- och rapporteringsverktyg
- Verktyg för applikationsutveckling
- Datautvinningsverktyg
- OLAP-verktyg
Fråge- och rapporteringsverktyg
Fråge- och rapporteringsverktyg delas in i två grupper: rapporteringsverktyg och hanterade frågeverktyg.
Rapporteringsverktyg delas vidare in i produktionsrapporteringsverktyg och skrivbordsrapporteringsförfattare:
- Rapportförfattare: Dessa är utformade för slutanvändare som bygger sina egna analyser.
- Produktionsrapportering: Dessa låter organisationer generera regelbundna driftsrapporter och stödja batchjobb med hög volym, såsom utskrift och beräkning. Populära exempel inkluderar Brio, Business Objects, Oracle, PowerSoft och SAS Institute.
Hanterade frågeverktyg hjälpa slutanvändare genom att infoga ett metalager mellan användaren och databasen, vilket döljer komplexiteten i SQL och databasstruktur.
Verktyg för applikationsutveckling
När inbyggda grafiska och analytiska verktyg inte kan uppfylla en organisations analytiska behov, skapas anpassade rapporter med verktyg för applikationsutveckling.
Datautvinningsverktyg
Data mining upptäcker meningsfulla nya korrelationer, mönster och trender i stora datamängder, och data mining-verktyg automatiserar den upptäckten.
OLAP-verktyg
OLAP Verktygen är byggda på en flerdimensionell databas och låter användare analysera data genom detaljerade, flerdimensionella vyer.
Datalagerbuss Architecture
Datalagerbussen avgör hur data flödar genom lagret. Det flödet kan kategoriseras som inflöde, uppflöde, nedflöde, utflöde och metaflöde.
När du utformar bussen måste du ta hänsyn till de gemensamma dimensioner och fakta som spänner över datamarts.
Data Marts
A data mart är ett åtkomstlager som används för att leverera data till användare. Det passar stora lager eftersom det tar mindre tid och pengar att bygga, även om det inte finns någon enskild överenskommen definition av en datamart.
Enkelt uttryckt är en datamart en underavdelning till ett datalager. Den partitionerar data för en specifik grupp användare och kan finnas i samma databas som lagret eller i en fysiskt separat databas.
Datalager Architecture Best Practices
För att designa en sund datalagerarkitektur, följ de bästa metoderna nedan:
- Använd datalagermodeller som är optimerade för informationshämtning, oavsett om det gäller en dimensionell, denormaliserad eller hybridmetod.
- Välj en lämplig designmetod, antingen top-down eller bottom-up.
- Se till att data bearbetas snabbt och korrekt samtidigt som du konsoliderar dem till en enda version av sanningen.
- Utforma noggrant datainsamlings- och rensningsprocessen för lagret.
- Designa en metadataarkitektur som gör det möjligt att dela metadata mellan komponenter i lagret.
- Tänk på en OperaODS-modell (National Data Store) när hämtningsbehoven är nära botten av dataabstraktentractionspyramiden eller när flera operativa källor måste nås.
- Se till att datamodellen är integrerad snarare än bara konsoliderad; använd i så fall en 3NF-datamodell, vilket också är idealiskt vid anskaffning av ETL- och datareningsverktyg.
