
Bakåtpropagering i neurala nätverk: ML-algoritm och exempel
 Evelyn Clarke
⚡ Smart sammanfattning
Bakåtpropagering är den centrala träningsalgoritmen för ett neuralt nätverk, som finjusterar varje viktning från felet som mättes i föregående epok så att modellen generaliserar bättre på osynlig data, ett lager i taget.
Vad är ett artificiellt neuralt nätverk?
Ett artificiellt neuralt nätverk är en grupp anslutna I/O-enheter där varje anslutning har en vikt. Det hjälper dig att bygga prediktiva modeller från stora databaser, och designen lånar sitt ordförråd från det mänskliga nervsystemet. Nätverk av detta slag stöder bildförståelse, maskininlärning, datortal och många andra mönsterigenkänningsuppgifter.
Bakåtpropagering är algoritmen som bestämmer vilka vikterna ska vara, så de två idéerna läses bäst tillsammans.
Vad är Backpropagation?
Bakåtpropagering är kärnan i träning av neurala nätverk. Det är metoden att finjustera vikterna i ett neuralt nätverk baserat på felfrekvensen som erhölls i föregående epok (dvs. iteration). Korrekt justering av vikterna gör att du kan minska felfrekvenserna och göra modellen tillförlitlig genom att öka dess generalisering.
Backpropagation i neurala nätverk är en kortform för "bakåtspridning av fel." Det är en standardmetod för att träna artificiella neurala nätverk. Denna metod hjälper till att beräkna gradienten för en förlustfunktion med avseende på alla vikter i nätverket.
Två termer förväxlas ofta. Endast bakåtpropagering beräknar gradienten; en optimerare som gradient descent är vad som faktiskt förändringar vikterna med hjälp av den gradienten. Nästan alla moderna ramverk utför bakåtpropagering automatiskt via sin autodiff-motor.
Hur Backpropagation Algoritm fungerar
Bakåtutbredningsalgoritmen i neurala nätverk beräknar gradienten för förlustfunktionen för en enda vikt med hjälp av kedjeregeln. Den beräknar effektivt ett lager i taget, till skillnad från en naiv direkt beräkning. Den beräknar gradienten, men definierar inte hur gradienten används. Den generaliserar beräkningen i deltaregeln.
Kedjeregeln är det som gör detta effektivt. Inverkan av en tidig vikt på den slutliga förlusten är en produkt av de lokala derivatorna längs vägen till utdata, så algoritmen cachar varje lagers mellanresultat på vägen tillbaka och återanvänder det för varje vikt i lagret nedanför istället för att beräkna om hela nätverket per vikt.
Betrakta följande exempeldiagram över ett neuralt nätverk för bakåtutbredning för att förstå. tracett helt pass: ingångar kommer in till vänster, aktiveringar rör sig framåt genom det dolda lagret till utgången, och det uppmätta felet färdas sedan tillbaka längs samma anslutningar för att korrigera vikterna.
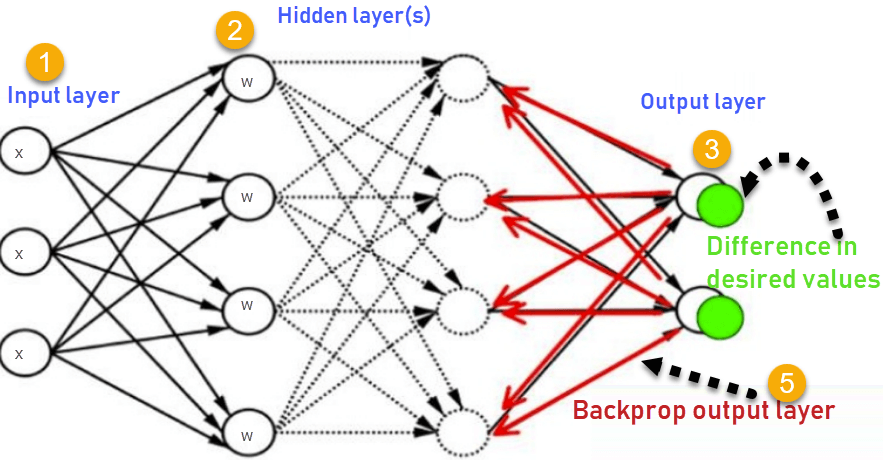
- Ingångarna X kommer via den föranslutna vägen
- Indata modelleras med hjälp av verkliga vikter W. Vikterna väljs vanligtvis slumpmässigt.
- Beräkna utdata för varje neuron från ingångslagret, till de dolda lagren, till utdatalagret.
- Beräkna felet i utgångarna:
ErrorB= Actual Output – Desired Output
- Åk tillbaka från utdatalagret till det dolda lagret för att justera vikterna så att felet minskar.
- Fortsätt upprepa processen tills önskad effekt uppnås.
Många läroböcker skriver samma mängd som önskad minus faktiskBåda konventionerna fungerar, eftersom tecknet absorberas när optimeringsdelentracts gradienten, förutsatt att du behåller en konvention i hela nätverket.
I praktiken är felet sällan en bar subtracEn förlustfunktion, såsom medelkvadratfelet för regression eller korsentropi för klassificering, omvandlar skillnaderna per utgång till det enda tal vars gradientåterpropagering faktiskt beräknas.
Varför behöver vi backpropagation?
De mest framträdande fördelarna med Backpropagation är:
- Backpropagation är snabb, enkel och lätt att programmera
- Den lägger inte till några nya egna parametrar; den finjustering du gör tillhör optimeraren och nätverket, främst inlärningshastigheten och antalet ingångar.
- Det är en flexibel metod då den inte kräver förkunskaper om nätverket
- Det är en standardmetod som överlag fungerar bra
- Det behöver inte nämnas något speciellt om funktionerna i funktionen för att läras in.
Enkelt uttryckt, utan ett effektivt sätt att erhålla gradienter, skulle det vara beräkningsmässigt opraktiskt att träna något djupare än ett enda lager.
Vad är ett feed Forward-nätverk?
Ett feedforward neuralt nätverk är ett artificiellt neuralt nätverk där noderna aldrig bildar en cykel. Den här typen av neurala nätverk har ett indatalager, dolda lager och ett utdatalager. Det är den första och enklaste typen av konstgjorda neurala nätverk.
Skillnaden är viktig här eftersom framåtpasset för bakåtpropagering exakt är ett framåtpass; bara felkorrigeringen går i motsatt riktning.
Typer av nätverk för backpropagation
Två typer av backpropagation-nätverk är:
- Statisk Back-propagation
- Återkommande backpropagation
Statisk bakåtspridning
Det är en typ av backpropagationnätverk som producerar en kartaping av en statisk ingång för statisk utgång. Det är användbart för att lösa problem med statisk klassificering som optisk teckenigenkänning.
Återkommande backpropagation
Återkommande bakåtspridning i data mining matas framåt tills ett fast värde uppnås. Därefter beräknas felet och fortplantas bakåt.
Den största skillnaden mellan dessa två metoder är: att kartanping är snabb vid statisk bakåtutbredning medan den är icke-statisk vid återkommande bakåtutbredning. Tabellen nedan ställer de två sida vid sida.
| Kriterium | Statisk bakåtspridning | Återkommande bakåtpropagering |
|---|---|---|
| Kartaping | Statisk ingång till statisk utgång | Icke-statisk; nätverket stabiliseras innan felet används |
| Fart | Snabb, en pass per prov | Långsammare, aktiveringen itereras tills den stabiliseras |
| Nätverksform | Framåtkoppling, inga cykler | Innehåller återkopplingskopplingar |
| Typisk användning | Optisk teckenigenkänning, klassificering med fast storlek | Problem vars utdata beror på ett stabiliserat internt tillstånd |
Bakåtförökningens historia
- År 1961 härleddes det grundläggande konceptet med kontinuerlig bakåtpropagering i samband med kontrollteori av J. Kelly, Henry Arthur och E. Bryson.
- 1969 gav Bryson och Ho en dynamisk systemoptimeringsmetod i flera steg.
- År 1970 publicerade Seppo Linnainmaa den omvända metoden för automatisk differentiering, den beräkningsmetod som modern bakåtpropagering bygger på.
- 1974 angav Werbos möjligheten att tillämpa denna princip i ett artificiellt neuralt nätverk.
- 1982 kom Hopfield med sin idé om ett neuralt nätverk.
- 1986, genom insatser av David E. Rumelhart, Geoffrey E. Hinton, Ronald J. Williams, fick bakåtpropagation erkännande.
- 1989 tränade Yann LeCun och kollegor ett faltningsnätverk med bakåtpropagering för att läsa handskrivna siffror, en av de första storskaliga praktiska användningarna.
- 1993 var Wan den första personen som vann en internationell tävling för mönsterigenkänning med hjälp av bakåtförökningsmetoden.
- År 2006 återupplivade Hintons arbete med djupa trosnätverk och lagervis förträning intresset för att träna djupa nätverk, vilket hade stannat av på grund av försvinnande gradienter.
- År 2010 analyserade Xavier Glorot och Yoshua Bengio varför djupa nätverk var svåra att träna och introducerade förbättrad viktinitialisering, vilket tillsammans med ReLU-aktiveringar gjorde djup backpropagation praktisk.
- År 2012 vann AlexNet (Krizhevsky, Sutskever och Hinton) ImageNet-tävlingen med hjälp av GPU-accelererad backpropagation, vilket utlöste den moderna djupinlärningsboomen.
- År 2014 introducerades Adam-optimeraren (Kingma och Ba) och blev snabbt standardvarianten av gradient-descent som används med backpropagation.
- År 2015 löste batchnormalisering och residualnätverk (ResNet) gradientflödesproblem i mycket djupa nätverk, vilket möjliggjorde bakåtpropagering genom hundratals lager.
- Under 2015-2017, TensorFlow och PyTorch gjorde automatisk differentiering till en standardfunktion i programvaran, så gradienter behövde inte längre härledas för hand.
- År 2017 introducerades Transformer-arkitekturen, och den tränas från början till slut med backpropagation, liksom de stora språkmodellerna som byggts på den.
- År 2019 fick Bengio, Hinton och LeCun ACM AM Turing Award för sitt arbete med djupa neurala nätverk.
- År 2020 argumenterade artikeln "Backpropagation and the Brain" (Lillicrap, Santoro, Marris, Akerman och Hinton) för att hjärnan kan approximera backpropagation-liknande inlärning, vilket återupptog debatten om biologisk trovärdighet.
- År 2022 föreslog Hinton Forward-Forward-algoritmen, en träningsmetod som helt undviker en bakåtpassning.
- År 2024 tilldelades John Hopfield och Geoffrey Hinton Nobelpriset i fysik för grundläggande upptäckter som möjliggjorde maskininlärning med artificiella neurala nätverk.
- År 2025 utvidgades framåt-framåt-metoder till faltningsnätverk, vilket visar att bakåtpropageringsfri träning skulle kunna fungera med bildklassificeringsuppgifter.
- Från och med 2026 är backpropagation fortfarande standardträningsalgoritmen för praktiskt taget alla djupinlärningsmodeller, medan forskningen fortsätter om gradientfria, lokala och parallella inlärningsmetoder som minskar dess minnes- och beräkningskostnader.
Nyckelpunkter för bakåtpropagation
- Förenklar nätverksstrukturen genom att ta bort viktade länkar som har minst effekt på det tränade nätverket.
- Du måste studera en grupp av inmatnings- och aktiveringsvärden för att utveckla förhållandet mellan indata och dolda enhetslager.
- Det hjälper till att bedöma vilken inverkan en given indatavariabel har på en nätverksutgång. Kunskapen från denna analys bör representeras i regler.
- Backpropagation är särskilt användbart för djupa neurala nätverk som arbetar med felbenägna projekt, som bild- eller taligenkänning.
- Bakåtpropagering utnyttjar kedje- och potensreglerna, vilket gör att den kan fungera med valfritt antal utgångar.
Bästa praxis för bakåtpropagering
Bakåtutbredning i neurala nätverk kan förklaras med hjälp av analogin med "skosnören". Viktuppdateringar beter sig ungefär som spänningen i ett snöre: för lite och ingenting hålls ihop, för mycket och något brister.
| Spetsspänning | Vad det betyder under träning |
|---|---|
| För lite spänning | Inte tillräckligt begränsande och väldigt lös — modellen passar inte tillräckligt bra |
| För mycket spänning | För mycket begränsning (överträning); tar för mycket tid (relativt långsam process); högre sannolikhet för brytning |
| Dra mer i ena snöret än i det andra | Obehag (bias) — en del av nätverket dominerar anpassningen |
Två praktiska vanor följer av analogin: skala indata före träning så att ingen enskild funktion är mer krävande än resten, och observera valideringsförlusten så att spänningen släpps innan överträning sätter in.
Nackdelar med att använda Backpropagation
- Den faktiska prestandan för backpropagation på ett specifikt problem är beroende av indata.
- Algoritm för återförökning i datautvinning kan vara ganska känslig för brusig data
- Över en mini-batch bör backpropagation implementeras med en matrisbaserad metod;ping över ett exempel i taget är markant långsammare.
- I djupa nätverk kan den upprepade multiplikationen av små derivator krympa gradienter mot noll, så de tidigaste lagren lär sig knappt — det försvinnande gradientproblemet som beskrivs i Google Maskininlärningskraschkurs.
Inget av detta utesluter metoden. De är anledningarna till att utövare använder sig av ReLU-aktiveringar, normalisering och noggranna inlärningstaktsscheman när de går från ett ytligt nätverk till ett djupt lärande modell.
