
Apache Solr Tutorial: Vad är Solr? Architecture
 David Carter
⚡ Smart sammanfattning
Apache Solr är en öppen källkod, Java-baserad sökserver byggd på Apache Lucene. Den indexerar stora volymer textcentrerad data och returnerar relevanta resultat via REST API:er, och erbjuder fulltextsökning, fasettering, skalbarhet och både fristående och SolrCloud-distributionslägen.
Vad är Apache Solr?
Apache Solr är en sökserverplattform med öppen källkod skriven i Java språk av Apache Software Foundation. Den är mycket skalbar och redo att distribuera sökmotor för att hantera en stor volym textcentrerad data. Syftet med att använda Apache Solr är att indexera och söka i stora mängder webbinnehåll och ge relevant innehåll baserat på sökfråga.
Apache Solr är ett REST-API-baserat HTTP-omslag runt fulltextsökmotorn som heter Apache Lucene. Ett inverterat index är en lista med ord där varje ordpost länkar till dokumenten den är lagrad i. På så sätt får du alla dokument för sökfrågan "guru99" med en enkel 'get'-operation.
Historien om Apache Solr
- 1999: Doug Cutting publicerade Lucene
- 2004: Solr utvecklades på CNET av Yonik Seeley som ett delföretags internt projekt
- 2006: CNET publicerar källkoden genom att donera den till Apache-programvaran Foundation
- 2008: Solr 1.3 släpptes med förbättrade sökmöjligheter och prestandaförbättringar
- 2010: Sammanslagning av Lucene och Solr
- 2012: Solr version 4.0 släpptes, med ny Solr Cloud-funktion
- 2016: Solr 6.0 släpptes som erbjuder stöd för exekvering av parallella SQL-frågor
- 2017: Solr 7.0 släpptes, med ett autoskalningsramverk och JSON Facet API.
- 2019: Solr 8.0 släpptes med stöd för kapslade dokument och förbättrade strömmande uttryck
- 2021: Lucene och Solr separerades igen, och Solr blev ett oberoende Apache-toppnivåprojekt
- 2022: Solr 9.0 släpptes som den första versionen oberoende av Lucene, med stöd för vektorsökning och Kubernetes.
- 2026: Solr 10.0 släpptes som den senaste huvudversionen
Funktioner i Apache Solr
Här är viktiga funktioner i Apache Solr:
- Automatisk lastbalansering
- Standardbaserade öppna gränssnitt – XML, JSON och HTTP
- Rekommendationer och stavningsförslag stöds
- Stöd för automatisk komplettering och geo-spatial sökning
- Inbyggd säkerhet för autentisering och auktorisering
- Låter dig utföra en flerspråkig nyckelordssökning
- Förutsägelse för autoslutförande/skriva i förväg
- Batch- och streamingbearbetning
- Det är enkelt att bygga maskininlärningsmodeller
- Speciellt optimerad för högvolym webbtrafik
- Omfattande HTML-beundransgränssnitt
- Stöder både Schema och Schemaless konfiguration
- Facetterad sökning och filtrering
- Central konfiguration för hela Cluster
Nyckeltermer som används i Apache Solr
Nu i denna Solr-sökmotorhandledning kommer vi att lära oss om nyckeltermer som används i Apache Solr:
| Nyckelterm | BESKRIVNING |
|---|---|
| Solr Core | Solr Core kan definieras som ett index av texter och fält som härrör från alla dokument. En Solr-instans kan ha en eller flera Solr-kärnor. Core = en instans av Lucene Index + Solr-konfiguration |
| Solr-instans | Solr Instance är en instans en Solr som körs i Java Virtuell maskin (JVM). I fristående läge erbjuder den bara en instans medan du i molnläge kan ha en eller flera instanser. |
| Indexering | Indexering är en metod för att lägga till dokuments innehåll till Solr Index. Apache Solr använder Apache Lucene Inverted Index-teknik. |
| Dokument | Det är en grupp av fält och deras värden. Ett dokument är en grundläggande enhet av data som lagras i Apache Core. En Apache-kärna kan innehålla ett eller flera dokument. |
| Fält | Fältet är ett nyckel-värde-par som lagrar faktiska data i ett dokument. Nyckeln anger fältnamnet och värdet som innehåller dessa fältdata. Ett dokument kan ha ett eller flera fält. Det används av Apache Solr för att indexera dokumentinnehållet. |
| Vilsamma API:er | För att kommunicera med Solr är det inte nödvändigt att ha använt Java programmering. Istället tillhandahåller Apache Solr vilsamma tjänster att kommunicera med den. Du kan skicka dokument och ta emot resultat i olika filformat som JSON, XML och CSV. |
| Fulltextsökning | Solr erbjuder funktioner för fulltextsökning som tokens, fraser, stavningskontroll, autokomplettering, jokertecken, etc. |
| Admin-gränssnitt | Solr erbjuder ett lättanvänt, användarvänligt, funktionsdrivet användargränssnitt. Med hjälp av gränssnittet kan du utföra uppgifter som att hantera loggar, lägga till, ta bort, uppdatera och söka i dokument. |
| Textcentrerad och sorterad efter relevans | Apache Solr används för att söka i textdokument, och resultaten levereras enligt användarens fråga. |
| Nod | I Solr-molnet är varje enskild instans känd som en nod. |
| Cluster | Ett kluster är en samling noder. |
| Samling | Ett kluster har ett logiskt index som också kallas en samling. |
| Skärva | Det är en liten del av samlingen som erbjuder enstaka eller flera kopior av indexet. |
| Replica | En replik är en kopia av shard som körs i en nod. |
| Leader | Det är en kopia av skärvan, som skickar förfrågningar från Solr Cloud för resten av replikerna. |
Apache Solr Architecture
Nu i denna Solr-sökhandledning, låt oss lära oss om Apache Solr Architecture:

Apache Solr kompromissar med följande komponenter
Fråga
Frågetolken analyserar de frågor som du behöver skicka till Solr. Den verifierar din fråga för att kontrollera syntaktiska fel. Efter att ha analyserat frågorna översätts den till ett format som är känt av Lucene.
Begäran Hanterare
Begäran som skickas till Apache Solr bearbetas av förfrågehanteraren. Begäran kan vara en frågeförfrågan eller en indexuppdateringsförfrågan. Du måste välja förfrågehanteraren enligt dina krav. För att skicka en förfrågan till Solr måste du mappa hanteraren till en specifik [enhet/modell/etc.]. URL slutpunkt.
Svar Writer
En svarsskrivare kommer att generera formaterade utdata för ingångsfrågor. Den stöder olika format som XML, JSON, CSV.etc. Du kan ha olika svarsskribenter för olika typer av förfrågningar.
Uppdatera hanterare
När du skickar en uppdateringsbegäran till Apache Solr körs den genom en uppsättning plugin-program, signaturer, loggning och indexering. Denna process kallas för uppdateringsbegäran. Uppdateringshanteraren ansvarar också för ändringar som att lägga till eller ta bort dem.ping inlämnad, etc.
Apache Solr-applikationer
| Ansökan | Användning |
|---|---|
| Intranätsportal |
|
| Federerad klient |
|
| Instrumentdatauppsättningar |
|
| Reglerande dokument |
|
| Inbäddad i PLM Application |
|
Hur installerar man Apache Solr?
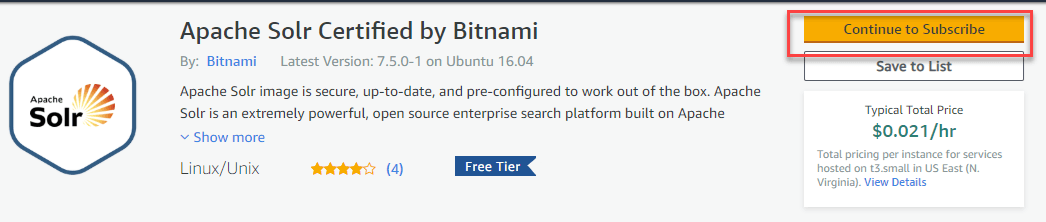
Steg 1) Öppna webbplatsen och fortsätt att prenumerera
Gå till det här länk, Klicka på "Fortsätt att prenumerera."
Steg 2) Klicka på Acceptera villkor
På nästa sida klickar du på Acceptera villkor.

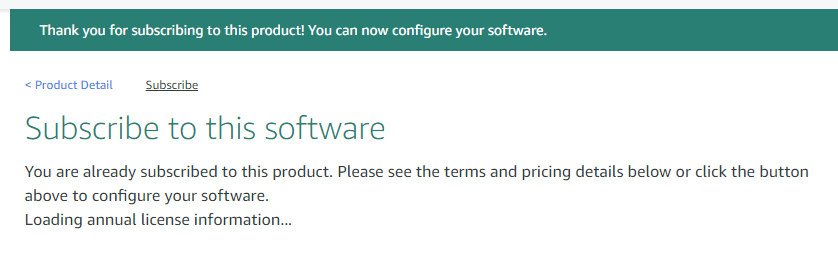
Steg 3) Vänta ett tag
Vänta sedan ett tag och sedan accepteras begäran efter en tid.
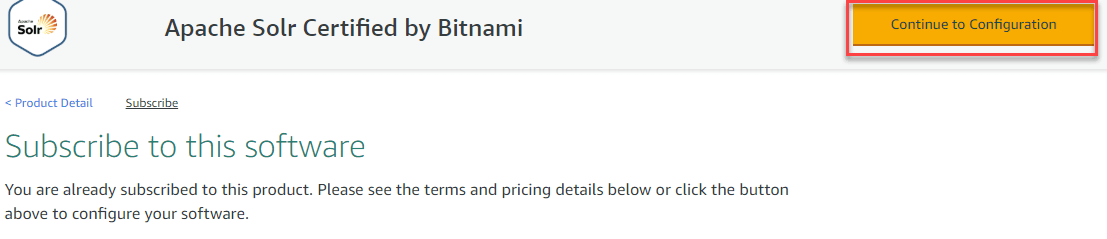
Steg 4) Fortsätt till konfiguration
Uppdatera sidan och klicka på "Fortsätt till konfiguration"
Steg 5) Fortsätt till Launch
Behåll standardinställningarna och klicka på "Fortsätt till start."

Steg 6) Behåll standardinställningarna
På nästa sida, Behåll standardinställningarna
- Se till att du har nyckelns pem-fil
- Klicka på "Starta"

Du kommer att se detta framgångsmeddelande

Steg 7) Notera den offentliga DNS
I EC2-konsolen, notera din instans offentliga DNS

Steg 8) Öppna nedan URL
För att komma åt Solr, använd helt enkelt URL
http://publicdns:8983
i vårt fall blir det
http://ec2-18-221-175-53.us-east-2.compute.amazonaws.com:8983
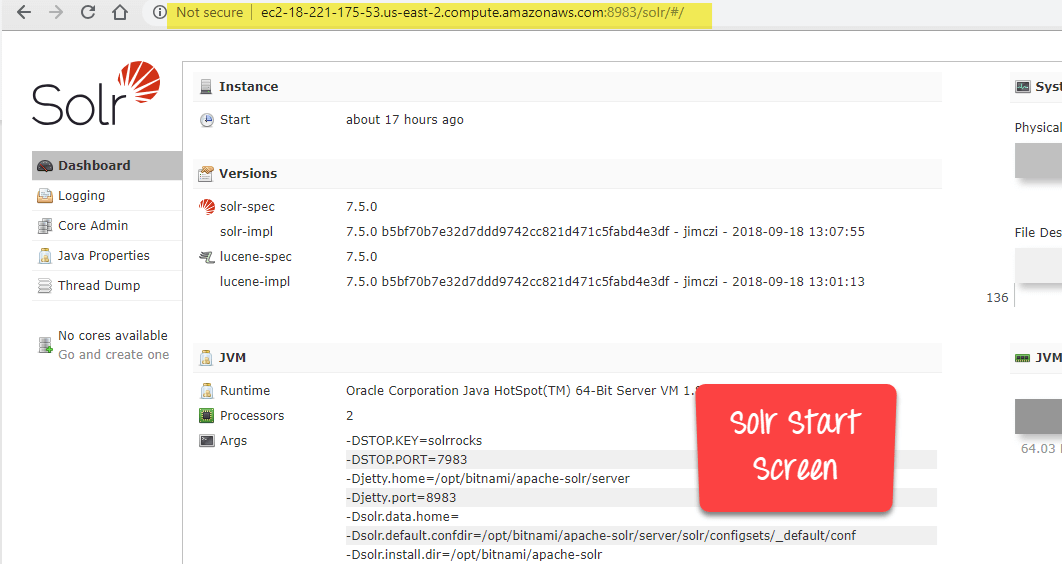
Obs: Om du har problem med att komma åt instansen, ändra inkommande och utgående regler i din instans för att tillåta all trafik som visas i nedanstående Solr-frågeexempel:

Elasticsearch vs. Apache Solr
| Driftparametrar | Apache Solr | Elastisk sökning |
|---|---|---|
| Natur | Det är ett projekt med öppen källkod. | Inte ett projekt med öppen källkod. |
| Statisk status | Statisk i shema.xml | Statisk i elasticsearch.yml |
| Format | XML, CSV, JSON | Endast JSON |
| index | Kan laddas om under körning med samling/kärnåterladdning | Definieras under index/typskapande med ett REST-anrop |
| Dokumentation | Det är väl dokumenterat. | Det är dåligt dokumenterat. |
| Dela skärvor | Möjligt | Inte möjligt |
Fördelar med Apache Solr
- Hjälper dig att minska den tid det tar att hitta information
- Det är en snabb, enkel, kraftfull och flexibel sökmotor
- Hjälper dig att göra dina produkter och tjänster mer tillgängliga
- Öka kundernas utgifter för en webbapplikation
- Hjälper dig att förbättra användarupplevelsen på webbapplikationen för att öka intäkter och vinst
- Omfattande HTML-baserat administrationsgränssnitt
- Flexibel och anpassningsbar med XML-konfiguration
- Extensible Plugin Architecture
- Mycket skalbar, robust, feltolerant sökmotor
- Stöder distribuerad, skuggning, replikering, Clustering och Multi-Node Architecture
Nackdelar med Apache Solr
- Det är inte ett ACID-kompatibelt datalager
- Det är inte användbart som ett primärt datalager. Endast användbar som sekundär datalagring
- Erbjuder inte stöd för transaktioner och distribuerade transaktioner
- Stöder inte anslutningar och komplexa frågor
- Inte optimalt för normaliserade data
