
Aggregatortransformation i Informatica med exempel
 Redaktionellt team
⚡ Smart sammanfattning
Aggregatortransformation i Informatica är det aktiva objektet som utför beräkningar som summa, medelvärde och antal över en grupp rader, och håller dessa rader i en aggregerad cache tills varje grupp är komplett.
Vad är Aggregator Transformation?
Aggregatortransformation är en aktiv transformation som utför aggregerade beräkningar som summa, medelvärde och antal.
Om du till exempel vill beräkna summan av lönerna för alla anställda per avdelning kan du använda Aggregator-transformationen.
De aggregerade operationerna utförs över en grupp rader, så en tillfällig platshållare krävs för att lagra alla dessa poster och utföra beräkningarna.
För detta används aggregatorcachen. Detta är ett tillfälligt huvudminne som allokerats till aggregatortransformationen för att utföra sådana operationer, och det består av två delar: indexcachen lagrar gruppvärdena medan datacachen lagrar raddata som aggregeras.
Transformationen är aktiv eftersom den ändrar antalet rader i pipelinen. Flera tusen medarbetarposter kan komma in i den och endast en rad per avdelning lämnar den.
Hur man använder aggregatortransformation i Informatica
I det här exemplet kommer vi att beräkna summan av löneavdelningen. För detta kräver vi en ny kolumn för att lagra denna summa. Så först och främst kommer vi att förbereda en ny kolumn.
Steg 1) Skapa en ny databasmåltabell, till exempel "sum_sal_deptwise", med hjälp av skriptet nedan. Du kommer att se den nya databasmåltabellen som skapats under Targets-mappen i nästa steg.
Ladda ner filen Create_table_sal_deptwise.txt ovan
Steg 2) Skapa en ny kartaping "m_sum_sal_deptwise".
För att skapa den nya kartanping, vi behöver källtabellen (EMP) och måltabellen (sum_sal_deptwise) i Mapping Designer, så vi behöver
- Importera måltabellen "sum_sal_deptwise" till kartanping.
- Importera källtabellen "emp".
Båda definitionerna visas nu på arbetsytan, som visas nedan.
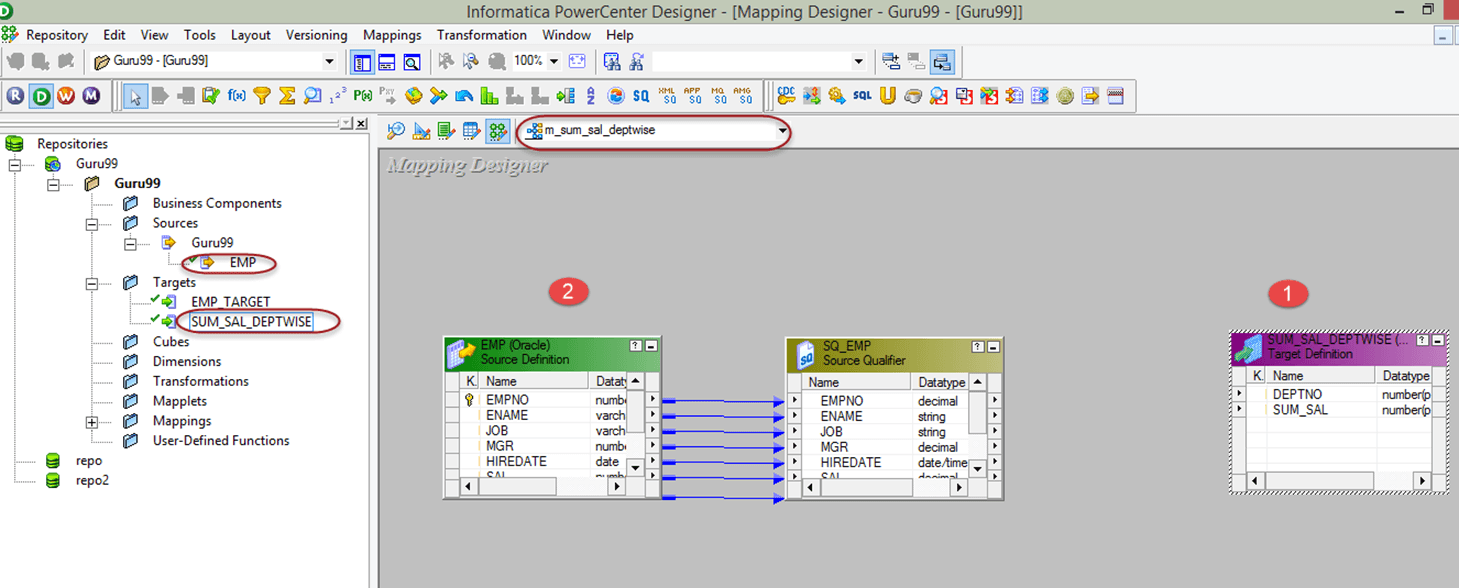
Steg 3) På kartanping,
- Från Källkval, ta bort kolumnerna anställningsnamn, enamn, jobb, chef, hiredato och meddelande, så att endast kolumnerna avd.nummer och sal lämnas kvar.
- Skapa en ny aggregeringstransformation med hjälp av verktygsmenyn som visas på skärmbilden. När du klickar på aggregeringsikonen skapas en ny aggregeringstransformation.
Det nya AGGTRANS-objektet visas bredvid den trimmade källkvalificeraren.

Steg 4) Dra och släpp kolumnerna SAL och DEPTNO från källkvalificeraren (SQ_EMP) till aggregeringstransformationen. De två portarna är nu länkade till AGGTRANS.

Steg 5) Double-klicka på Aggregator-transformationen för att öppna dess egenskaper och klicka sedan
- Lägg till en ny port i transformationen
- Byt namn på porten till SUM_SAL
- Ändra datatypen för denna nya port till dubbel
- Gör den här porten till en utgångsport genom att markera kryssrutan för utgångsporten.
- Klicka på uttrycksalternativet
Fliken Portar listar nu SAL, DEPTNO och den nya utgångsporten SUM_SAL.

Steg 6) I fönstret Uttrycksredigerare
- Addera uttrycket sum(SAL); du måste skriva uttrycket själv.
- Välj OK-knappen, detta kommer att visa fönstret Redigera transformationer.
Uttrycksredigeraren visar det aggregerade uttryck som är tilldelat SUM_SAL.

Steg 7) I fönstret Redigera transformationer väljer du alternativet "Gruppera efter" genom att markera kryssrutan mot kolumnen avdelningsnr och klicka på OK. Genom att välja gruppera efter mot avdelningsnr instruerar vi Informatica att gruppera löner efter avdelningsnr.

Steg 8) Länka kolumnerna deptno och sum_sal från Aggregator-transformationen till måltabellen. Kartanping är då komplett från källa till mål.

Spara nu kartanping och kör den efter att ha skapat en ny session för den här kartanpingMåltabellen skulle innehålla summan av lönerna per avdelning. På så sätt kan vi använda aggregeringstransformationen för att beräkna aggregerade resultat.
Gruppera efter portar i aggregatortransformation
Steget ovan markerade en enskild port som Gruppera efter, vilket är det som omvandlade en företagsomfattande totalsumma till en totalsumma per avdelning. Alla input-, input/output-, output- eller variabla portar kan markeras på samma sätt.
Tre regler styr resultatuppsättningen:
- En rad per grupp. När värden grupperas genererar integrationstjänsten en rad för varje unik kombination av gruppen efter portar.
- Ingen gruppering efter, en rad. Om ingen port är markerad behandlas hela indata som en enda grupp och en rad returneras för alla indatarader.
- Den sista raden vinner. Tillsammans med det aggregerade resultatet skickar integrationstjänsten vanligtvis den sista raden som mottagits i gruppen, såvida inte en funktion som FIRST namnger en annan rad.
Där flera hamnar är markerade avgör hamnordningen gruppenping ordning, och ordningen kan ändra resultatet. Gruppping av DEPTNO och då är JOB inte samma sak som groupping av JOBB och sedan AVD.NR, eftersom värdena i den andra kolumnen inte nödvändigtvis är unika.
Egenskaper för aggregeringstransformation
Fliken Egenskaper i fönstret Redigera transformationer innehåller inställningarna som avgör var cachen finns och hur mycket av den som används. Tabellen nedan listar dem.
| Att lägga plattor | Vad den kontrollerar |
|---|---|
| Cachekatalog | Lokal katalog där integrationstjänsten skapar index- och datacachefiler. Standardvärdet är processvariabeln $PMCacheDir som anges i Workflow Manager. |
| Tracingnivå | Mängd detaljer som skrivits till sessionsloggen för denna transformation. |
| Sorterad inmatning | Anger att inkommande data redan är sorterad efter grupp efter portar. Välj det bara när kartanping levererar verkligen sorterad data. |
| Storlek på aggregeringsdatacache | Storleken på datacachen. Standardvärdet är 2 000 000 byte, och Auto låter integrationstjänsten ange storleken. |
| Storlek på aggregatorindexcache | Storleken på indexcachen. Standardvärdet är 1 000 000 byte, och Auto låter integrationstjänsten ange storleken. |
| Transformationsomfattning | Tillämpar logiken på varje transaktion, eller på all inkommande data. All inmatning tar bort gränserna för inkommande transaktioner. |
När stegvis aggregering är aktiverat skriver integrationstjänsten en säkerhetskopia av cachefilerna vid varje körning, så cachekatalogen måste innehålla två uppsättningar filer istället för en.
Regler för aggregerade uttryck och prestandatips
Ett aggregerat uttryck kan kombinera en aggregerad funktion med villkorliga klausuler och icke-aggregerade funktioner, vilket möjliggör villkorliga summor och antal inom en port. Två regler begränsar vad som kan skrivas.
- En nivå av nestning. Endast en aggregerad funktion kan kapslas inuti en annan, och det inre uttrycket utvärderas först.
- Ingen blandning. En transformation kan innehålla funktioner på en nivå eller kapslade funktioner, aldrig båda. Om den innehåller båda markerar designern kartanping ogiltig, så dela upp logiken över två Aggregator-transformationer.
På finjusteringssidan gör tre inställningar det mesta av jobbet:
- Sorterad inmatning. När rader anländer sorterade efter grupp och portar kan varje grupp släppas så snart den sista raden anländer, vilket innebär att betydligt mindre data cachas och sessionen körs snabbare. Sorterad inmatning kan inte kombineras med stegvis aggregering.
- Stegvis aggregering. Nya källrader skickas genom kartanping och kombineras med den historiska cachen istället för att omräkna historiken, vilket passar en nattlig belastning på en löpande totalsumma.
- Filtrera tidigt. Rader som aldrig kommer att bidra till en totalsumma bör tas bort före aggregatorn, antingen i källkvalificeringsfrågan eller i en Filtertransformation, eftersom varje rad som når aggregatorn kostar cacheminne. Detta är en av standardkontrollerna under prestandajustering.
