
Модель Seq2seq (Sequence to Sequence) с использованием Python.Torch
 Редакционная коллегия
⚡ Умное резюме
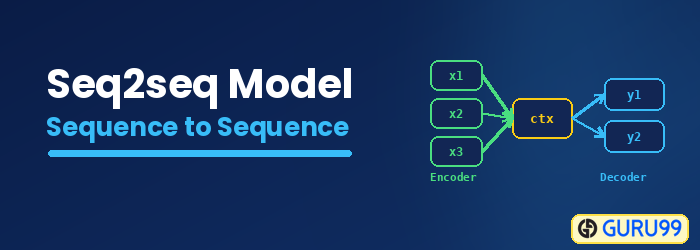
Seq2Seq — это архитектура кодировщика-декодера, которая преобразует входную последовательность в выходную с помощью двух рекуррентных нейронных сетей, что позволяет использовать её в машинном переводе и других задачах обработки естественного языка, где длина входных и выходных данных различается.
Что такое НЛП?
Обработка естественного языка (NLP) — это одна из популярных областей искусственного интеллекта, которая помогает компьютерам понимать, обрабатывать или отвечать человеку на его естественном языке. NLP — это движущая сила всего этого. Google Translate это помогает нам понимать другие языки.
Что такое Seq2Seq?
Seq2Seq — это метод машинного перевода и языковой обработки на основе кодера-декодера, который сопоставляет входную последовательность с выходной последовательностью с тегом и значением внимания. Идея состоит в том, чтобы использовать две RNN, которые будут работать вместе со специальным токеном и попытаться предсказать следующую последовательность состояний на основе предыдущей последовательности.
Как предсказать последовательность из предыдущей последовательности
Ниже описаны шаги для предсказания последовательности на основе предыдущей последовательности с помощью Python.Torглава
Шаг 1) Загрузка наших данных
Для нашего набора данных вы будете использовать набор данных из Пары двуязычных предложений, разделенных табуляцией. Здесь я буду использовать набор данных с английского на индонезийский. Вы можете выбрать все, что захотите, но не забудьте изменить имя файла и каталог в коде.
from __future__ import unicode_literals, print_function, division
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F

import numpy as np
import pandas as pd

import os
import re
import random

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
Шаг 2) Подготовка данных
Использовать набор данных напрямую нельзя. Необходимо разбить предложения на слова и преобразовать их в вектор One-Hot. Каждое слово будет уникально проиндексировано в классе Lang для создания словаря. Класс Lang будет хранить каждое предложение и разбивать его по словам с помощью функции addSentence. Затем создаст словарь, проиндексировав каждое неизвестное слово для моделей Sequence to sequence.
SOS_token = 0
EOS_token = 1
MAX_LENGTH = 20

#initialize Lang Class
class Lang:
   def __init__(self):
       #initialize containers to hold the words and corresponding index
       self.word2index = {}
       self.word2count = {}
       self.index2word = {0: "SOS", 1: "EOS"}
       self.n_words = 2  # Count SOS and EOS

#split a sentence into words and add it to the container
   def addSentence(self, sentence):
       for word in sentence.split(' '):
           self.addWord(word)

#If the word is not in the container, the word will be added to it, else, update the word counter
   def addWord(self, word):
       if word not in self.word2index:
           self.word2index[word] = self.n_words
           self.word2count[word] = 1
           self.index2word[self.n_words] = word
           self.n_words += 1
       else:
           self.word2count[word] += 1
Класс Lang поможет нам создать словарь. Для каждого языка каждое предложение будет разбито на слова, которые затем будут добавлены в контейнер. Каждый контейнер будет хранить слова в соответствующем индексе, подсчитывать количество слов и добавлять индекс слова, чтобы мы могли использовать его для поиска индекса слова или поиска слова по его индексу.
Поскольку наши данные разделены символом TAB, вам необходимо использовать панд В качестве загрузчика данных Pandas будет считывать наши данные как DataFrame и разделять их на исходное и целевое предложения. Для каждого предложения вы нормализуете его до нижнего регистра, удаляете все несимвольные символы, преобразуете из Unicode в ASCII и разделяете предложения так, чтобы в каждом из них содержалось только слово.
#Normalize every sentence
def normalize_sentence(df, lang):
   sentence = df[lang].str.lower()
   sentence = sentence.str.replace('[^A-Za-z\s]+', '')
   sentence = sentence.str.normalize('NFD')
   sentence = sentence.str.encode('ascii', errors='ignore').str.decode('utf-8')
   return sentence

def read_sentence(df, lang1, lang2):
   sentence1 = normalize_sentence(df, lang1)
   sentence2 = normalize_sentence(df, lang2)
   return sentence1, sentence2

def read_file(loc, lang1, lang2):
   df = pd.read_csv(loc, delimiter='\t', header=None, names=[lang1, lang2])
   return df

def process_data(lang1,lang2):
   df = read_file('text/%s-%s.txt' % (lang1, lang2), lang1, lang2)
   print("Read %s sentence pairs" % len(df))
   sentence1, sentence2 = read_sentence(df, lang1, lang2)

   source = Lang()
   target = Lang()
   pairs = []
   for i in range(len(df)):
       if len(sentence1[i].split(' ')) < MAX_LENGTH and len(sentence2[i].split(' ')) < MAX_LENGTH:
           full = [sentence1[i], sentence2[i]]
           source.addSentence(sentence1[i])
           target.addSentence(sentence2[i])
           pairs.append(full)

   return source, target, pairs
Ещё одна полезная функция, которую вы будете использовать, — это преобразование пар в тензоры. Это очень важно, потому что наша сеть считывает только данные тензорного типа. Это также важно, потому что именно здесь в конце каждого предложения будет стоять токен, сообщающий сети, что обработка входных данных завершена. Для каждого слова в предложении сеть будет получать индекс соответствующего слова из словаря и добавлять токен в конец предложения.
def indexesFromSentence(lang, sentence):
   return [lang.word2index[word] for word in sentence.split(' ')]

def tensorFromSentence(lang, sentence):
   indexes = indexesFromSentence(lang, sentence)
   indexes.append(EOS_token)
   return torch.tensor(indexes, dtype=torch.long, device=device).view(-1, 1)

def tensorsFromPair(input_lang, output_lang, pair):
   input_tensor = tensorFromSentence(input_lang, pair[0])
   target_tensor = tensorFromSentence(output_lang, pair[1])
   return (input_tensor, target_tensor)
Модель Seq2Seq

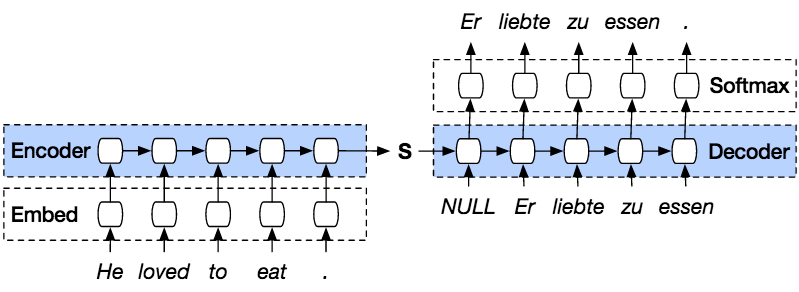
PyTorМодель ch Seq2seq — это тип модели, использующий Python.TorВ основе модели лежит кодировщик-декодер. Кодировщик кодирует предложение слово за словом в индекс словарного запаса или известных слов с индексом, а декодер предсказывает результат кодированного ввода, декодируя входные данные последовательно и пытаясь использовать последний входной сигнал в качестве следующего, если это возможно. Этот метод также позволяет предсказывать следующий входной сигнал для создания предложения. Каждому предложению присваивается токен, обозначающий конец последовательности. В конце предсказания также присутствует токен, обозначающий конец выходного сигнала. Таким образом, от кодировщика к декодеру передается состояние для предсказания результата.

Кодировщик будет кодировать наше входное предложение слово за словом в последовательности, и в конце будет токен, обозначающий конец предложения. Кодировщик состоит из слоя встраивания (Embedding layer) и слоя GRU (Gated Recurrent Unit). Слой встраивания представляет собой таблицу поиска, которая хранит встраивание нашего входного предложения в словарь слов фиксированного размера. Он будет передан в слой GRU. Слой GRU — это вентильный рекуррентный блок (Gated Recurrent Unit), состоящий из многослойной структуры. РНН который будет вычислять последовательный ввод. Этот слой рассчитает скрытое состояние на основе предыдущего и обновит сброс, обновление и новые ворота.

Декодер декодирует входные данные с выхода кодировщика. Он попытается предсказать следующий выходной сигнал и, если это возможно, использовать его в качестве следующего входного сигнала. Декодер состоит из слоя встраивания (Embedding layer), слоя GRU (Global Reduction Layer) и линейного слоя (Linear layer). Слой встраивания создаст таблицу соответствия для выходных данных и передаст её в слой GRU для вычисления предсказанного выходного состояния. После этого линейный слой поможет вычислить функцию активации для определения истинного значения предсказанного выходного сигнала.
class Encoder(nn.Module):
   def __init__(self, input_dim, hidden_dim, embbed_dim, num_layers):
       super(Encoder, self).__init__()

       #set the encoder input dimesion , embbed dimesion, hidden dimesion, and number of layers
       self.input_dim = input_dim
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.num_layers = num_layers

       #initialize the embedding layer with input and embbed dimention
       self.embedding = nn.Embedding(input_dim, self.embbed_dim)
       #intialize the GRU to take the input dimetion of embbed, and output dimention of hidden and
       #set the number of gru layers
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)

   def forward(self, src):
       embedded = self.embedding(src).view(1,1,-1)
       outputs, hidden = self.gru(embedded)
       return outputs, hidden

class Decoder(nn.Module):
   def __init__(self, output_dim, hidden_dim, embbed_dim, num_layers):
       super(Decoder, self).__init__()

#set the encoder output dimension, embed dimension, hidden dimension, and number of layers
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.output_dim = output_dim
       self.num_layers = num_layers

# initialize every layer with the appropriate dimension. For the decoder layer, it will consist of an embedding, GRU, a Linear layer and a Log softmax activation function.
       self.embedding = nn.Embedding(output_dim, self.embbed_dim)
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)
       self.out = nn.Linear(self.hidden_dim, output_dim)
       self.softmax = nn.LogSoftmax(dim=1)

   def forward(self, input, hidden):
# reshape the input to (1, batch_size)
       input = input.view(1, -1)
       embedded = F.relu(self.embedding(input))
       output, hidden = self.gru(embedded, hidden)
       prediction = self.softmax(self.out(output[0]))
       return prediction, hidden

class Seq2Seq(nn.Module):
   def __init__(self, encoder, decoder, device, MAX_LENGTH=MAX_LENGTH):
       super().__init__()

#initialize the encoder and decoder
       self.encoder = encoder
       self.decoder = decoder
       self.device = device

   def forward(self, source, target, teacher_forcing_ratio=0.5):
       input_length = source.size(0) #get the input length (number of words in sentence)
       batch_size = target.shape[1]
       target_length = target.shape[0]
       vocab_size = self.decoder.output_dim

#initialize a variable to hold the predicted outputs
       outputs = torch.zeros(target_length, batch_size, vocab_size).to(self.device)

#encode every word in a sentence
       for i in range(input_length):
           encoder_output, encoder_hidden = self.encoder(source[i])

#use the encoder's hidden layer as the decoder hidden
       decoder_hidden = encoder_hidden.to(device)

#add a token before the first predicted word
       decoder_input = torch.tensor([SOS_token], device=device)  # SOS

#topk is used to get the top K value over a list
#predict the output word from the current target word. If we enable the teaching force, then the next decoder input is the next word, else, use the decoder output highest value.
       for t in range(target_length):
           decoder_output, decoder_hidden = self.decoder(decoder_input, decoder_hidden)
           outputs[t] = decoder_output
           teacher_force = random.random() < teacher_forcing_ratio
           topv, topi = decoder_output.topk(1)
           input = (target[t] if teacher_force else topi)
           if(teacher_force == False and input.item() == EOS_token):
               break

       return outputs
Шаг 3) Обучение модели
Процесс обучения в моделях Seq2seq начинается с преобразования каждой пары предложений в тензоры на основе их языкового индекса. Наша модель «последовательность-последовательность» будет использовать SGD в качестве оптимизатора и функцию NLLLoss для вычисления потерь. Процесс обучения начинается с подачи пары предложений в модель для предсказания правильного результата. На каждом шаге выходные данные модели будут сравниваться с истинными словами для определения потерь и обновления параметров. Таким образом, поскольку будет использовано 75000 итераций, наша модель «последовательность-последовательность» сгенерирует 75000 случайных пар из нашего набора данных.
teacher_forcing_ratio = 0.5

def clacModel(model, input_tensor, target_tensor, model_optimizer, criterion):
   model_optimizer.zero_grad()

   input_length = input_tensor.size(0)
   loss = 0
   epoch_loss = 0
   # print(input_tensor.shape)

   output = model(input_tensor, target_tensor)

   num_iter = output.size(0)
   print(num_iter)

#calculate the loss from a predicted sentence with the expected result
   for ot in range(num_iter):
       loss += criterion(output[ot], target_tensor[ot])

   loss.backward()
   model_optimizer.step()
   epoch_loss = loss.item() / num_iter

   return epoch_loss

def trainModel(model, source, target, pairs, num_iteration=20000):
   model.train()

   optimizer = optim.SGD(model.parameters(), lr=0.01)
   criterion = nn.NLLLoss()
   total_loss_iterations = 0

   training_pairs = [tensorsFromPair(source, target, random.choice(pairs))
                     for i in range(num_iteration)]

   for iter in range(1, num_iteration+1):
       training_pair = training_pairs[iter - 1]
       input_tensor = training_pair[0]
       target_tensor = training_pair[1]

       loss = clacModel(model, input_tensor, target_tensor, optimizer, criterion)

       total_loss_iterations += loss

       if iter % 5000 == 0:
           avarage_loss= total_loss_iterations / 5000
           total_loss_iterations = 0
           print('%d %.4f' % (iter, avarage_loss))

   torch.save(model.state_dict(), 'mytraining.pt')
   return model
Шаг 4) Проверьте модель
Процесс оценки Seq2seq PyTorЗадача состоит в проверке выходных данных модели. Каждая пара моделей «последовательность-последовательность» будет подана в модель для генерации предсказанных слов. После этого вы посмотрите на наибольшее значение на каждом выходе, чтобы найти правильный индекс. И в конце вы сравните его с предсказанием нашей модели, чтобы увидеть, соответствует ли оно истинному предложению.
def evaluate(model, input_lang, output_lang, sentences, max_length=MAX_LENGTH): with torch.no_grad(): input_tensor = tensorFromSentence(input_lang, sentences[0]) output_tensor = tensorFromSentence(output_lang, sentences[1]) decoded_words = [] output = model(input_tensor, output_tensor) # print(output_tensor) for ot in range(output.size(0)): topv, topi = output[ot].topk(1) # print(topi) if topi[0].item() == EOS_token: decoded_words.append('' ) break else: decoded_words.append(output_lang.index2word[topi[0].item()]) return decoded_words def evaluateRandomly(model, source, target, pairs, n=10): for i in range(n): pair = random.choice(pairs) print('source {}'.format(pair[0])) print('target {}'.format(pair[1])) output_words = evaluate(model, source, target, pair) output_sentence = ' '.join(output_words) print('predicted {}'.format(output_sentence))
Теперь начнём обучение с алгоритма Seq to Seq, с количеством итераций 75000, числом слоёв RNN, равным 1, и размером скрытого слоя 512.
lang1 = 'eng'
lang2 = 'ind'
source, target, pairs = process_data(lang1, lang2)

randomize = random.choice(pairs)
print('random sentence {}'.format(randomize))

#print number of words
input_size = source.n_words
output_size = target.n_words
print('Input : {} Output : {}'.format(input_size, output_size))

embed_size = 256
hidden_size = 512
num_layers = 1
num_iteration = 100000

#create encoder-decoder model
encoder = Encoder(input_size, hidden_size, embed_size, num_layers)
decoder = Decoder(output_size, hidden_size, embed_size, num_layers)

model = Seq2Seq(encoder, decoder, device).to(device)

#print model
print(encoder)
print(decoder)

model = trainModel(model, source, target, pairs, num_iteration)
evaluateRandomly(model, source, target, pairs)
Как видите, наше предсказанное предложение не очень хорошо согласуется, поэтому, чтобы получить более высокую точность, вам нужно тренироваться с гораздо большим количеством данных и попытаться добавить больше итераций и количества слоев, используя последовательность для обучения последовательности.
random sentence ['tom is finishing his work', 'tom sedang menyelesaikan pekerjaannya']
Input : 3551 Output : 4253
Encoder(
  (embedding): Embedding(3551, 256)
  (gru): GRU(256, 512)
)
Decoder(
  (embedding): Embedding(4253, 256)
  (gru): GRU(256, 512)
  (out): Linear(in_features=512, out_features=4253, bias=True)
  (softmax): LogSoftmax()
)
5000 4.0906
10000 3.9129
15000 3.8171
20000 3.8369
25000 3.8199
30000 3.7957
75000 3.7044
