
SAP DS (службы данных) в HANA
 Мейсон Гарсия
⚡ Умное резюме
SAP Data Services — это корпоративная платформа ETL, которая перемещает и очищает данные из разнородных источников в SAP HANA. Designer, Job Server, Engine, Repository и Access Server работают вместе для построения, планирования и выполнения потоков данных.
Что такое SAP Услуги передачи данных?
SAP Data Services — это инструмент ETL, предоставляющий единое решение корпоративного уровня для интеграции, преобразования, обеспечения качества данных, профилирования данных и обработки текстовых данных из разнородных источников в целевую базу данных или хранилище данных.
Заявки, называемые заданиями, создаются в конструкторе, где происходит сопоставление данных.ping Определены преобразования и трансформация. Продукт также называется SAP BusinessObjects Data Services, сокращенно BusinessObjects Data Services SAP BODS — оба названия описывают один и тот же инструмент. SAP Текущая версия — Data Services 4.3; основная поддержка версии 4.2 завершилась 31 мая 2023 года, поэтому новые внедрения должны начаться с версии 4.3.
В пределах SAP Ландшафт HANA, SAP Сервисы обработки данных — это вариант, который выбирают, когда данные необходимо преобразовать в процессе загрузки, а не копировать в исходном виде. В разделах ниже описаны возможности инструмента, взаимодействие его компонентов и полный расчет загрузки данных. SAP Таблица ECC в SAP ХАНА.
Особенности SAP Услуги по передаче данных
Приведенные ниже возможности объясняют, почему SAP Data Services позиционируется как платформа корпоративного уровня, а не просто утилита для копирования.
- Он обеспечивает высокопроизводительные параллельные преобразования.
- В нем есть комплексные административные инструменты и инструмент для составления отчетов.
- Он поддерживает несколько пользователей.
- SAP ТЕЛА Обладает высокой гибкостью в работе с приложениями на основе веб-сервисов.
- Это позволяет использовать скриптовый язык с богатым набором функций.
- SAP Службы данных могут интегрироваться с SAP Сервер репликации LT (SLT) с использованием технологии, основанной на триггерах. SLT добавляет возможности дельта-анализа к каждому устройству. SAP или неSAP исходная таблица, которая позволяет отслеживать изменения данных и передавать дельта-данные из исходной таблицы.
- Проверка данных с помощью информационных панелей и аудит процессов.
- Инструмент администрирования с возможностями планирования и панелями мониторинга.
- Отладка, встроенное профилирование и просмотр данных.
- SAP Служба обработки данных поддерживает широкий спектр источников и целевых объектов:
- Любое приложение, например SAP.
- Любая база данных с поддержкой массовой загрузки и отслеживания изменений данных.
- Файлы: фиксированной ширины, с разделителями-запятыми, COBOL, XML и Excel.
Эти функции обеспечиваются небольшим набором устанавливаемых компонентов, каждый из которых выполняет свою особую роль.
Компоненты SAP Услуги по передаче данных
SAP В состав службы обработки данных входят перечисленные ниже компоненты.
- UX/UI дизайнер – Это инструмент разработки, с помощью которого можно создавать, тестировать и выполнять задания по заполнению хранилища данных. Он позволяет разработчику создавать объекты и настраивать их, выбирая значок на диаграмме потока «источник-цель». Его можно использовать для создания приложений, указывая рабочие процессы и потоки данных. Чтобы открыть Data Services Designer, перейдите в Меню «Пуск» -> «Все программы» -> SAP Службы данных -> Конструктор служб данных.

- Сервер заданий – Это приложение, которое запускает механизм обработки данных и служит интерфейсом между этим механизмом и пакетом программ Data Services.
- Двигатель – Механизм служб данных выполняет отдельные задачи, определенные в приложении.
- Репозиторий – Репозиторий представляет собой базу данных, в которой хранятся предопределенные объекты Designer и определяемые пользователем объекты (метаданные источника и цели, правила преобразования). Репозитории бывают двух типов:
- Локальный репозиторий (используется Designer и Job Server).
- Центральный репозиторий (используется для совместного использования объектов и контроля версий).
- Сервер доступа – Сервер доступа передает сообщения между веб-приложениями, сервером заданий служб данных и механизмами обработки данных.
- Администратора – Веб-администратор обеспечивает администрирование ресурсов служб данных через браузер, как описано ниже:
- Настройка, запуск и остановкаping Сервисы в режиме реального времени.
- Планирование, мониторинг и выполнение пакетных заданий.
- Настройка сервера заданий, сервера доступа и использования репозитория.
- Управление пользователями.
- Публикация пакетных заданий и сервисов в режиме реального времени через веб-сервисы.
- Настройка и управление адаптерами.
Знание функций каждого компонента — это лишь половина дела. Приведенная ниже архитектура показывает, как они взаимодействуют под нагрузкой.
SAP Услуги по передаче данных Archiтекстура
Архитектура служб данных включает следующие компоненты:
- Центральное хранилище — используется для настройки репозитория для серверов заданий, управления безопасностью, контроля версий и совместного использования объектов.
- Конструктор — используется для создания проекта, задания, рабочего процесса и потока данных, а также для их запуска.
- Локальный репозиторий — здесь вы можете создавать, изменять и запускать задания, рабочие процессы и потоки данных.
- Сервер заданий и механизм обработки заданий – он управляет заданиями.
- Сервер доступа — используется для выполнения заданий в реальном времени, созданных разработчиками в репозиториях.
На изображении ниже показаны службы данных и взаимосвязи между их компонентами.

SAP ТЕЛА Archiтекстура
Деталь дизайнерского окна
Компонент Designer — это тот компонент, с которым разработчик проводит больше всего времени, поэтому стоит сначала изучить его структуру. Подробное описание каждого раздела Data Services Designer приведено ниже:
- Панель инструментов (используется для открытия, сохранения, резервного копирования, проверки, выполнения и т. д.).
- Площадь проекта (Содержит текущий проект, включающий задание, рабочий процесс и поток данных. В Data Services все сущности являются объектами).
- Рабочее пространство (Область окна приложения, в которой мы определяем, отображаем и изменяем объекты).
- Локальная библиотека объектов (Он содержит локальные объекты репозитория, такие как преобразования, задания, рабочие процессы, потоки данных и т. д.).
- Палитра инструментов (Кнопки на панели инструментов позволяют добавлять новые объекты в рабочую область).

Иерархия объектов
На приведенной ниже диаграмме показаны иерархические связи для ключевых типов объектов в рамках служб данных.

Примечание: В приведенной ниже легенде указаны необязательные элементы в иерархии.

Рабочие процессы и условные операторы являются необязательными.
Предметы, используемые в SAP Ниже приведена подробная информация об услугах обработки данных.
| Объекты | Описание |
|---|---|
| Проект | Проект — это объект самого верхнего уровня в окне конструктора. Проекты позволяют организовать другие объекты, создаваемые в Data Services. Одновременно открыт только один проект, где «открыт» означает «видим в области проекта». |
| работа | «Задание» — это наименьшая единица работы, которую можно независимо запланировать для выполнения. |
| Сценарии | Подмножество строк в процедуре. |
| Процесс | «Рабочий процесс» — это объединение нескольких потоков данных в целостный рабочий процесс для выполнения всей задачи. Рабочий процесс является необязательным. Рабочий процесс — это процедура, которая может:
|
| Поток данных | «Поток данных» — это процесс, посредством которого исходные данные преобразуются в целевые данные. Поток данных — это многократно используемый объект. Он всегда вызывается из рабочего процесса или задания. Он используется для:
|
| Хранилище данных | Логический канал, соединяющий службы данных с исходными и целевыми базами данных. Хранилища данных:
|
| Target | Таблица или файл, в который служба данных загружает данные из источника. |
SAP Data Services против SLT против DXC
SAP Data Services — одна из нескольких компаний. предоставление данных варианты для SAP HANA, и выбор неправильной версии приводит к дополнительным затратам, которые невозможно компенсировать никакими настройками. В таблице ниже сравниваются три серверных метода.
| Критерии | SAP Услуги по передаче данных | ТА | DXC |
|---|---|---|---|
| Задержка | Пакетная или плановая обработка | Настоящее время | Пакетная обработка, запланированная источником данных. |
| трансформация | Полный процесс ETL, очистка и профилирование. | Простые правила фильтрации и обработки полей. | Нет ничего, кроме эксtracлогика Тора |
| Область действия источника | SAP и не-SAPфайлы, приложения | SAP и не-SAP базы данных | SAP Только для бизнес-пакета |
| Требуется дополнительный сервер | Да, сервер заданий | Обычно да | Нет |
| Наиболее подходит для | Качество данных и консолидация данных из различных источников | Operaнациональная отчетность на основе данных в режиме реального времени | Повторное использование существующего бизнес-контента, например:tracTORs |
Короче говоря, выбирайте SAP Использование Data Services необходимо, когда данные должны быть очищены, объединены или стандартизированы перед их подачей. SLT следует выбирать, когда отчет должен отражать транзакцию в режиме реального времени. DXC когда проверенный бизнес-контентtracTor уже предоставляет необходимую вам семантику. Для разового набора данных без повторяющегося расписания... загрузка плоского файла Это быстрее, чем настройка любого из этих трех вариантов.
Как загрузить данные из SAP Исходная таблица с использованием SAP Услуги по передаче данных
В Data Services все данные представляют собой объекты. Для каждой исходной и целевой базы данных требуется отдельное хранилище данных.
Полная последовательность загрузки данных из SAP Ниже приведена таблица исходных данных. Затем подробно описан каждый шаг.
- Создайте хранилище данных между источником и BODS.
- Импортируйте метаданные (структуры) в BODS.
- Настройте сервер импорта.
- Импортируйте метаданные в систему HANA.
- Создайте хранилище данных между BODS и HANA.
- Создать проект
- Создать задание (пакетное или в режиме реального времени)
- Создайте рабочий процесс
- Создать поток данных
- Добавление объектов в поток данных
- Выполнить задание
- Проверьте предварительный просмотр данных в HANA.
Шаг 1) Создайте хранилище данных между SAP источник и BODS.
- Для загрузки данных из SAP источник в SAP Хана через SAP Для работы BODS требуется хранилище данных. Поэтому сначала создадим хранилище данных, как показано ниже: Проект -> Создать -> Хранилище данных

- Появится всплывающее окно «Создать новое хранилище данных». Введите данные, как показано ниже:
- Введите имя хранилища данных «ds_ecc».
- Выберите имя типа хранилища данных как «SAP Приложения".
- Введите имя сервера базы данных.
- Введите имя пользователя и пароль.
- Щелкните по кнопке «Применить».
- Щелкните по кнопке «ОК».

- Будет создано хранилище данных. Просмотрите созданное хранилище данных ниже.
- Перейдите в библиотеку локальных объектов.
- Выберите вкладку «Хранилище данных».
- Будет отображено хранилище данных «ds_ecc».

Шаг 2) Импортируйте метаданные (структуру) на сервер BODS.
Мы создали хранилище данных для переноса данных из ECC в BODS; теперь мы импортируем метаданные из ECC в BODS. Для импорта выполните следующие шаги.
- Выберите хранилище данных «ds_ecc» и щелкните правой кнопкой мыши.
- Выберите опцию «Импорт по имени».

Отобразится всплывающее окно «Импорт по имени». Введите данные, как показано ниже:
- Выберите Тип как таблица.
- Введите название таблицы для импорта. В данном случае мы импортируем таблицу KNA1.
- Нажмите кнопку «Импорт». Таблица KNA1 появится в узле «Таблица» источника данных «ds_ecc».

Метаданные таблицы будут импортированы в хранилище данных ds_ecc следующим образом.

Шаг 3) Настройте сервер импорта.
На данный момент мы импортировали таблицу в хранилище данных «ds_ecc», созданное для ECC, чтобы SAP Подключение BODS. Для импорта данных в SAP HANAНам необходимо настроить сервер импорта.
- Для этого перейдите к Быстрый просмотр -> Настройка сервера импорта как показано ниже.

- Появится всплывающее окно «Выберите систему». Выберите её. SAP Система HANA (здесь HDB) представлена ниже.

- Нажмите кнопку «Далее». Появится еще одно всплывающее окно для ввода учетных данных службы данных. Введите следующие данные:
- SAP Адрес сервера BODS (здесь BODS:6400).
- SAP Имя репозитория BODS (имя репозитория HANAUSER).
- Источник данных ODBC (ZTDS_DS).
- Порт по умолчанию для SAP Сервер BODS (8080).

Щелкните по кнопке «Готово».
Шаг 4) Импортируйте метаданные в систему HANA.
Сервер импорта настроен, поэтому метаданные можно импортировать. SAP BODS-сервер.
- В режиме быстрого просмотра нажмите кнопку «Импорт».
- Отобразится всплывающее окно с параметрами импорта. Выберите опцию «Выборочный импорт метаданных».

Нажмите на кнопку «Далее».
Появится всплывающее окно «Выборочный импорт метаданных», в котором мы выбираем целевую систему.
- Выберите SAP Система HANA (здесь HDB).

Нажмите на кнопку «Далее».
Шаг 5) Создайте хранилище данных между BODS и HANA.
В BODS требуется отдельное хранилище данных для источника и целевой системы. Хранилище данных источника уже существует, поэтому далее создается целевое хранилище данных между BODS и HANA с именем «DS_BODS_HANA».
- Перейдите в Проект -> Создать -> Хранилище данных.
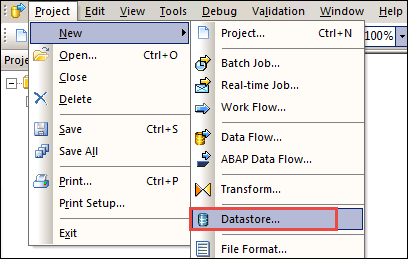
- На экране появится окно «Создать новое хранилище данных», как показано ниже.
- Введите имя хранилища данных (DS_BODS_HANA).
- Укажите тип хранилища данных как «База данных».
- Введите тип базы данных следующим образом: SAP ХАНА.
- Выберите версию базы данных.
- Введите SAP Имя сервера базы данных HANA.
- Введите имя порта для SAP База данных Хана.
- Введите имя пользователя и пароль.
- Поставьте галочку напротив пункта «Включить автоматическую передачу данных».

Нажмите кнопку «Применить», а затем кнопку «ОК».
Хранилище данных «DS_BODS_HANA» будет отображаться на вкладке «Хранилище данных» в локальной библиотеке объектов, как показано ниже.

- Теперь импортируем таблицу в хранилище данных «DS_BODS_HANA».
- Выберите хранилище данных «DS_BODS_HANA» и щелкните правой кнопкой мыши.
- Выберите «Импорт по имени».

- Появится всплывающее окно для импорта по имени, как показано ниже.
- Выберите Тип как таблица.
- Введите имя как KNA1.
- Владелец будет отображаться как Ханаузер.
- Нажмите кнопку «Импорт».

Таблица будет импортирована в хранилище данных «DS_BODS_HANA». Для просмотра данных в таблице выполните следующие действия.
- Щелкните по таблице «KNA1» в хранилище данных «DS_BODS_HANA».
- Данные будут представлены в табличном формате.

Шаг 6) Определите проект. Проект группирует и организует связанные объекты. Проект может содержать любое количество заданий, рабочих процессов и потоков данных.
- Перейдите в меню «Проект дизайнера».
- Выберите новый вариант.
- Выберите опцию «Проект».

Появится всплывающее окно для создания нового проекта, как показано ниже. Введите название проекта и нажмите кнопку «Создать». Будет создана папка проекта, в нашем случае BODS_DHK.

Шаг 7) Определите задачу. Задание — это многократно используемый объект. Оно содержит рабочие процессы и потоки данных. Задания могут выполняться вручную или по расписанию. Для выполнения процесса BODS необходимо определить задание.
Мы создаём задание с именем JOB_Customer.
- Выберите проект (BODS_DHK), созданный на предыдущем шаге, щелкните правой кнопкой мыши и выберите «Создать пакетное задание».
- Переименуйте его в «JOB_Customer».

Шаг 8) Определите рабочий процесс.
- В области проекта выберите задание «JOB_Customer».
- Нажмите кнопку «Рабочий процесс» на панели инструментов. Щелкните по пустой области рабочего пространства. В рабочем пространстве появится значок рабочего процесса.
- Измените название рабочего процесса на «WF_Customer».

Щелкните по названию рабочего процесса, и в рабочей области появится пустое представление для этого рабочего процесса.

Шаг 9) Определите поток данных.
- Нажмите на рабочий процесс «WF_Customer».
- Нажмите кнопку «Поток данных» на панели инструментов. Щелкните по пустой области рабочей области. В рабочей области появится значок потока данных.
- Измените имя потока данных на «DF_Customer».
- Поток данных также отображается в области проекта слева, под названием задания.

Шаг 10) Добавьте объекты в поток данных.
Внутри потока данных мы предоставляем инструкции по преобразованию исходных данных в желаемый формат для целевой таблицы.
Используются три объекта:
- Объект для источника.
- Объект для целевой таблицы.
- Объект для преобразования запроса, который сопоставляет столбцы из источника с целевыми.
Щёлкните по потоку данных DF_Customer. Появится пустое рабочее пространство, как показано ниже.
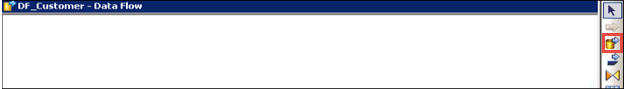
- Укажите объект в качестве источника. – Перейдите в хранилище данных «ds_ecc», выберите таблицу KNA1 и перетащите ее на пустой экран потока данных.
- Укажите объект в качестве целевого. – Выберите хранилище данных «DS_BODS_HANA» из репозитория и выберите таблицу KNA1.
- Перетащите его на рабочую область и выберите «Создать». Target«Опция». Теперь будет две таблицы: одна исходная, другая целевая.

- Преобразование запроса – Это инструмент, используемый для извлечения данных на основе входной схемы для заданных пользователем условий, а также для передачи данных из источника в целевую систему.
- Выберите значок «Преобразование запроса» на панели инструментов и перетащите его между исходным и целевым объектами в рабочей области.
- Свяжите объект Query с источником.
- Свяжите объект запроса с целевой таблицей.

Double— Щелкните значок «Запрос», чтобы сопоставить столбцы из входной схемы с выходной схемой. Картаping Появляется окно, в котором мы выполняем следующие действия:
- Выбрана исходная таблица KNA1.
- Выделите все столбцы из исходной таблицы, щелкните правой кнопкой мыши и выберите «Сопоставить с выходными данными».
- В качестве целевого выходного параметра выбирается запрос, и столбцы будут сопоставлены.

Сохраните и подтвердите проект. Нажмите на значок «Проверить». Появится всплывающее окно, подтверждающее успешную проверку.

Шаг 11) Выполните задание. Для выполнения задания следуйте указанному ниже пути.
- Чтобы открыть проект, выберите значок области проекта, а затем выберите созданный проект.
- Выберите задание и щелкните правой кнопкой мыши.
- Выберите параметр «Выполнить», чтобы запустить задание.
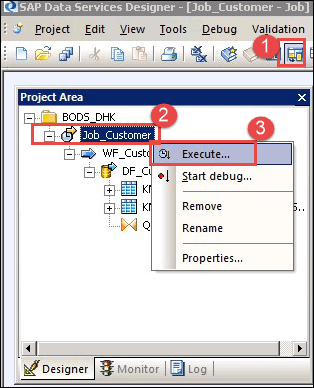
После выполнения задания отображается окно «Журнал задания», в котором отображаются все сообщения, относящиеся к заданию. Последнее сообщение будет «Задание». «Завершено успешно».

Шаг 12) Проверьте и подтвердите данные в SAP База данных Хана.
- Войти в SAP База данных HANA через SAP HANA Studioи выберите схему HANAUSER.
- Выберите таблицу KNA1 в узле «Таблица».
- Щелкните правой кнопкой мыши на таблице KNA1 и выберите «Открыть предварительный просмотр данных».
- Данные KNA1, загруженные в процессе BODS, будут отображены на экране предварительного просмотра данных.

Совпадение количества строк в исходной таблице и в этом предварительном просмотре подтверждает корректность загрузки, после чего задачу можно запланировать для повторного запуска из административной панели.
