
Что такое Хадуп? ArchiАрхитектура, экосистема и компоненты
 Прафулла Ранадив
⚡ Умное резюме
Apache Hadoop — это платформа с открытым исходным кодом, которая хранит огромные наборы данных в кластерах из стандартных машин и переносит логику обработки к самим данным, поэтому масштабируемость анализа достигается за счет добавления недорогих узлов, а не более мощных серверов.
Что такое Хадуп?
Apache Hadoop — это программная платформа с открытым исходным кодом, используемая для разработки приложений обработки данных, которые выполняются в распределенной вычислительной среде.
Приложения, созданные с использованием Hadoop, работают с большими наборами данных, распределенными по кластерам стандартных компьютеров. Стандартные компьютеры дешевы и широко доступны. Они в основном полезны для достижения большей вычислительной мощности при низких затратах.
Подобно данным, хранящимся в локальной файловой системе персонального компьютера, в Hadoop данные хранятся в распределенной файловой системе, которая называется Распределенная файловая система HadoopМодель обработки основана на «Локализация данных» Концепция, в которой вычислительная логика отправляется на узлы кластера (серверы), содержащие данные. Эта вычислительная логика представляет собой просто скомпилированную версию программы, написанной на языке высокого уровня, таком как... JavaТакая программа обрабатывает данные, хранящиеся в Hadoop HDFS.
Знаете ли вы? Компьютерный кластер состоит из набора множества процессорных блоков (дисковое хранилище + процессор), которые соединены друг с другом и действуют как единая система.
Текущая стабильная версия — 3.5.0, выпущенная 2 апреля 2026 года; для линейки 3.4 по-прежнему выпускаются обновления, улучшающие её функциональность.
Экосистема и компоненты Hadoop
На приведенной ниже диаграмме показаны различные компоненты экосистемы Hadoop, сгруппированные по выполняемым ими функциям — хранение, обработка, а также инструменты для запросов, приема и координации данных.

Apache Hadoop состоит из двух подпроектов:
- Hadoop MapReduce: MapReduce — это вычислительная модель и программная среда для написания приложений, работающих на Hadoop. Эти программы MapReduce способны параллельно обрабатывать огромные данные на больших кластерах вычислительных узлов.
- HDFS (Распределенная файловая система Hadoop): HDFS отвечает за хранение данных в приложениях Hadoop. Приложения MapReduce используют данные из HDFS. HDFS создает несколько реплик блоков данных и распределяет их по вычислительным узлам кластера. Такое распределение обеспечивает надежные и чрезвычайно быстрые вычисления.
В текущих версиях добавлены еще два основных модуля. Hadoop ПРЯЖАДобавленная в Hadoop 2.x функция планирования задач в кластере, Хадуп Общий содержит общее Java библиотеки, от которых зависит каждый модуль. YARN — это то, что позволяет таким движкам, как... SparkTez и Flink работают параллельно с MapReduce.
Хотя Hadoop наиболее известен благодаря MapReduce и своей распределенной файловой системе HDFS, этот термин также используется для обозначения целого ряда связанных проектов, которые подпадают под определение распределенных вычислений и обработки больших объемов данных. К другим проектам Apache, связанным с Hadoop, относятся: HiveHBase, Mahout, Сквооп, Флуми ZooKeeper.
Hadoop Archiтекстура
Hadoop имеет архитектуру "ведущий-ведомый" для хранения данных и распределенной обработки данных. Уменьшение карты и методы HDFS. На приведенной ниже диаграмме эти роли расположены рядом, с одной стороны — уровень хранения, а с другой — уровень обработки.
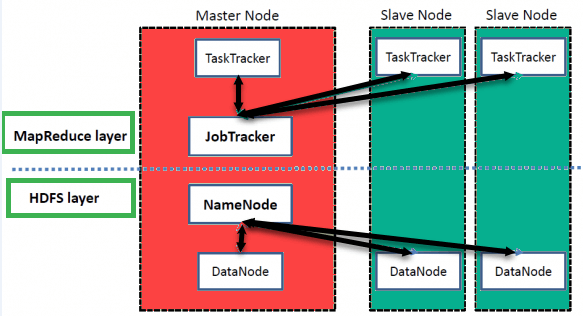
Hadoop высокого уровня Archiтекстура
Имя Узел
NameNode хранит метаданные для каждого файла и каталога, используемых в пространстве имен, включая информацию о том, из каких блоков состоит каждый файл и где эти блоки расположены.
узел данных
DataNode управляет состоянием узла HDFS и позволяет взаимодействовать с хранящимися в нем блоками, отправляя NameNode периодические отчеты о блоках и сигналы подтверждения активности.
Мастерноде
Мастер-нода позволяет проводить параллельную обработку данных с помощью Hadoop MapReduce.
Подчиненный узел
Подчиненные узлы — это дополнительные машины в кластере Hadoop, которые позволяют хранить данные и выполнять сложные вычисления. Более того, на каждом подчиненном узле выполняется задача.TracKerner и DataNode. Это позволяет синхронизировать процессы с NameNode и заданием.Tracкер соответственно.
В Hadoop главные или подчиненные системы могут быть развернуты в облаке или локально.
Небольшое замечание по поводу названия: работаTracкег и Сложность задачи Tracкег Они относятся к среде выполнения MapReduce первого поколения (MRv1). Начиная с Hadoop 2.x, YARN распределяет свои обязанности между кластером. РесурсМенеджер, чтобы Менеджер узлов на каждого работника и один Мастер приложений Для каждого задания. NameNode и DataNode остаются без изменений.
Особенности Hadoop
Подходит для анализа больших данных.
As Big Data Поскольку кластеры Hadoop, как правило, имеют распределенную и неструктурированную природу, они лучше всего подходят для анализа больших данных. Так как к вычислительным узлам поступает именно логика обработки (а не сами данные), потребляется меньше пропускной способности сети. Это называется концепция локальности данныхи это помогает повысить эффективность приложений на основе Hadoop.
Масштабируемость
Кластеры Hadoop легко масштабируются до любой степени за счет добавления дополнительных узлов кластера, что позволяет удовлетворять рост объемов больших данных. Кроме того, масштабирование не требует изменений в логике приложения.
Отказоустойчивость
Экосистема Hadoop предусматривает возможность репликации входных данных на другие узлы кластера. Таким образом, в случае отказа одного из узлов кластера обработка данных может продолжаться с использованием данных, хранящихся на другом узле кластера. HDFS по умолчанию хранит три копии каждого блока, это значение устанавливается пользователем. dfs.replication свойство, и NameNode повторно реплицирует любой блок, количество которых падает ниже этого значения.
Сетевая топология в Hadoop
Топология (расположение) сети влияет на производительность кластера Hadoop по мере его роста. Помимо производительности, необходимо также заботиться о высокой доступности и обработке сбоев. Для достижения этих целей при формировании кластера Hadoop используется топология сети.
Приведенная ниже схема показывает, как моделируется такая компоновка, от центра обработки данных до узлов внутри каждой стойки.

Как правило, пропускная способность сети является важным фактором, который необходимо учитывать при формировании любой сети. Однако, поскольку измерение пропускной способности может быть затруднительным, в Hadoop сеть представляется в виде дерева, и расстояние между узлами этого дерева (количество переходов) считается важным фактором при формировании кластера Hadoop. Здесь расстояние между двумя узлами равно сумме расстояний до их ближайшего общего предка.
Кластер Hadoop состоит из центра обработки данных, стойки и узла, который фактически выполняет задания. В данном случае центр обработки данных состоит из стоек, а стойка — из узлов. Доступная для процессов пропускная способность сети варьируется в зависимости от местоположения процессов. То есть доступная пропускная способность уменьшается по мере удаления от...
- Процессы на одном узле
- Разные узлы в одной стойке
- Узлы на разных стойках одного дата-центра
- Ноды в разных дата-центрах
Функция распознавания стоек использует одно и то же дерево: HDFS размещает реплики более чем в одной стойке, поэтому выход из строя коммутатора стойки не приводит к потере всех копий данных.
