
Хранилище данных Archiтектура, компоненты и диаграмма Concepts
 Дэвид Картер
⚡ Умное резюме
Хранилище данных ArchiАрхитектура определяет, как исторические и кумулятивные данные из множества источников организуются в многоуровневые структуры и взаимосвязанные компоненты, что обеспечивает надежную отчетность, анализ и единую версию истины для принятия организационных решений и прогнозирования.
Хранилище данных Concepts
A информационное хранилище Эта система существует для того, чтобы предоставить компании единую версию истины для принятия решений и прогнозирования. Это информационная система, которая хранит исторические и кумулятивные данные, полученные из одного или нескольких источников.
Организуя данные для анализа, а не для транзакций, хранилище данных упрощает работу по составлению отчетов и анализу всей организации.
Характеристики хранилища данных
Хранилище данных обладает четырьмя определяющими характеристиками, которые отличают его от обычной операционной базы данных:
- Предметно-ориентированный
- Комплексный
- Вариант времени
- Нелетучий
Предметно-ориентированный
Хранилище данных является предметно-ориентированным, поскольку оно предоставляет информацию по определенной тематике, а не о текущей деятельности компании. Типичные тематики включают продажи, маркетинг и дистрибуцию.
Вместо ежедневной обработки данных, хранилище информации делает упор на моделирование и анализ для принятия решений. Оно предлагает простое и лаконичное представление каждой темы и исключает данные, не поддерживающие процесс принятия решений.
Комплексный
Интеграция тесно связана с предметной ориентацией. В хранилище данных интеграция означает установление общей единицы измерения для всех аналогичных данных, полученных из различных баз данных, и хранение этих данных в общем, общепринятом виде.
Хранилище данных создается путем интеграции данных из различных источников, таких как мэйнфреймы, реляционные базы данных и текстовые файлы. Оно также должно поддерживать согласованные соглашения об именовании, форматах и кодировании.
Именно эта согласованность в наименовании, измерении атрибутов и структуре кодирования делает возможным эффективный анализ. Рассмотрим следующий пример:
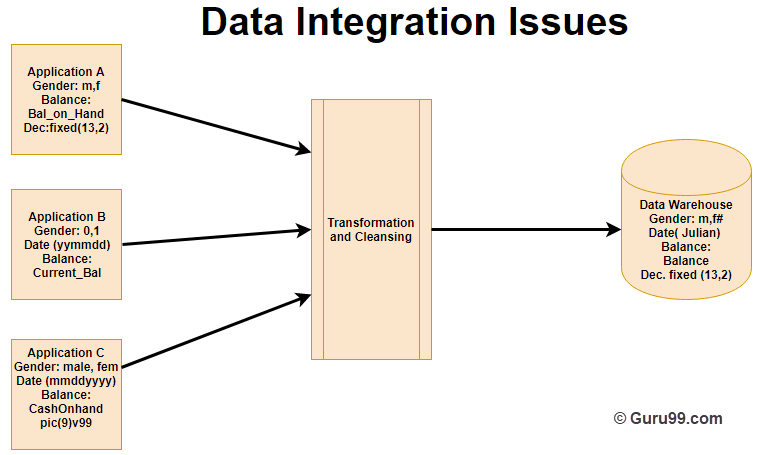
В приведенном выше примере три приложения, обозначенные буквами A, B и C, хранят информацию о поле, дате и балансе, но каждое приложение хранит ее по-своему:
- Приложение A хранит поле "Пол" в виде логических значений, таких как M или F.
- Приложение B сохраняет поле "Пол" в виде числового значения.
- В приложении C поле "Пол" хранится как символьное значение.
- Аналогичные изменения касаются полей «Дата» и «Баланс».
После преобразования и очистки все эти данные сохраняются в общем формате внутри хранилища данных.
Вариант времени
Временной горизонт хранилища данных значительно шире, чем у операционной системы. Данные привязаны к определенному периоду и представляют собой историческую перспективу, поэтому они всегда содержат элемент времени, явно или неявно.
Одно из мест, где проявляется это временное различие, — это структура ключа записи. Каждый первичный ключ в хранилище данных должен содержать элемент времени, например, день, неделя или месяц.
Ещё один аспект, связанный с временной изменчивостью, заключается в том, что после внесения данных в хранилище они не могут быть обновлены или изменены.
Нелетучий
Хранилище данных также является энергонезависимым, что означает, что ранее полученные данные не удаляются при поступлении новых. Данные доступны только для чтения и периодически обновляются, что помогает аналитикам изучать исторические данные и понимать, что происходило и когда.
Поскольку хранилище данных не требует обработки транзакций, восстановления или управления параллельным доступом, в нем отсутствуют операции удаления, обновления и вставки, характерные для операционных приложений. В хранилище данных выполняются только две операции:
- Загрузка данных
- Доступ к данным
В таблице ниже приведены основные различия между операционным приложением и хранилищем данных:
| Operaциональное применение | Хранилище данных |
|---|---|
| Сложная программа должна быть написана так, чтобы процессы обновления данных поддерживали высокую целостность конечного продукта. | Подобные проблемы не возникают, поскольку обновление данных не выполняется. |
| Данные размещаются в нормализованной форме, чтобы обеспечить минимальную избыточность. | Данные не сохраняются в нормализованной форме. |
| Технологии, необходимые для решения вопросов, связанных с транзакциями, восстановлением данных, откатом и разрешением взаимоблокировок, довольно сложны. | Он предлагает относительную простоту технологии. |
Хранилище данных Archiтекстура
Хранилище данных ArchiАрхитектура системы сложна, поскольку она хранит исторические и кумулятивные данные из множества источников. Существует три подхода к построению уровней хранилища данных: одноуровневый, двухуровневый и трехуровневый.
Одноуровневая архитектура Цель состоит в минимизации объема хранимых данных за счет устранения избыточности. На практике используется редко.
Двухуровневая архитектура Разделяет физически доступные источники данных от хранилища данных. Он не отличается лёгкой масштабируемостью, поддерживает меньшее количество конечных пользователей и может сталкиваться с проблемами подключения из-за ограничений сети.
Трехуровневая архитектура Это наиболее распространенная конструкция хранилища данных.
Она состоит из верхнего, среднего и нижнего ярусов:
- Нижний уровень: База данных склада служит нижним уровнем. Обычно это реляционная база данных, и данные очищаются, преобразуются и загружаются в этот слой с помощью внутренних инструментов.
- Средний уровень: Средний уровень представляет собой OLAP-сервер, реализованный с использованием модели ROLAP или MOLAP. Он обеспечивает абстракцию.tracОн обеспечивает представление базы данных и выступает в качестве посредника между конечным пользователем и базой данных.
- Верхний ярус: Верхний уровень — это клиентский интерфейс. Он содержит инструменты и API, используемые для подключения к хранилищу данных и их извлечения из него, такие как инструменты для выполнения запросов, инструменты для создания отчетов, инструменты для управления запросами, инструменты для анализа и инструменты для интеллектуального анализа данных.
Компоненты хранилища данных
Компоненты и общая архитектура хранилища данных взаимодействуют друг с другом, как показано на диаграмме ниже.
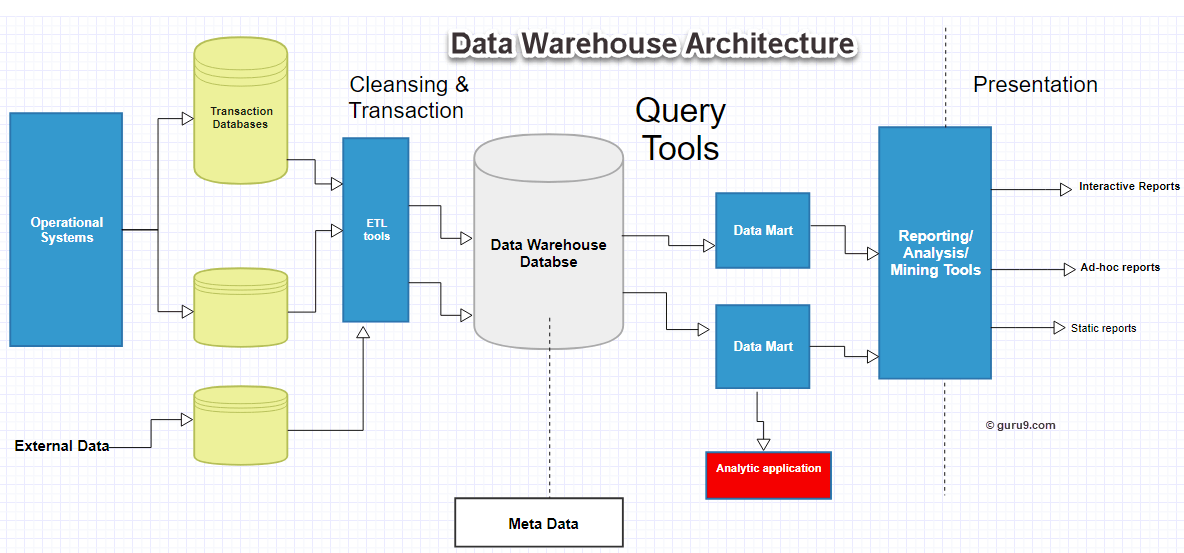
Хранилище данных основано на сервере реляционной СУБД, центральном хранилище информации, окруженном ключевыми компонентами, обеспечивающими функциональность, управляемость и доступность всей среды.
Хранилище данных состоит из пяти основных компонентов, описанных ниже.
База данных хранилища данных
Центральная база данных является основой среды хранения данных и реализуется на RDBMS технологии. Поскольку традиционная СУБД оптимизирована для обработки транзакций, а не для хранения данных, ресурсоемкие операции, такие как произвольные запросы, объединения нескольких таблиц и агрегатные операции, могут замедлять ее работу.
По этой причине используются альтернативные подходы к базам данных:
- Реляционные базы данных развертываются параллельно для обеспечения масштабируемости, используя модели с общей памятью или без общей памяти на различных многопроцессорных или массово-параллельных конфигурациях.
- Новые индексные структуры используются для обхода сканирования реляционных таблиц и повышения скорости.
- Многомерные базы данных (МББ) используются для преодоления ограничений реляционных моделей хранилищ данных. Примером может служить Essbase. Oracle.
Инструменты поиска, приобретения, очистки и преобразования (ETL)
Инструменты для сбора, преобразования и миграции данных выполняют все необходимые преобразования, обобщения и изменения для перевода данных в единый формат хранилища. Они также называются Ex.tracИнструменты t, Transform и Load (ETL).
Их функциональность включает в себя следующее:
- Анонимизация данных в соответствии с нормативными положениями.
- Перед загрузкой в хранилище данных удалите ненужные данные из операционных баз данных.
- Поиск и замена общих имен и определений для данных, поступающих из разных источников.
- Рассчитайте сводные данные и производные данные.
- Заполните недостающие данные значениями по умолчанию.
- Удаление дубликатов повторяющихся данных, поступающих из разных источников.
Эти Инструменты ETL может создавать задания cron, фоновые задания, программы на языке Cobol и сценарии оболочки, которые регулярно обновляют хранилище данных и помогают поддерживать метаданные.
Поскольку инструменты ETL используют данные из множества систем, они также должны справляться с неоднородностью баз данных и самих данных.
Метаданные
Метаданные могут звучать сложно, но на самом деле это просто данные о данных, определяющие хранилище. Они используются для создания, поддержки и управления хранилищем.
В рамках архитектуры метаданные определяют источник, использование, значения и характеристики данных, а также определяют, как данные могут быть изменены и обработаны, обеспечивая тем самым тесную связь с хранилищем данных.
Например, строка в базе данных продаж может содержать:
4030 KJ732 299.90
Это не имеет смысла, пока метаданные не объяснят, что это номер модели 4030, идентификатор торгового агента KJ732 и общая сумма продаж в размере 299.90 долларов США.
Таким образом, метаданные являются важнейшим элементом преобразования данных в знания и помогают ответить на такие вопросы, как:
- Какие таблицы, атрибуты и ключи содержит хранилище данных?
- Откуда взялись данные?
- Сколько раз происходит перезагрузка данных?
- Какие преобразования и очищения были применены?
Метаданные делятся на две категории:
- Технические метаданные: Это описание склада для проектировщиков и администраторов, которые его создают и эксплуатируют.
- Бизнес-метаданные: Это предоставляет конечным пользователям простой способ понять информацию, хранящуюся в хранилище данных.
Инструменты запросов
Основная цель хранилищ данных — предоставить предприятиям информацию, необходимую для принятия стратегических решений, а инструменты запросов — это способ взаимодействия пользователей с системой.
Эти инструменты делятся на четыре категории:
- Инструменты запросов и отчетов
- Инструменты разработки приложений
- Инструменты интеллектуального анализа данных
- OLAP-инструменты
Инструменты запросов и отчетов
Инструменты для создания запросов и отчетов делятся на две группы: инструменты для создания отчетов и инструменты для управления запросами.
Инструменты отчетности Далее подразделяются на инструменты для создания отчетов о производственной деятельности и инструменты для создания отчетов на настольных компьютерах:
- Авторы отчетов: Они предназначены для конечных пользователей, которые проводят собственный анализ.
- Отчетность о производстве: Эти системы позволяют организациям создавать регулярные оперативные отчеты и поддерживать пакетные задания большого объема, такие как печать и вычисления. Популярные примеры включают Brio, Business Objects. Oracle, PowerSoft и SAS Institute.
Инструменты управляемых запросов Это помогает конечным пользователям, внедряя мета-слой между пользователем и базой данных, который скрывает сложность SQL-запросов и структуру базы данных.
Инструменты разработки приложений
Когда встроенные графические и аналитические инструменты не могут удовлетворить аналитические потребности организации, создаются пользовательские отчеты с использованием инструментов разработки приложений.
Инструменты интеллектуального анализа данных
Анализ данных позволяет выявлять значимые новые корреляции, закономерности и тенденции в больших объемах данных, а инструменты анализа данных автоматизируют этот процесс.
Инструменты OLAP
OLAP Эти инструменты построены на основе многомерной базы данных и позволяют пользователям анализировать данные с помощью сложных многомерных представлений.
Шина хранилища данных Archiтекстура
Шина хранилища данных определяет, как данные перемещаются внутри хранилища. Этот поток можно разделить на входящий, восходящий, нисходящий, исходящий и метапоток.
При проектировании шины данных необходимо учитывать общие измерения и факты, которые охватывают все хранилища данных.
Витрины данных
A витрина данных Это уровень доступа, используемый для доставки данных пользователям. Он подходит для крупных хранилищ данных, поскольку требует меньше времени и денег на создание, хотя единого общепринятого определения хранилища данных не существует.
Проще говоря, витрина данных — это дочерняя структура хранилища данных. Она разделяет данные для определенной группы пользователей и может располагаться в той же базе данных, что и хранилище, или в физически отдельной базе данных.
Хранилище данных Archiлучшие практики
Для проектирования надежной архитектуры хранилища данных следуйте приведенным ниже рекомендациям:
- Используйте модели хранилищ данных, оптимизированные для поиска информации, независимо от того, является ли это... мерныхденормализованный или гибридный подход.
- Выберите подходящий подход к проектированию: нисходящий или восходящий.
- Обеспечьте быструю и точную обработку данных, объединив их в единую, достоверную версию.
- Тщательно продумайте процесс сбора и очистки данных для хранилища.
- Разработайте архитектуру метаданных, которая позволит совместно использовать метаданные между компонентами хранилища.
- Рассмотрим OperaМодель национального хранилища данных (ODS) применяется, когда потребности в извлечении данных находятся в нижней части абстракции данных.tracпирамидальная схема или когда необходимо получить доступ к нескольким операционным источникам.
- Убедитесь, что модель данных интегрирована, а не просто консолидирована; в этом случае используйте модель данных 3NF, которая также идеально подходит при приобретении инструментов ETL и очистки данных.
