
Что такое витрина данных в хранилище данных? Типы и примеры
 Дэвид Картер
⚡ Умное резюме
Проектирование хранилищ данных (Data Mart) предоставляет одному отделу целенаправленный набор информации из хранилища данных, охватывая три типа хранилищ данных, пять этапов от проектирования до управления, а также лучшие практики, обеспечивающие быструю, безопасную и экономически эффективную доставку.
Хранилище данных предоставляет аналитические возможности информационное хранилище для одной команды. Сосредоточившись на одной предметной области, это позволяет отделу быстро анализировать собственные данные, не дожидаясь обработки общекорпоративных задач. В разделах ниже объясняется, что такое хранилище данных, почему организации его используют, три доступных типа, а также как его внедрить и управлять им.
Что такое витрина данных?
Витрина данных ориентирована на одну функциональную область организации и содержит подмножество данных, хранящихся в... Хранилище данныхЭто сокращенная версия хранилища данных, предназначенная для использования конкретным отделом, подразделением или группой пользователей — например, отделом маркетинга, продаж, отделом кадров или финансовым отделом.
Поскольку хранилище данных выполняет одну функцию, оно обычно контролируется одним отделом внутри организации. Такая направленность позволяет сузить его сферу применения и четко определить ответственных за него лиц.
В отличие от хранилища данных, которое объединяет множество источников, витрина данных также получает данные только из нескольких источников. В результате витрины данных имеют небольшие размеры и гораздо большую гибкость, чем полноценное хранилище данных.
Зачем нам нужен Data Mart?
Организации используют хранилища данных по нескольким практическим причинам:
- Витрина данных улучшает время отклика пользователей за счет уменьшения объема запрашиваемых ими данных.
- Он обеспечивает легкий доступ к часто запрашиваемым данным.
- Внедрение хранилища данных (data mart) проще и дешевле, чем внедрение корпоративного хранилища данных (corporate data storage).
- Это гибкий подход: при изменении модели можно быстро перестроить хранилище данных меньшего размера.
- Концепция хранилища данных (data mart) определяется одним экспертом в данной области, тогда как концепция междисциплинарного хранилища данных (data warehouse) определяется междисциплинарной командой, поэтому хранилище данных более открыто для изменений.
- Данные разделены на разделы, что позволяет осуществлять очень детальный контроль доступа.
- Данные могут быть сегментированы и храниться на различных аппаратных или программных платформах.
Вкратце, поскольку витрина данных обрабатывает меньший, четко определенный фрагмент данных, ее быстрее создать, дешевле эксплуатировать и проще защитить, чем корпоративное хранилище данных.
Однако не все хранилища данных строятся одинаково. Источник данных, из которого хранилище получает информацию, определяет, с каким из трех типов данных вы работаете.
Типы витрин данных
Существует три основных типа хранилищ данных, различающихся источником данных:
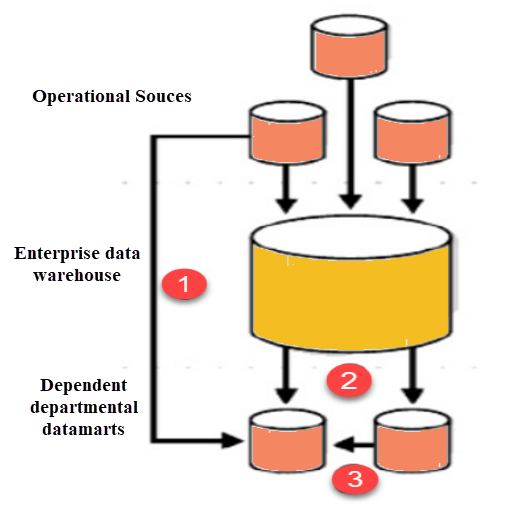
- Иждивенец: Зависимые хранилища данных получают данные непосредственно из оперативных источников, внешних источников или из обоих источников одновременно.
- Независимый: Создается независимое хранилище данных без центрального хранилища данных.
- Гибридная: Гибридное хранилище данных может получать данные из хранилищ данных или операционных систем.
Зависимая витрина данных
Зависимое хранилище данных получает данные организации из единого хранилища данных, что обеспечивает ему преимущество централизации. Если вам необходимо создать одно или несколько физических хранилищ данных, вы настраиваете их как зависимые хранилища данных.
Взаимозависимое хранилище данных можно построить двумя способами: первый — когда пользователи получают доступ как к хранилищу данных, так и к основному хранилищу данных в зависимости от потребностей, и второй — когда доступ ограничен только хранилищем данных. Второй подход не является оптимальным, поскольку он может привести к созданию «свалки данных» — данных, которые изначально поступают из общего источника, но затем удаляются и в значительной степени остаются неиспользованными.

Независимый киоск данных
Независимое хранилище данных создается без центрального хранилища данных. Такое хранилище данных идеально подходит для небольших подразделений внутри организации.
Независимое хранилище данных не связано с корпоративным хранилищем данных или с каким-либо другим хранилищем данных. Его данные загружаются и анализируются самостоятельно. Такой подход противоречит основной причине создания хранилища данных: это согласованное, централизованное хранилище корпоративных данных, которое могут анализировать множество пользователей с различными интересами.

Гибридный киоск данных
Гибридное хранилище данных объединяет данные из источников, находящихся за пределами основного хранилища данных. Это полезно, когда требуется интеграция по мере необходимости — например, после добавления новой группы или продукта в организацию.
Он хорошо подходит для сред с несколькими базами данных и обеспечивает быструю реализацию с минимальными усилиями по очистке данных. Гибридное хранилище данных также поддерживает большие структуры хранения и хорошо работает для небольших, ориентированных на данные приложений.
Шаги по реализации витрины данных

Внедрение хранилища данных — это трудоемкий, но требующий тщательного подхода процесс. Он состоит из пяти этапов: проектирование, создание, заполнение, доступ и управление — каждый из которых описан ниже.
Проектирование
Проектирование — это первый этап внедрения хранилища данных. Он охватывает все задачи, начиная с первоначального запроса на создание хранилища данных и заканчивая сбором требований, и завершается логическим и физическим проектированием хранилища данных.
Этап проектирования включает в себя следующие задачи:
- Сбор бизнес- и технических требований и определение источников данных.
- Выбор подходящего подмножества данных.
- Проектирование логической и физической структуры витрины данных.
Данные можно разделить на категории на основе следующих критериев:
- Время
- Бизнес-подразделение или функциональная единица
- География
- Любая комбинация вышеперечисленного
Разделение данных может осуществляться на уровне приложения или СУБД, хотя рекомендуется разделение на уровне приложения, поскольку это позволяет использовать разные модели данных каждый год в зависимости от изменений в бизнес-среде. Большинство хранилищ данных построены на основе габаритная модельнапример, звездообразная схема, чтобы запросы выполнялись быстро.
Какие продукты и технологии вам необходимы?
На данном этапе достаточно обычной ручки и бумаги. Инструменты, помогающие создавать UML-диаграммы или диаграммы «сущность-связь», также могут добавлять метаданные к вашим логическим и физическим проектам.
строительство
Построение — это второй этап реализации. Он включает в себя создание физической базы данных и логических структур.
Этот этап включает в себя следующую задачу:
- Реализация физической базы данных, разработанной на предыдущем этапе, — например, создание объектов схемы, таких как таблицы, индексы и представления.
Какие продукты и технологии вам необходимы?
Для создания хранилища данных вам необходима реляционная система управления базами данных (СУБД). СУБД предоставляет ряд функций, которые имеют решающее значение для успеха хранилища данных:
- Управление хранилищем: СУБД хранит и управляет данными, позволяя создавать, добавлять и удалять записи.
- Быстрый доступ к данным: С помощью SQL-запроса можно легко получить данные на основе определенных условий или фильтров.
- Защита личных данных: СУБД способна восстанавливаться после системных сбоев, таких как отключение электроэнергии, и восстанавливать данные из резервных копий в случае отказа диска.
- Многопользовательская поддержка: Она обеспечивает одновременный доступ, поэтому несколько пользователей могут читать и изменять данные, не перезаписывая изменения друг друга.
- Безопасность: Оно регулирует, какие пользователи могут получать доступ к каким объектам и какие операции они могут выполнять.
Заполнение
На третьем этапе данные заполняют хранилище данных.
Этап заполнения включает в себя следующие задачи:
- Картаping Преобразование исходных данных в целевые.
- Extracтинг исходных данных.
- Очистка и преобразование данных.
- Загрузка данных в хранилище данных.
- Создание и хранение метаданных.
Какие продукты и технологии вам необходимы?
Эти задачи выполняются с помощью ETL (например,tracИнструмент (t, Transform, Load). Он анализирует источники данных и выполняет сопоставление источника и цели.pingа затем эксtracвыполняет преобразование, очистку и загрузку данных в хранилище данных.
В процессе работы инструмент также создает метаданные — такие детали, как источник данных, их актуальность, внесенные изменения и уровень обобщения.
Доступ к
Четвертый шаг — это доступ к данным, на котором они используются: запрашиваются данные, создаются отчеты и диаграммы, а также публикуются. Конечные пользователи отправляют запросы и просматривают результаты, часто через OLAP инструментов.
Этап доступа включает в себя следующие задачи:
- Создание метаслоя, который преобразует структуры базы данных и имена объектов в бизнес-термины, чтобы нетехнические пользователи могли легко получить доступ к хранилищу данных.
- Настройка и поддержка структур базы данных.
- Настройка API и интерфейсов при необходимости.
Какие продукты и технологии вам необходимы?
Доступ к хранилищу данных можно получить с помощью командной строки или графического интерфейса пользователя (GUI). Графический интерфейс обычно предпочтительнее, поскольку он легко генерирует графики и более удобен в использовании, чем командная строка.
Управление
Управление — это заключительный этап процесса внедрения хранилища данных. Используя графический интерфейс или командную строку, команды выполняют текущие задачи управления, такие как:
- Постоянное управление доступом пользователей.
- Оптимизация и тонкая настройка системы для повышения производительности.
- Добавление и управление актуальными данными в хранилище данных.
- Разработка сценариев восстановления для обеспечения доступности системы в случае сбоя.
- Восстановление после аппаратных и программных сбоев с сохранением данных.
лучшие практики внедрения витрин данных
В процессе внедрения хранилища данных следуйте этим рекомендациям:
- Структурируйте источник данных для хранилища данных по отделам.
- Измеряйте цикл внедрения в неделях, а не в месяцах или годах.
- Привлекайте всех заинтересованных сторон к этапу планирования и проектирования, поскольку внедрение хранилища данных может быть сложным процессом.
- Составьте точный бюджет на оборудование, программное обеспечение, сетевые ресурсы и внедрение систем для хранилищ данных.
- Даже если хранилище данных использует общее оборудование, для обработки запросов пользователей может потребоваться различное программное обеспечение; оцените дополнительную вычислительную мощность и объем памяти, необходимые для быстрого ответа.
- Если хранилище данных (data mart) расположено в другом месте, чем основное хранилище данных (data storage), необходимо обеспечить достаточную пропускную способность сети для перемещения требуемых объемов данных.
- Заложите в бюджет время загрузки, которое увеличивается по мере роста сложности преобразований.
Преимущества и недостатки витрины данных
Как и любое архитектурное решение, хранилище данных приносит очевидные преимущества, но сопряжено и с некоторыми компромиссами.
Преимущества
- В хранилище данных хранится подмножество общеорганизационных данных, представляющих ценность для определенной группы пользователей.
- Это экономически выгодная альтернатива хранилищу данных, создание которого может быть дорогостоящим.
- Хранилище данных обеспечивает более быстрый доступ к данным.
- Он прост в использовании, поскольку разработан с учетом специфических потребностей пользователей, что позволяет ускорить бизнес-процессы.
- Внедрение хранилища данных (data mart) занимает меньше времени, чем создание подмножества данных (data warehouse), поскольку вы фокусируетесь только на части данных.
- Он содержит исторические данные, которые помогают аналитикам выявлять тенденции.
Недостатки
- Иногда предприятия создают слишком много разрозненных, не связанных между собой хранилищ данных, которые становится сложно поддерживать.
- Хранилище данных не может обеспечить анализ данных в масштабах всей компании, поскольку его набор данных ограничен.
