
Hive ETL: загрузка JSON, XML, примеров текстовых данных
 Редакционная коллегия
⚡ Умное резюме
Hive ETL преобразует текстовые, XML и JSON-файлы в таблицы, доступные для запросов, путем загрузки их в Hive и последующего анализа.tracОбработка значений с помощью функций xpath() и get_json_object(), предоставляя аналитикам SQL-интерфейс для работы с полуструктурированными данными Hadoop.

Hive как инструмент ETL и хранилища данных поверх... Hadoop Экосистема предоставляет такие функции, как моделирование данных, манипулирование данными, обработка данных и выполнение запросов к данным.tracВ Hive под "загрузкой" данных понимается создание таблиц, загрузка структурированных и полуструктурированных данных, а также выполнение запросов к данным в соответствии с требованиями.
Для пакетной обработки мы будем писать собственные скрипты, используя скрипты map и reduce на языке сценариев. Это обеспечивает SQL например, среда и поддержка простых запросов.
Работа со структурированными данными с помощью Hive
Структурированные данные означают, что данные представлены в правильном формате строк и столбцов. Это больше похоже на... RDBMS данные с соответствующими строками и столбцами.
Здесь мы будем загружать структурированные данные из текстовых файлов в Hive.
Шаг 1) На этом этапе мы создаем таблицу «employees_guru» с именами столбцов, такими как идентификатор, имя, возраст, адрес, зарплата и отдел сотрудников, с типами данных.

На приведенном выше скриншоте можно заметить следующее:
- Создание таблицы «сотрудники_гуру»
- Загрузка данных из файла Employees.txt в таблицу “employees_guru”
Шаг 2) На этом шаге мы отображаем содержимое этой таблицы с помощью команды «Выбрать». Содержимое таблицы можно увидеть на следующем скриншоте.

Пример фрагмента кода
Запросы, которые необходимо выполнить
1) Create table employees_guru(Id INT, Name STRING, Age INT, Address STRING, Salary FLOAT, Department STRING)
> Row format delimited
> Fields terminated by ',';
2) load data local inpath '/home/hduser/Employees.txt' into TABLE employees_guru;
3) select * from employees_guru;
Работа с полуструктурированными данными с использованием Hive (XML, JSON)
Hive выполняет функции ETL в экосистеме Hadoop, выступая в качестве... Инструмент ETLВ некоторых типах приложений выполнение MapReduce может быть сложным; Hive может упростить этот процесс и предоставляет наилучшее решение для ИТ-приложений в сфере хранилищ данных.
Полуструктурированные данные, такие как XML и JSON, можно обрабатывать с меньшей сложностью с помощью Hive. Сначала мы рассмотрим, как можно использовать Hive для... XML.
XML в таблицу Hive
При этом мы собираемся загрузить данные XML в таблицы Hive и получить значения, хранящиеся внутри тегов XML.
Шаг 1) Создание таблицы “xmlsample_guru” со столбцом типа str, содержащим строковые данные.

На приведенном выше скриншоте можно заметить следующее:
- Создание таблицы «xmlsample_guru»
- Загрузка данных из файла test.xml в таблицу “xmlsample_guru”
Шаг 2) Посмотрите на график XPath С помощью метода xpath() мы сможем получить данные, хранящиеся внутри XML-тегов.
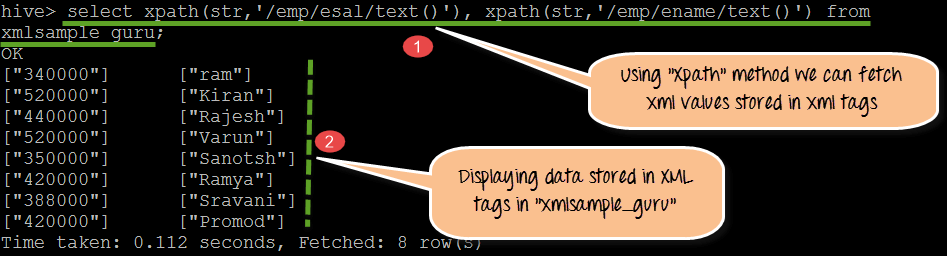
На приведенном выше скриншоте можно заметить следующее:
- Используя метод xpath(), мы получаем значения, хранящиеся в каталогах /emp/esal/ и /emp/ename/.
- Значения, находящиеся внутри XML-тегов. На этом шаге мы отображаем фактические значения, хранящиеся внутри XML-тегов в таблице «xmlsample_guru».
Обратите внимание, что функция xpath() возвращает массив строк; функции xpath_string(), xpath_int() и xpath_double() возвращают одно типизированное значение.
Шаг 3) На этом этапе мы получим и отобразим необработанный XML-код таблицы «xmlsample_guru».

На приведенном выше скриншоте можно заметить следующее:
- Фактические данные XML отображаются с помощью тегов
- Если мы рассмотрим отдельный тег, то увидим, что родительским тегом является «emp», а дочерними — «ename» и «esal».
Code фрагмент:
Запросы, которые необходимо выполнить
1) create table xmlsample_guru(str string);                                                                                                   2) load data local inpath '/home/hduser/test.xml' overwrite  into table xmlsample_guru;
3) select xpath(str,'emp/ename/text()'), xpath(str,'emp/esal/text()') from xmlsample_guru;
JSON (JavaОбозначение объекта скрипта)
Данные из социальных сетей и веб-сайтов обычно хранятся в формате JSON. При попытке получить данные с онлайн-серверов мы получаем файлы JSON. Используя Hive в качестве хранилища данных, мы можем загружать данные JSON в таблицы Hive, создавая схемы.
Преобразование JSON в таблицу Hive
В этом примере мы загрузим данные в формате JSON в таблицы Hive и получим значения, хранящиеся в схеме JSON.
Шаг 1) На этом этапе мы создадим JSON-таблицу с именем «json_guru». После создания мы загрузим и отобразим содержимое фактической схемы.

На приведенном выше скриншоте можно заметить следующее:
- Создание таблицы «json_guru»
- Загрузка данных из файла test.json в таблицу “json_guru”
- Отображение фактической схемы JSON-файла, хранящегося в таблице json_guru.
Шаг 2) С помощью метода get_json_object() мы можем получить значения данных, хранящиеся в иерархии JSON.

На приведенном выше скриншоте можно заметить следующее:
- Используя функцию get_json_object(str,'$.ecode'), можно получить значения ecode из таблицы json_guru. Аналогично, используя функции get_json_object(str,'$.ename') и get_json_object(str,'$.sal'), можно получить значения ename и sal из таблицы json_guru.
- Значения хранятся внутри иерархии JSON в json_guru.
Поскольку функция get_json_object() анализирует документ один раз за вызов, json_tuple() оказывается дешевле, когда требуется несколько ключей, а JSON SerDe сопоставляет документ с типизированными столбцами во время загрузки.
Code отрывок
Запросы, которые необходимо выполнить
1) create table json_guru(str string);
2) load data inpath 'home/hduser/test.json' into table json_guru;
3) select * from json_guru;
4) select get_json_object(str,'$.ecode') as ecode, get_json_object(str,'$.ename') as ename ,get_json_object(str,'$.sal') as salary from json_guru;
Преобразование сложного JSON в таблицу Hive
В этом примере мы будем загружать сложные данные в формате JSON в таблицы Hive и извлекать значения, хранящиеся в схеме JSON.
Шаг 1) Создание объекта complexjson_guru с одним столбцом.

На приведенном выше скриншоте можно заметить следующее:
- Создание таблицы complexjson_guru с одним столбцом, содержащим строковый тип данных.
- Загрузка данных в complexjson_guru из сложного JSON-файла emp.json.
Шаг 2) С помощью функции get_json_object мы можем получить фактическое содержимое, хранящееся в иерархии JSON-файлов.
На следующем скриншоте мы видим результат обработки данных, хранящихся в complexjson_guru.
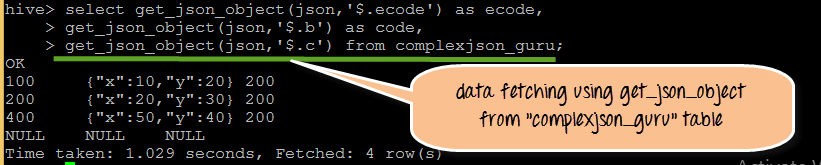
Шаг 3) На этом этапе, используя команду «Select», мы можем увидеть сложные данные JSON, хранящиеся в таблице «complexjson_guru».

Пример фрагмента кода
Запросы, которые необходимо выполнить
1) create table complexjson_guru(json string);
2) load data inpath 'home/hduser/emp.json' into table complexjson_guru;
3) select get_json_object(json,'$.ecode') as ecode ,get_json_object(json,'$.b') as code, get_json_object(json,'$.c') from complexjson_guru;
4) select * from complexjson_guru;
Использование Hive в проектах реального времени: когда и где.
Когда и где использовать Hive в экосистеме Hadoop:
После появления
- При работе с мощными статистическими функциями в экосистеме Hadoop
- При работе со структурированными и полуструктурированными данными
- В качестве инструмента для хранилищ данных с использованием Hadoop.
- Ввод данных в реальном времени с помощью HBase, где также может использоваться Hive.
где
- Для удобства использования в качестве инструмента ETL и хранилища данных.
- Для обеспечения среды, аналогичной SQL, и выполнения запросов по типу SQL с использованием HiveQL.
- Использование и развертывание специально разработанных скриптов map и reducer в соответствии с требованиями клиента.
