
Создайте и поместите ИНДЕКС в Cassandra
 Дэвид Картер
⚡ Умное резюме
Создать и удалить индекс в Cassandra Позволяет фильтровать данные по столбцам, не входящим в первичный ключ. На этой странице рассматриваются команды CREATE INDEX и DROP INDEX, правила именования, доступные типы индексов и случаи, когда создание индекса является неверным решением.
Cassandra Создать индекс
Команда «Создать индекс» создает индекс по столбцу, указанному пользователем. Если данные для столбца, который вы хотите индексировать, уже существуют, Cassandra создает индексы данных во время выполнения инструкции create index.
- После создания индекса Cassandra автоматически индексирует новые данные при вставке данных.
- Индекс не может быть создан для первичного ключа, поскольку первичный ключ уже проиндексирован.
- Поддерживается создание индексов по столбцам коллекций с использованием форматов KEYS, VALUES или ENTRIES в зависимости от того, что необходимо искать.
- Без индексации по столбцу, Cassandra Фильтрация по этому столбцу невозможна, если он не является первичным ключом.
Вот почему для фильтрации столбцов в CassandraНеобходимо создать индексы.
Синтаксис
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
Пример
Вот снимок, где была попытка отфильтровать столбец «dept» без создания индекса. В ответ была возвращена ошибка.

Вот снимок, где индекс создается в столбце отдела.

CREATE INDEX DeptIndex ON University.Student (dept);
Вот снимок, на котором будет успешно отфильтрован столбец «отдел».

SELECT * FROM University.Student WHERE dept = 'CS';
Имя индекса необязательно. Его отсутствие позволяет Cassandra автоматически генерирует его, что важно, когда впоследствии потребуется удалить индекс.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Индекс падения
Команда «Удалить индекс» удаляет указанный индекс. Если имя индекса не было указано при создании индекса, то имя индекса — TableName_ColumnName_idx.
- Если индекс не существует, он вернет ошибку, если не используется IF EXISTS, который вернет отсутствие операции.
- Необходимо указать имя пространства ключей вместе с именем индекса, иначе поиск индекса будет производиться в текущем пространстве ключей.
Синтаксис
DROP INDEX IF EXISTS KeyspaceName.IndexName;
Пример
Вот снимок выполненной команды «Удалить индекс», которая удаляет индекс DeptIndex.
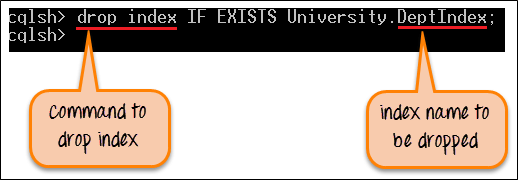
DROP INDEX IF EXISTS University.DeptIndex;
После успешного выполнения команды DeptIndex будет удален из пространства ключей. Теперь данные нельзя фильтровать по столбцу dept.
Чтобы подтвердить, какие индексы существуют, перед падениемping Во-первых, опишите таблицу и прочтите определения индексов в нижней части выходных данных.
DESCRIBE TABLE University.Student;
Типы индексов в Cassandra
Приведённая выше команда создаёт стандартный вторичный индекс, но существуют три различных механизма, и они ведут себя совершенно по-разному.
| Тип | Как заказать? | лучше всего для |
|---|---|---|
| Вторичный индекс | Каждый узел индексирует только свои локальные данные, поэтому запрос без ключа раздела должен обращаться ко всем узлам. | Запросы к столбцам со средней мощностью множества выполняются совместно с ключом раздела. |
| индекс SASI | Прилагаемый индекс поддерживает сопоставление по префиксу и суффиксу с помощью оператора LIKE, а также числовые диапазоны. | Шаблоны поиска текста. Пока помечены как экспериментальные, поэтому протестируйте перед использованием в производственной среде. |
| Индекс, прикрепленный к хранилищу (SAI) | Представлено в Cassandra 5.0, использование одной структуры индекса для всех столбцов с меньшими накладными расходами на запись. | Современная замена обоим вышеупомянутым вариантам на Cassandra 5 кластеров. |
Индексирование столбца коллекции осуществляется с помощью модификатора, указывающего, какую часть следует индексировать.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VALUES выполняет поиск по элементам множества или списка, KEYS — по ключам карты, а ENTRIES сопоставляет пары ключ-значение. Индексирование коллекций более подробно описано в разделе Cassandra коллекции учебное пособие.
Когда не следует использовать указатель в Cassandra
Вторичный индекс удобен, но это не реляционный индекс, и его использование не в том месте является распространенной причиной медленной работы кластеров. В четырех ситуациях требуется иной подход.
- Очень высокая мощность множества. Индексирование чего-либо, близкого к уникальному, например, адреса электронной почты, означает, что почти каждый раздел содержит одну соответствующую строку, поэтому запрос распространяется по всему кластеру, чтобы вернуть одну запись.
- Очень низкая мощность множества. Индексирование двухзначного флага, такого как active или inactive, приводит к созданию огромных разделов индекса, и чтение одного из них возвращает половину таблицы.
- Столбцы, которые часто обновляются. Каждое изменение записывает новую запись в индекс и "надгробный камень" для старой записи, поэтому накопление "надгробных камней" со временем ухудшает качество чтения.
- Запросы без ключа раздела. Без него координатору приходится связываться с каждым узлом и объединять результаты, что не масштабируется по мере добавления узлов.
Надежной альтернативой является вторая таблица, ключом к которой является столбец, требующий поиска, и которая создается одновременно с первой. Это соответствует принципу «запрос прежде всего», описанному в [ссылка на источник]. Cassandra правила модели данныхи это позволяет выполнять каждое чтение в одном разделе на одном узле.
Как правило, индекс подходит для столбца со средней мощностью, который запрашивается вместе с известным ключом раздела. Для всего, что выходит за рамки этого описания, лучше использовать специально созданную таблицу.
