
Учебное пособие по искусственным нейронным сетям (ИНС) с использованием TensorFlow.
 Эвелин Кларк
⚡ Умное резюме
Искусственные нейронные сети обучаются, пропуская входные данные через связанные слои, оценивая результат с помощью функции потерь и корректируя веса с помощью оптимизатора. В этом пошаговом руководстве показана создание такой сети в TensorFlow и классификация цифр из набора данных MNIST.
Что такое искусственная нейронная сеть?
An Искусственная нейронная сеть (ИНС) Искусственная нейронная сеть — это компьютерная система, созданная по образцу биологических нейронных сетей для формирования искусственного мозга на основе совокупности соединенных между собой элементов, называемых искусственными нейронами. Она предназначена для анализа и обработки информации так же, как это делают люди. Искусственная нейронная сеть обладает способностью к самообучению, что позволяет ей показывать лучшие результаты по мере увеличения объема доступных данных.
Схема ниже tracЭто один полный проход через такую сеть, от исходных данных до оптимизатора, который корректирует веса.

Искусственная нейронная сеть (ИНС) состоит из четырех основных объектов:
- Количество слоёв: Обучение происходит внутри слоев. Всего три слоя: 1) входной, 2) скрытый и 3) выходной.
- Характеристика и метка: Входные данные для сети (признаки) и выходные данные из сети (метки).
- Функция потерь: Метрика, используемая для оценки эффективности этапа обучения.
- Оптимизатор: Улучшите процесс обучения, обновляя знания в сети.
Нейронная сеть принимает входные данные и подает их в ансамбль слоев. Затем сеть оценивает свою производительность с помощью функции потерь. Функция потерь дает сети представление о пути, который ей необходимо пройти, прежде чем она освоит необходимые знания. Сеть улучшает эти знания с помощью оптимизатора.
Если вы посмотрите на рисунок выше, вы поймете основной механизм.
Программа принимает на вход некоторые значения и передает их в два полносвязанных слоя. Представьте, что у вас есть математическая задача. Первое, что вы делаете, это читаете соответствующую главу, чтобы решить её. Затем вы применяете свои новые знания к задаче. Велика вероятность, что вы не покажете очень хороший результат. То же самое происходит и с нейронной сетью: при первом просмотре данных и прогнозировании результат не будет идеально соответствовать фактическим данным.
Для улучшения своих знаний нейронная сеть использует оптимизатор. В этой аналогии оптимизатор можно представить как повторное чтение главы. Перечитывая, вы получаете новые знания. Аналогично, нейронная сеть использует оптимизатор, обновляет свои знания и проверяет эти новые знания, чтобы определить, сколько ей еще нужно узнать. Программа повторяет этот шаг до тех пор, пока не совершит минимально возможную ошибку.
В аналогии с математической задачей это означает, что вы многократно перечитываете главу учебника, пока полностью не поймете содержание курса. Даже после многократного прочтения, если вы продолжаете допускать ошибки, это означает, что вы достигли предела знаний по текущему материалу. Вам нужно использовать другой учебник или попробовать другой метод, чтобы улучшить свой результат. Для нейронной сети процесс тот же. Если количество ошибок перестает уменьшаться, а кривая потерь становится плоской, текущая архитектура не может ничему больше научиться. Сеть необходимо оптимизировать, чтобы расширить знания.
Эти четыре объекта напрямую соответствуют компонентам, которые вы настраиваете при проектировании сети.
Нейронная сеть Archiтекстура
Архитектура искусственной нейронной сети состоит из следующих компонентов:
- Слои
- Функция активации
- Функция потери
- Оптимизатор
Слои
Слой — это место, где происходит всё обучение. Внутри слоя находится произвольное количество нейронов, каждый из которых имеет свои собственные веса. Типичная нейронная сеть часто обрабатывается плотно связанными слоями (также называемыми полносвязными слоями). Это означает, что все входные данные соединены с выходными.
Типичная нейронная сеть принимает на вход вектор и скаляр, содержащий метки. Простейшая схема — это бинарная классификация всего с двумя классами: 0 и 1.
Сеть принимает входные данные, отправляет их всем подключенным узлам и вычисляет сигнал с помощью функции активации. На приведенной ниже пронумерованной диаграмме показан отдельный узел, что позволяет отдельно увидеть взвешенную сумму и этап активации.

На рисунке выше эта идея наглядно представлена. Первый слой содержит входные значения. Второй слой, называемый скрытым слоем, получает взвешенные входные данные от предыдущего слоя.
- Первый узел — это входные значения.
- Нейрон разлагается на входную часть и функцию активации. Левая часть получает весь входной сигнал от предыдущего слоя. Правая часть представляет собой сумму входных сигналов, поступающих в функцию активации.
- Выходное значение вычисляется на основе скрытых слоев и используется для прогнозирования. Для классификации оно равно количеству классов. Для регрессии прогнозируется только одно значение.
Функция активации
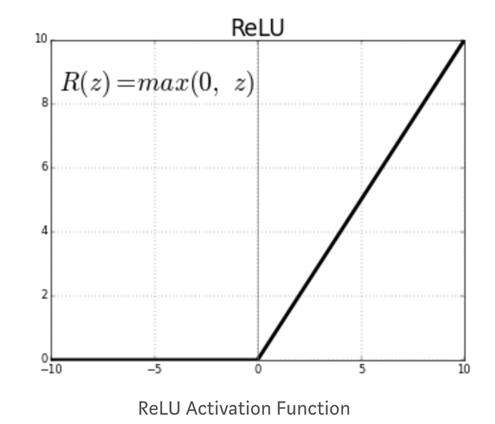
Функция активации узла определяет выходной сигнал при заданном наборе входных данных. Функция активации необходима для того, чтобы сеть могла обучаться нелинейным закономерностям. Распространенной функцией активации является ReLU (Rectified Linear Unit). Эта функция возвращает ноль для всех отрицательных значений.
Другие функции активации:
- Кусочно-линейный
- сигмоид
- Тань
- Дырявый ReLU
Приведенный ниже график объясняет, почему функция активации ReLU описывается именно таким образом: кривая пологая в точке нуля для каждого отрицательного входного значения и затем линейно возрастает.
Критическое решение, которое необходимо принять при построении нейронной сети:
- Сколько слоев в нейронной сети
- Сколько скрытых единиц для каждого слоя
Нейронные сети с большим количеством слоев и скрытых нейронов способны обучаться сложному представлению данных, но при этом делают вычисления в сети очень затратными.
Функция потери
После того, как вы определили скрытые слои и функцию активации, вам необходимо указать функцию потерь и оптимизатор.
Для бинарной классификации обычно используется функция потерь бинарной кросс-энтропии. линейная регрессияДля этого используется среднеквадратная ошибка.
Функция потерь является важным показателем для оценки производительности оптимизатора. Во время обучения эта метрика будет сведена к минимуму. Вам необходимо тщательно выбирать это количество в зависимости от типа проблемы, с которой вы имеете дело.
Оптимизатор
Функция потерь — это мера производительности модели. Оптимизатор помогает улучшить веса сети, чтобы уменьшить потери. Существуют различные оптимизаторы, но наиболее распространенным является стохастический градиентный спуск.
Обычные оптимизаторы:
- Momentum оптимизации
- Ускоренный градиент Нестерова
- АдаГрад
- Оптимизация Адама
ArchiОдна лишь архитектура не гарантирует работоспособность модели.
Ограничения нейронной сети
Ниже перечислены ограничения нейронной сети:
переобучения
Распространенная проблема сложных нейронных сетей — это сложность обобщения на ранее не встречавшиеся данные. Нейронная сеть с большим количеством весов может очень хорошо идентифицировать конкретные детали в обучающем наборе данных, но это часто приводит к переобучению. Если данные несбалансированы внутри групп (то есть, в некоторых группах недостаточно данных), сеть будет очень хорошо обучаться во время тренировки, но не сможет обобщить такие закономерности на ранее не встречавшиеся данные.
В этом случае приходится идти на компромисс. машинного обучения или Между оптимизацией и обобщением.
- Оптимизация модели требует поиска наилучших параметров, которые минимизируют потери на обучающем наборе данных.
- Однако обобщение показывает, как модель ведет себя для невидимых данных.
Чтобы предотвратить уловку моделью специфических деталей или нежелательных закономерностей обучающих данных, можно использовать различные методы. Лучший метод — это сбалансированный набор данных с достаточным их количеством. Искусство уменьшения переобучения называется регуляризацией. Три метода, описанные ниже, являются общепринятыми отправными точками.
| Техника | Что это ограничивает | Типичные настройки в этом руководстве |
|---|---|---|
| Размер сети | Количество слоев и скрытых элементов | Два скрытых слоя, 300 и 100 единиц. |
| Регуляризация весов L1/L2 | Величина весовых коэффициентов | Значения l1_regularization_strength и l2_regularization_strength равны 0.01. |
| отсев | Доля отключенных устройств на каждом этапе обучения | отсев 0.3 |
Размер сети
Нейронная сеть со слишком большим количеством слоев и скрытых нейронов, как известно, является очень сложной. Простой способ уменьшить сложность модели — уменьшить ее размер. Единого оптимального способа определения количества слоев не существует. Необходимо начать с небольшого количества слоев и увеличивать их размер до тех пор, пока модель не начнет переобучаться.
Регулировка веса
Стандартный метод предотвращения переобучения заключается в добавлении ограничений к весам сети. Ограничение заставляет веса сети принимать только малые значения. Ограничение добавляется к функции потерь ошибки. Существует два вида регуляризации:
- L1 (Лассо): Стоимость пропорциональна абсолютному значению весовых коэффициентов.
- L2 (Гребень): Стоимость пропорциональна квадрату значения весовых коэффициентов.
отсев
Dropout — это необычная, но полезная техника. В нейронной сети с Dropout некоторые нейроны случайным образом отключаются на этапе обучения, так что их исходящий сигнал становится равным нулю. Представьте, что у вас есть массив весов [0.1, 1.7, 0.7, -0.9]. Если нейронная сеть использует Dropout, она станет [0.1, 0, 0, -0.9] со случайным распределением нулей. Параметр, управляющий Dropout, — это коэффициент Dropout. Коэффициент определяет, сколько нейронов отключается. Часто встречается значение от 0.2 до 0.5.
Небольшой интерактивный пример позволяет легко наблюдать за процессом обучения.
Пример нейронной сети в TensorFlow
Вот пример работы искусственной нейронной сети, демонстрирующий, как она решает типичную задачу классификации. На вход подаются два значения, x1 и x2, каждое из которых имеет случайную величину. Выходные данные представляют собой бинарный класс. Цель состоит в классификации метки на основе этих двух признаков. Для решения этой задачи архитектура нейронной сети определяется следующим образом:
- Два скрытых слоя
- Первый слой состоит из четырех полностью связанных нейронов.
- Второй слой состоит из двух полностью связанных нейронов.
- Функция активации — это ReLU.
- Добавьте регуляризацию L2 со скоростью обучения 0.003.
Нейронная сеть будет оптимизировать веса в течение 180 эпох с размером пакета 10. В приведенной ниже анимации примера нейронной сети вы можете увидеть, как веса изменяются со временем и как сеть улучшает карту классификации.ping.

Прежде всего, сеть присваивает случайные значения всем весам.
- При использовании случайных весов, то есть без оптимизации, выходные потери составляют 0.453. На рисунке ниже сеть представлена разными цветами.
- Как правило, оранжевый цвет представляет отрицательные значения, а синий цвет — положительные значения.
- Данные представлены одинаково: синие точки обозначают положительные значения, а оранжевые — отрицательные.

Внутри второго скрытого слоя линии окрашены в соответствии со знаком весов. Оранжевые линии несут отрицательные веса, а синие — положительные.
Как вы можете видеть на выходной карте.pingВ настоящее время сеть совершает довольно много ошибок. Теперь посмотрите, как сеть ведет себя после оптимизации.
На приведенном ниже примере искусственной нейронной сети показаны результаты оптимизации сети. Прежде всего, видно, что сеть успешно научилась классифицировать точки данных. Сравнивая с предыдущим изображением, можно заметить, что начальный вес составлял -0.43, а после оптимизации он стал равен -0.95.

Эту идею можно обобщить для сетей с большим количеством скрытых слоев и нейронов. Вы можете поэкспериментировать с настройками самостоятельно в [ссылка на программу]. Детская площадка TensorFlow.
Приведённый ниже пошаговый пример реализует ту же идею в коде на реальном наборе данных.
Как обучить нейронную сеть с помощью TensorFlow
Вот пошаговый процесс обучения нейронной сети с помощью TensorFlow Искусственная нейронная сеть (ИНС) с использованием оценщика DNNClassifier из API.
Мы будем использовать набор данных MNIST для обучения вашей первой нейронной сети. Обучение нейронной сети с помощью TensorFlow Это не очень сложно. Этап предварительной обработки выглядит точно так же, как и в предыдущих уроках. Вы будете действовать следующим образом:
- Импортировать данные
- Преобразуйте данные
- Постройте тензор
- Построить модель
- Обучите и оцените модель
- Улучшить модель
Примечание к версии: Код в этом пошаговом руководстве ориентирован на API Estimator из TensorFlow 1.x. Финальная версия пакета tf-estimator поставлялась с TensorFlow 2.15, а tf.estimator был удален в TensorFlow 2.16. Чтобы выполнить эти шаги в текущей версии, либо закрепите TensorFlow 2.15, либо перестройте ту же двухслойную сеть с tf.keras.layers.Dense и model.fit().
Шаг 1) Импортируйте данные
Прежде всего, вам необходимо импортировать необходимую библиотеку. Вы можете импортировать набор данных MNIST, используя... scikit учиться как показано в приведенном ниже примере нейронной сети TensorFlow.
Набор данных MNIST — это наиболее часто используемый набор данных для тестирования новых методов или алгоритмов. Он представляет собой коллекцию изображений размером 28×28 пикселей, каждое из которых отображает рукописную цифру от 0 до 9. Комитет глубоких сверточных нейронных сетей, обученных с использованием эластичных искажений, снизил ошибку тестирования до 0.27 процента.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
В первоначальном пошаговом руководстве файлы MNIST загружались вручную, а функция fetch_mldata указывала на эту папку.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
Примечание к API: Сайт mldata.org больше не работает, а функция fetch_mldata была удалена в scikit-learn 0.22. В текущей установке замените приведенный выше вызов на fetch_openml('mnist_784', version=1), который загружает те же 70 000 цифр и предоставляет идентичные данные и целевые атрибуты.
После этого вы разделяете данные и получаете структуру обоих наборов данных.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
Шаг 2) Преобразуйте данные
В предыдущем уроке вы узнали, что для ограничения влияния выбросов необходимо преобразовать данные. В этом уроке по нейронным сетям вы преобразуете данные с помощью алгоритма минимаксного масштабирования. Формула выглядит следующим образом:
(X-min_x)/(max_x - min_x)
В библиотеке scikit-learn уже есть функция для этого: MinMaxScaler()
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
Шаг 3) Постройте тензор
Теперь вы знакомы со способом создания. тензоры В TensorFlow можно преобразовать обучающий набор данных в числовой столбец.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
Шаг 4) Постройте модель
Архитектура нейронной сети содержит 2 скрытых слоя: первый слой состоит из 300 нейронов, а второй — из 100. Эти значения получены на основе опыта, а не по формуле. Вы можете настроить их и посмотреть, как они повлияют на точность сети.
Для построения модели используется оценщик DNNClassifier. Необходимо установить количество классов равным 10, поскольку в обучающем наборе десять классов. Синтаксис объекта оценщика вам уже знаком. Аргументы feature_columns, n_classes и model_dir точно такие же, как и в предыдущем уроке. Новый аргумент hidden_units управляет как количеством слоев, так и количеством узлов, которые каждый слой соединяет с нейронной сетью. В приведенном ниже коде два скрытых слоя: первый соединяет 300 узлов, а второй — 100.
Чтобы построить оценщик, используйте tf.estimator.DNNClassifier со следующими параметрами:
- feature_columns: Определите столбцы, которые будут использоваться в сети.
- hidden_units: Определите количество скрытых нейронов.
- n_классов: Укажите количество классов для прогнозирования.
- model_dir: Определите путь Тензорборд
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
Шаг 5) Обучите и оцените модель
Для обучения и оценки модели можно использовать функцию ввода NumPy.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
Выход:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
Текущая архитектура обеспечивает точность на оценочном наборе данных примерно в 96 процентов.
Шаг 6) Улучшите модель
Вы можете попытаться улучшить модель, добавив параметры регуляризации.
Здесь в качестве оценщика используется оптимизатор Proximal AdaGrad с коэффициентом отсеивания 0.3 и уровнем значимости L1 и L2, установленным на 0.01. В нейронной сети TensorFlow доступ к оптимизатору осуществляется через объект train, за которым следует имя оптимизатора. TensorFlow предоставляет встроенный API для оптимизатора Proximal AdaGrad.
Для добавления регуляризации к глубокой нейронной сети можно использовать tf.train.ProximalAdagradOptimizer со следующими параметрами:
- Скорость обучения: Learning_rate
- L1-регуляризация: l1_regularization_strength
- L2-регуляризация: l2_regularization_strength
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
Выход:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
Выбранные значения для уменьшения переобучения не улучшили точность модели. Ваша первая модель показала точность 96%, в то время как модель с L2-регуляризатором имеет точность 95%. Вы можете попробовать разные значения и посмотреть, как они повлияют на точность.
