
Преобразование агрегатора в Informatica на примере
 Дэвид Картер
⚡ Умное резюме
В Informatica преобразование Aggregator — это активный объект, который выполняет вычисления, такие как суммирование, вычисление среднего значения и подсчет количества строк в группе, удерживая эти строки в кэше агрегаторов до тех пор, пока каждая группа не будет обработана.
Что такое трансформация агрегатора?
Агрегаторное преобразование — это активное преобразование, выполняющее агрегатные вычисления, такие как сумма, среднее значение и подсчет.
Например, если вы хотите рассчитать сумму зарплат всех сотрудников по отделам, вы можете использовать преобразование «Агрегатор».
Агрегатные операции выполняются над группой строк, поэтому для хранения всех этих записей и выполнения вычислений требуется временный заполнитель.
Для этого используется кэш агрегатора. Это временная основная память, выделяемая преобразованию Aggregator для выполнения таких операций, и она состоит из двух частей: кэш индексов хранит значения групп, а кэш данных — данные строк, подвергающихся агрегированию.
Преобразование является активным, поскольку оно изменяет количество строк в конвейере обработки данных. В него могут поступать несколько тысяч записей о сотрудниках, а из каждого отдела выводится только одна строка.
Как использовать преобразование агрегаторов в Informatica
В этом примере мы рассчитаем сумму заработной платы по отделам. Для этого нам нужен новый столбец для хранения этой суммы. Итак, первым делом подготовим новую колонку.
Шаг 1) Создайте новую целевую таблицу базы данных, например, «sum_sal_deptwise», используя приведенный ниже скрипт. Вы увидите созданную новую целевую таблицу базы данных в папке... Targetпапку s на следующем шаге.
Загрузите указанный выше файл Create_table_sal_deptwise.txt.
Шаг 2) Создать новый картаping “m_sum_sal_deptwise”.
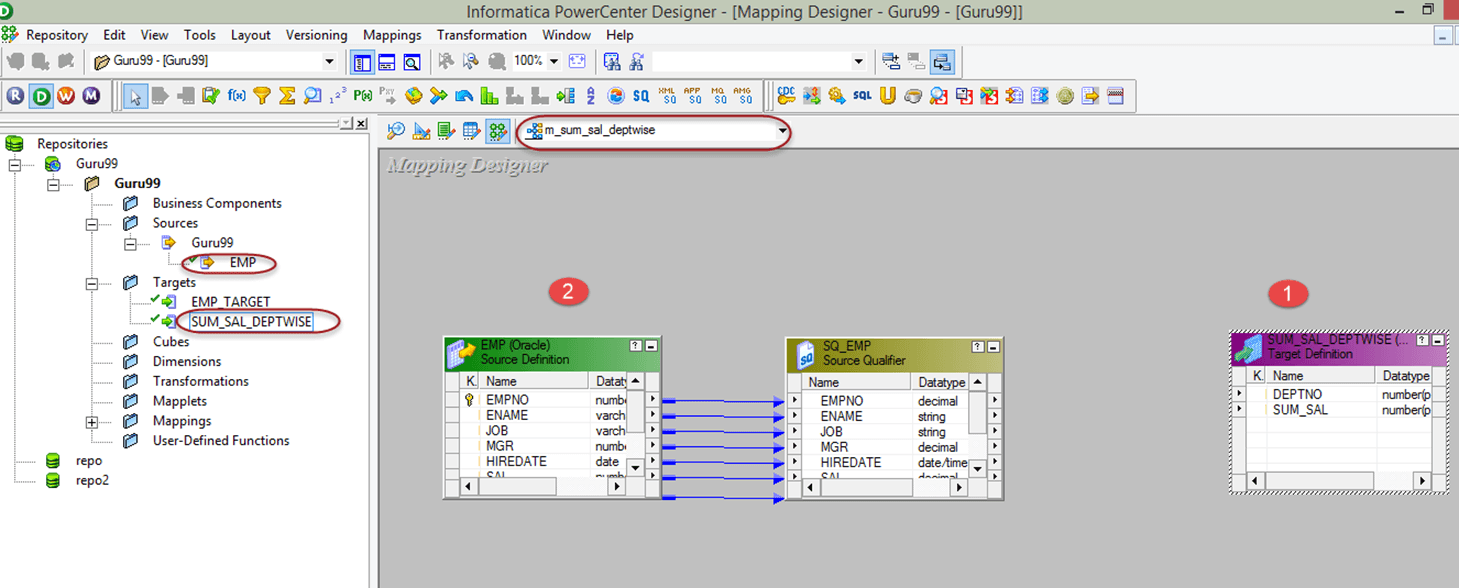
Для создания новой картыpingДля работы нам необходимы исходная таблица (EMP) и целевая таблица (sum_sal_deptwise) в Map.ping Дизайнер, поэтому нам нужно
- Импортируйте целевую таблицу «sum_sal_deptwise» в карту.ping.
- Импортируйте исходную таблицу «emp».
Оба определения теперь отображаются на холсте, как показано ниже.
Шаг 3) На картеping,
- Из издания Классификатор источникаУдалите столбцы empno, ename, job, mgr, hiredate и comm, оставив только столбцы deptno и sal.
- Создайте новое преобразование-агрегатор, используя меню панели инструментов, как показано на скриншоте. При нажатии на значок агрегатора будет создано новое преобразование-агрегатор.
Новый объект AGGTRANS появляется рядом с укороченным Source Qualifier.

Шаг 4) Перетащите столбцы SAL и DEPTNO из поля Source Qualifier (SQ_EMP) в преобразование Aggregator. Теперь эти два порта связаны в AGGTRANS.

Шаг 5) Double— Щелкните по преобразованию «Агрегатор», чтобы открыть его свойства, а затем
- Добавьте новый порт в преобразование
- Переименуйте порт в SUM_SAL
- Измените тип данных этого нового порта на двойной.
- Сделайте этот порт выходным, установив флажок напротив соответствующего выходного порта.
- Выберите опцию выражения.
На вкладке «Порты» теперь отображаются SAL, DEPTNO и новый выходной порт SUM_SAL.

Шаг 6) В окне редактора выражений
- Добавьте выражение sum(SAL); вам нужно написать это выражение самостоятельно.
- Нажмите кнопку ОК, это вернет окно «Редактирование преобразований».
Редактор выражений отображает агрегатное выражение, присвоенное переменной SUM_SAL.

Шаг 7) В окне «Редактирование преобразований» выберите параметр «Группировка по», установив флажок напротив столбца «deptno», и нажмите «ОК». Выбрав группировку по столбцу «deptno», мы указываем Informatica сгруппировать заработную плату по столбцу «deptno».

Шаг 8) Свяжите столбцы deptno и sum_sal из преобразования Aggregator с целевой таблицей. Картаping Затем процесс завершается от источника до цели.

Теперь сохраните карту.ping и выполнить его после создания нового Сессия для этой картыpingЦелевая таблица будет содержать сумму зарплат по отделам. Таким образом, мы можем использовать преобразование «Агрегатор» для расчета агрегированных результатов.
Группировка по портам в рамках преобразования агрегатора
На предыдущем этапе отдельный порт был отмечен как «Группировать по», что позволило преобразовать общекорпоративную сумму в одну общую сумму по каждому отделу. Любой входной, входной/выходной, выходной или переменный порт можно отметить аналогичным образом.
Для формирования результирующего набора данных действуют три правила:
- Одна строка на группу. При группировке значений служба интеграции создает отдельную строку для каждой уникальной комбинации портов, выбранных в качестве параметров группировки.
- Группировка не производится, только в один ряд. Если порт не указан, весь ввод рассматривается как единая группа, и для всех входных строк возвращается одна строка.
- Побеждает последний ряд. Наряду с итоговым результатом, служба интеграции обычно передает последнюю полученную строку в группе, если только функция, например, FIRST, не указывает другую строку.
Если указано несколько портов, порядок портов определяет группу.ping порядок, и порядок может изменить результат. Группаping DEPTNO, а затем JOB — это не то же самое, что группа.ping Сначала по JOB, а затем по DEPTNO, поскольку значения во втором столбце не обязательно уникальны.
Свойства преобразования агрегатора
Вкладка «Свойства» окна «Редактирование преобразований» содержит настройки, определяющие местоположение кэша и объем его использования. Ниже приведен их список.
| настройка | Что он контролирует |
|---|---|
| Каталог кэша | Локальный каталог, в котором служба интеграции создает файлы индекса и кэша данных. По умолчанию используется переменная процесса $PMCacheDir, заданная в диспетчере рабочих процессов. |
| TracУровень | Объем подробной информации, записанной в журнал сессии для этой трансформации. |
| Отсортированный ввод | Указывает, что входящие данные уже отсортированы по группам портов. Выбирайте этот параметр только при отображении карты.ping Действительно предоставляет отсортированные данные. |
| Размер кэша данных агрегатора | Размер кэша данных. По умолчанию он составляет 2 000 000 байт, а в режиме Auto размер кэша определяется службой интеграции. |
| Размер кэша агрегаторного индекса | Размер кэша индексов. По умолчанию — 1 000 000 байт, а в режиме Auto размер кэша определяется службой интеграции. |
| Объем преобразований | Применяет логику к каждой транзакции или ко всем входящим данным. Параметр "Все входящие данные" отменяет ограничения на входящие транзакции. |
При включении инкрементальной агрегации служба интеграции при каждом запуске создает резервную копию файлов кэша, поэтому в каталоге кэша приходится хранить два набора файлов вместо одного.
Правила использования агрегатных выражений и рекомендации по повышению производительности.
Агрегатное выражение может объединять агрегатную функцию с условными предложениями и неагрегатными функциями, что позволяет выполнять условные суммы и подсчеты в одном порту. Два правила ограничивают то, что можно записать.
- Один уровень вложенности. Вложенной друг в друга может быть только одна агрегатная функция, при этом сначала вычисляется внутреннее выражение.
- Без смешивания. Преобразование может содержать одноуровневые функции или вложенные функции, но никогда и то, и другое одновременно. Если оно содержит и то, и другое, конструктор отмечает соответствующую карту.ping Неверно, поэтому разделите логику на два преобразования агрегатора.
Что касается настройки, то основную работу выполняют три параметра:
- Отсортированные входные данные. Когда строки поступают отсортированными по группам портов, каждая группа может быть освобождена сразу после поступления последней строки, поэтому кэшируется гораздо меньше данных, и сессия выполняется быстрее. Отсортированные входные данные нельзя комбинировать с инкрементальной агрегацией.
- Поэтапная агрегация. Новые строки источника передаются через карту.ping и в сочетании с историческим кэшем вместо пересчета истории, что подходит для ежедневной загрузки в накопительную базу данных.
- Фильтрация на ранней стадии. Строки, которые никогда не будут учитываться в итоговой сумме, следует удалять перед агрегатором, либо в запросе Source Qualifier, либо в другом месте. Фильтрация преобразованияПоскольку каждая строка, поступающая в агрегатор, расходует кэш-память. Это одна из стандартных проверок во время обработки запросов. настройка производительности.
