
10 Cele mai bune programe GRATUITE de scraping webping Unelte (2026)
 Echipa editorială
Dezvaluirea: Guru99 este susținut de cititori. Este posibil să câștigăm un comision atunci când cumpărați prin linkurile de pe această pagină. Află mai multe
Scrapare webping Instrumentele pot economisi ore întregi, însă alegerea greșită returnează adesea înregistrări incomplete, declanșează blocuri IP, irosește credite, ascunde limite importante și îi lasă pe începători în tablouri de bord confuze. Selectorii instabili sau randarea inconsistentă pot, de asemenea, să întrerupă rapoartele fără avertisment. Cititorii compară adesea alocațiile pentru titluri, în timp ce trec cu vederea costurile solicitărilor. JavaSuport pentru scripturi, păstrarea datelor și controale de conformitate. O analiză mai clară face ca aceste compromisuri să fie vizibile, ajută la potrivirea fiecărui flux de lucru cu serviciul potrivit și transformă o listă scurtă incertă într-un pas următor ușor de gestionat.
Am petrecut peste 55 de ore cercetând peste 18 instrumente, verificând paginile oficiale ale produselor, limitele de acces, fluxurile de lucru și modelele recurente de recenzii. Cercetarea mea aprofundată a selectat 10 dintre cele mai bune platforme gratuite de scraping web.ping Opțiuni de instrumente cu funcții, avantaje și dezavantaje, precum și detalii despre planul actual. Ghidul separă planurile gratuite permanente de creditele de probă și testele plătite, astfel încât să puteți continua cu așteptări mai clare. Citeste mai mult…
Oxylabs este o platformă de colectare a informațiilor web lider pe piață. Este condus de cele mai înalte standarde de afaceri, etică și conformitate, permițând companiilor din întreaga lume să deblocheze informații bazate pe date. Oferă un mecanism de reîncercare automată care ajută la gestionarea și eluda blocările IP.
Cel mai bun scraping web GRATUITping Software și instrumente
| Nume | Cele mai bune | Caracteristici cheie | Ușor de utilizare | Încercare gratuită | Link |
|---|---|---|---|---|---|
???? Oxylabs |
Examen de date la scară largătracTION | Rată mare de succes, direcționare geografică, date structurate | Moderat | Nelimitat | Află mai multe |
 👍 Decodo |
Scanare avansată de dateping Soluții | Rotație IP, Rată mare de succes, Management proxy | Uşor | Încercare gratuită de 7 de zile | Află mai multe |
 👍 NodeMaven |
Scraping proxy premium rezidențial și mobilping | Filtru de calitate IP, sesiuni fixe de 7 zile, peste 190 de țări | Uşor | 750 MB pentru 3.50 USD | Află mai multe |
 Webshare |
Rețea proxy accesibilă pentru scraping | Peste 80 de milioane de IP-uri, Geo-targeting, Rotație IP | Uşor | 10 proxy gratuite | Află mai multe |
 Apify |
Dezvoltatori și pasionați de automatizări | Date avansate extracapeluri API | Moderat | Plan de bază gratuit pe viață | Află mai multe |
1) Oxylabs
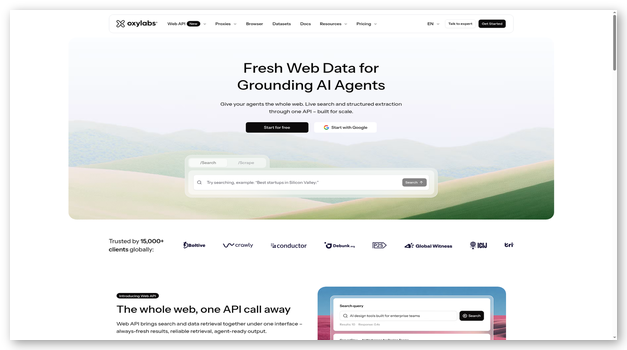
Oxylabs oferă un Web gestionat Scraper API pentru echipele care colectează date publice de pe site-uri web dificile. Acesta gestionează rutarea proxy, randarea browserului, reîncercările și livrarea structurată în spatele unui singur API. Echipele de monitorizare a comerțului cu amănuntul pot solicita pagini de produse localizate fără a menține flote separate de browsere.
Tabloul său de bord se concentrează pe utilizare, solicitări și controale ale parserului. Interogările în lot și programarea acceptă joburi recurente, în timp ce OxyCopilot ajută la generarea solicitărilor. Serviciul se potrivește mai bine sarcinilor de lucru de producție decât proiectelor ocazionale, mai ales atunci când livrarea previzibilă contează mai mult decât deținerea scra-ului.ping infrastructură la scară largă.
Caracteristici:
- Cereri gestionate: API-ul direcționează cererile printr-o infrastructură adecvată și repetă încercările blocate. Echipele primesc răspunsuri utilizabile fără a menține liste mari de proxy sau browser workers.
- Browser fără cap: Încărcări de randare a browserului JavaPagini cu multe scripturi înainte de extracțiune. Aceasta acceptă listări dinamice de produse, pagini interactive de călătorie și alt conținut care lipsește din HTML-ul brut.
- Analizator personalizat: Regulile de analiză personalizată convertesc paginile acceptate în câmpuri structurate. Analiștii petrec mai puțin timp curățând markup-ul înainte de a încărca rezultatele în baze de date sau rapoarte.
- Interogări în lot: Grupurile de trimitere în lot țintă multe URLîntr-un singur flux de lucru. Reduce munca de orchestrare atunci când echipele monitorizează prețurile, inventarul, rezultatele căutării sau anunțurile.
- Scheduler: Joburile programate rulează colecții recurente la intervale definite. Acest lucru ajută echipele să actualizeze seturile de date fără a se baza pe un serviciu cron separat pentru fiecare proiect.
- Direcționare geografică: Parametrii de locație solicită pagini din anumite piețe. Cercetătorii pot compara prețurile regionale, disponibilitatea sau rezultatele căutării prin intermediul aceleiași integrări API.
- Controale de utilizare: Tabloul de bord arată consumul de rezultate și activitatea solicitărilor. Echipele pot tracVolumul k înainte ca limitele să devină o surpriză în timpul unei ciclări de colectare a producției.
Pro
Contra
???? Cum să obții Oxylabs gratis?
- Deschideți Oxylabs web Scraper Pagina de prețuri API.
- Creează un cont și selectează perioada de probă gratuită fără a adăuga un card.
- Studiul include până la 2,000 de rezultate pentru scra acceptate.ping fluxuri de lucru.
Perioadă de încercare gratuită cu până la 2,000 de rezultate
2) Decodo
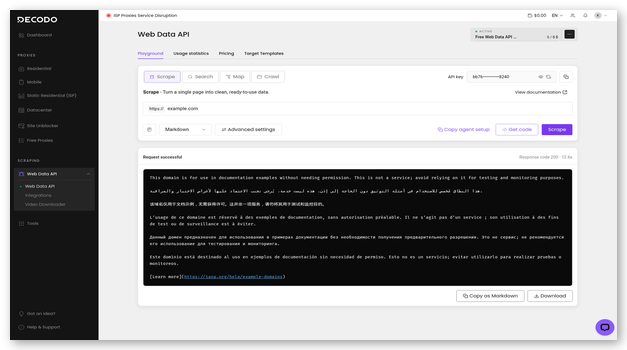
Decodo combină infrastructura proxy cu un Web Scraping API creată pentru dezvoltatori, analiști și fluxuri de lucru bazate pe inteligență artificială. Punctele sale finale de extragere, căutare, mapare și crawling acoperă pagini individuale prin descoperirea pe mai multe pagini. Șabloanele pregătite returnează date structurate pentru ținte comune fără a necesita un parser personalizat.
Tabloul de bord expune cheile API, setările de solicitare, utilizarea și opțiunile de ieșire. JavaRedarea scripturilor și selecția proxy gestionată gestionează paginile mai complexe, în timp ce ieșirea Markdown acceptă canale de procesare a modelelor de limbaj. Un plan gratuit permanent face ca Decodo să fie practic pentru prototipuri înainte ca echipele să se angajeze în mod fiabil la volume mai mari de solicitări.
Caracteristici:
- Patru puncte finale: Punctele finale de razuire, căutare, mapare și crawling acoperă exemplele concentratetracțiune și descoperirea site-urilor. Dezvoltatorii pot păstra mai multe sarcini de date în spatele unei singure chei API.
- Șabloane pregătite: Peste 100 de șabloane întreținute vizează site-uri web și tipuri de date comune. Acestea reduc munca de selecție și accelerează proiectele inițiale de verificare a conceptului.
- JavaRedare script: Randarea opțională încarcă conținut dinamic înainte de livrare. Echipele pot colecta date din paginile randate de client fără a opera propriul cluster de browsere headless.
- Ieșire flexibilă: Răspunsurile pot include date HTML, Markdown, JSON, CSV, PNG sau XHR, acolo unde sunt acceptate. Fiecare flux de lucru poate alege un format pregătit pentru analiză.
- Gestionarea proxy-urilor: Selecția proxy încorporată și controalele anti-boți reduc munca de rotație manuală. Solicitările pot ajunge la pagini geosensibile, în timp ce API-ul gestionează deciziile privind infrastructura.
- Conexiuni AI: MCP și alte căi de integrare aduc datele web actuale în instrumentele de inteligență artificială acceptate. Acest lucru este potrivit pentru agenții de cercetare și fluxurile de lucru pentru regăsirea datelor care necesită surse live.
- Controalele solicitării: Limitele de rată și totalurile de utilizare apar cu fiecare plan. Echipele pot dimensiona un proiect în funcție de volumul de accesare cu crawlere, în loc să se bazeze doar pe lățimea de bandă.
Pro
Contra
???? Cum să obțineți Decodo gratuit?
- Vizitați Decodo's Web Scraping Pagina de prețuri API.
- Creați contul gratuit și copiați acreditările API generate.
- Planul gratuit acoperă 5,000 de accesări prin crawling sau 10,000 de pagini accesate prin scraping lunar.
Plan gratuit cu până la 10,000 de pagini
3) NodeMaven
NodeMaven este o platformă proxy pentru scraping echipe care deja dețin foștitraccod de tion sau automatizare a browserului. Opțiunile rezidențiale, mobile și ISP acceptă conexiuni HTTP și SOCKS5 pe o acoperire geografică largă. Filtrul său de calitate IP filtrează adresele înainte de atribuire pentru a reduce erorile evitabile.
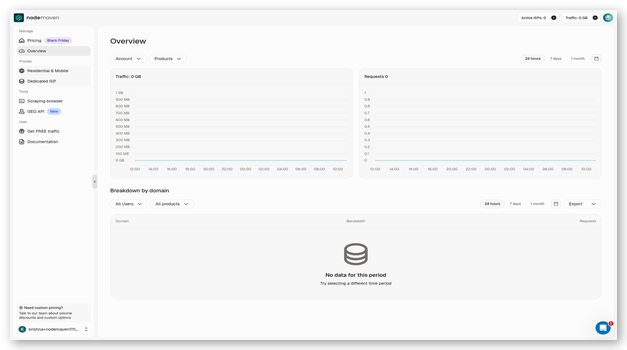
Tabloul de bord se concentrează pe trafic, acreditări, direcționare și setări de rotație, mai degrabă decât pe seturi de date analizate. Sesiunile fixe se potrivesc continuității contului sau locației, în timp ce rotația per solicitare se potrivește cu crawl-uri largi. NodeMaven funcționează cel mai bine atunci când calitatea proxy-ului și controlul sesiunii contează mai mult decât o crawl predefinită.ping API-ul.
Caracteristici:
- Filtru de calitate: Filtrul de calitate IP filtrează adresele disponibile înainte de atribuire. Grupurile mai curate pot reduce încercările inutile și CA-urile.PTCÎntreruperi HA în timpul ciclurilor lungi de colectare.
- Tipuri de proxy: Proxy-urile rezidențiale, mobile și ISP se află sub un singur cont. Echipele pot potrivi reputația, stabilitatea și costul pentru fiecare scra.ping țintă.
- Comenzi de rotație: Conexiunile pot fi alternate între cereri sau pot rămâne fixe pentru sesiuni extinse. Acest lucru acceptă atât accesări cu crawlere mari, cât și fluxuri de lucru care necesită o identitate consistentă.
- Direcționare geografică: Controalele privind țările, orașele și furnizorii de servicii de internet restrâng locația de ieșire. Cercetătorii pot colecta prețuri localizate, reclame, rezultate ale căutării sau date despre disponibilitate.
- Suport protocol: Suportul HTTP și SOCKS5 funcționează cu scripturi și instrumente de automatizare comune. Crawlerele existente se pot conecta fără a-și schimba ex-urile.traclogica ției.
- Răsturnare în trafic: Traficul neutilizat poate fi transferat în următoarea perioadă de facturare conform planurilor actuale. Acest lucru ajută proiectele cu programe lunare de colectare neuniforme să păstreze capacitatea achiziționată.
- Tablou de bord pentru utilizare: Detaliile despre trafic și conexiune apar în tabloul de bord al contului. Echipele pot monitoriza consumul și ajusta rotația înainte ca o scanare să își epuizeze alocația.
Pro
Contra
???? Cum să obții NodeMaven gratuit?
- Deschide pagina de prețuri NodeMaven și creează un cont.
- Selectați versiunea de încercare pentru acces proxy rezidențial și mobil.
- Versiunea de probă plătită costă 3.50 USD și include 750 MB de lățime de bandă.
Perioadă de încercare de 750 MB pentru 3.50 USD
4) Webshare
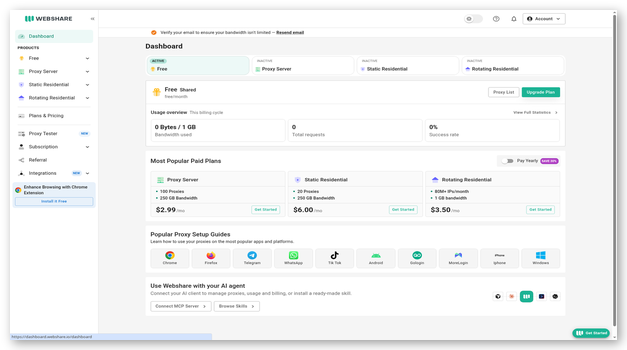
Webshare oferă conexiuni proxy pentru centre de date, rezidențiale și ISP-uri pentru scripturi, crawlere și automatizare browser. Planul său gratuit permanent oferă proiectelor mici zece proxy-uri pentru centre de date și o alocație lunară de lățime de bandă. Utilizatorii se pot autentifica prin acreditări sau adrese IP aprobate.
Tabloul de bord prezintă liste de proxy-uri, detalii despre conexiune, utilizare și acces API într-un singur loc. Controalele de rotație ajută la distribuirea cererilor, în timp ce filtrele de locație acceptă colectarea regională. Webshare se potrivește cursanților și locurilor de muncă ușoare care necesită acces proxy fiabil, deși nu înlocuiește un parser sau o scanare completăping flux de lucru.
Caracteristici:
- Proxy-uri gratuite: Planul gratuit permanent include zece proxy-uri pentru centre de date și 1 GB de trafic lunar. Experimentele mici pot continua fără expirarea unei perioade de probă.
- Opțiuni proxy: Opțiunile plătite acoperă conexiunile la centre de date, rezidențiale și ISP. Echipele pot selecta un pool în funcție de dificultatea, stabilitatea și bugetul țintă.
- Rotație: Rotația punctelor de terminare schimbă automat adresele pentru planurile acceptate. Acest lucru reduce întreținerea manuală a listei de proxy-uri pentru seturi de solicitări mai mari sau repetate frecvent.
- Controale geografice: Filtrele de locație ajută la direcționarea solicitărilor prin țări sau regiuni relevante. Cercetătorii de piață pot compara conținutul localizat folosind același flux de lucru pentru conectare.
- Acces API: API-ul expune detaliile proxy-ului și operațiunile contului pentru automatizare. Dezvoltatorii pot furniza sau recupera conexiuni fără a copia liste din tabloul de bord.
- Autentificare: Acreditările de utilizator și autorizarea IP acceptă diferite modele de implementare. Echipele pot securiza accesul pentru servere, laptopuri sau scraping distribuit.ping lucrători.
- Folosire tracrege: Indicatorii din tabloul de bord arată lățimea de bandă și activitatea proxy. Utilizatorii pot identifica limitele care se apropie înainte ca un crawler să se oprească în timpul unei colectări importante.
Pro
Contra
???? Cum să obții Webshare gratis?
- Operatii Deschise Webshare și înregistrează un cont gratuit fără card.
- Accesați lista de proxy-uri pentru a recupera detaliile conexiunii atribuite.
- Abonamentul gratuit include zece proxy-uri pentru centre de date și 1 GB lunar.
10 proxy-uri gratuite și 1 GB lunar
5) Apify
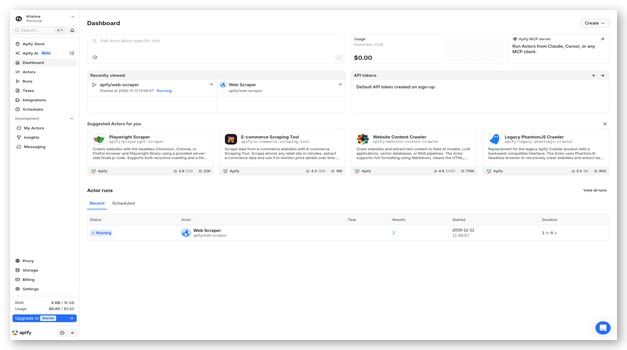
Apify este o platformă cloud pentru rularea de scrapere reutilizabile numite Actors. Magazinul său public acoperă site-uri web comune, în timp ce dezvoltatorii pot construi Actors personalizați cu Crawlee sau alte instrumente compatibile. Programările, seturile de date, cozile și webhook-urile transformă rulările individuale în fluxuri de lucru de date repetabile.
Consola afișează intrări, jurnale de rulare, spațiu de stocare, costuri și ieșiri pentru fiecare Actor. Echipele pot exporta înregistrări sau le pot conecta prin API. Apify oferă o flexibilitate largă, deși calitatea pieței și costurile de utilizare variază. Se potrivește utilizatorilor care doresc atât scrapere pregătite, cât și o platformă de automatizare programabilă.
Caracteristici:
- Magazinul Actorilor: Magazinul oferă scrapere predefinite pentru multe site-uri web și sarcini comune. Utilizatorii pot începe cu un Actor existent în loc să programeze fiecare colector.
- Actori personalizați: Dezvoltatorii își pot împacheta propriile fișiere Scraping logica ca actori reutilizabili. Intrările și construcțiile versionate facilitează rularea repetată a aceluiași flux de lucru.
- Programare: Programările încorporate lansează Actorii la momente sau intervale selectate. Monitorizarea recurentă a prețurilor, listărilor sau conținutului poate rula fără un planificator extern.
- Stocare a datelor: Seturile de date, depozitele cheie-valoare și cozile de solicitări organizează ieșirile și starea de accesare cu crawlere. Fiecare rulare își păstrează înregistrările accesibile pentru export sau procesare ulterioară.
- integrările: API-urile, webhook-urile și conectorii trimit rezultate către alte sisteme. Echipele pot declanșa sarcini ulterioare după ce o rulare are succes sau eșuează.
- Opțiuni proxy: Serviciile proxy pentru centre de date și rezidențiale sunt disponibile în cadrul platformei. Actorii pot roti conexiunile fără un furnizor de proxy gestionat separat.
- Monitorizarea rulării: Jurnalele, starea, utilizarea calculului și costurile apar pentru fiecare rulare. Dezvoltatorii pot diagnostica erorile și pot estima resursele consumate de o lucrare recurentă.
Pro
Contra
???? Cum să obții Apify gratis?
- Vizita Apifypagina de prețuri a și selectați planul Gratuit.
- Creați un cont fără a introduce informațiile cardului de plată.
- Planul se reînnoiește cu un credit lunar de 5 USD și cinci rulări simultane.
Credit gratuit lunar de 5 USD
6) Novada
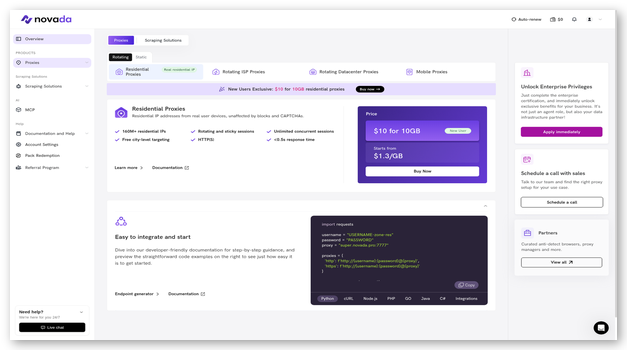
Novada grupuri a Scraper API, Web Unblocker și Browser API sub un singur sold creditor. Scraper API-ul returnează înregistrări structurate pentru țintele acceptate, în timp ce API-ul browserului gestionează interacțiunea JavaCreați scripturi pentru pagini prin protocoale de automatizare familiare. Controalele anti-boți gestionate reduc munca depusă în infrastructură.
Tabloul de bord tracConsumul de produse ks, domenii, credite și solicitări simultane. Facturarea unificată permite echipelor să schimbe metodele fără abonamente separate. Novada este util pentru ex mixtetracnevoile de țiune, dar accesul la versiunea de probă necesită partajarea campaniei și aprobarea asistenței. Creditele achiziționate expiră și după perioada de valabilitate indicată.
Caracteristici:
- Scraper API-uri: Scraper API-ul returnează date curățate pentru țintele acceptate de căutare, comerț și social media. Echipele pot sări peste o mare parte din etapa de analiză HTML.
- Deblocare web: Web Unblocker returnează pagini brute, gestionând în același timp barierele comune de acces. Este potrivit pentru echipele care doresc să își păstreze propria logică de analiză.
- API-ul browserului: Browserele cloud acceptă conexiuni în stilul Puppeteer și Playwright. Dezvoltatorii pot reda pagini, pot da clic pe elemente, pot derula și captura conținut interactiv complex.
- Credite unificate: Un sold acoperă scraping, deblocare și produse de browser. Echipele pot schimba metodele fără a achiziționa o alocație separată pentru fiecare serviciu.
- Facturare reușită: Novada percepe credite atunci când solicitările returnează date conform regulilor sale publicate. Solicitările eșuate pe platformă nu consumă același sold.
- Ieșire structurată: Șabloanele acceptate oferă înregistrări JSON sau CSV în loc de markup brut. Analiștii pot încărca rezultatele în rapoarte cu mai puțină curățare.
- Controale de concurență: Nivelurile de plan definesc capacitatea de solicitare paralelă pentru fiecare produs. Echipele pot alege o alocație care se potrivește cu volumul crawlerelor și cu timpii de răspuns așteptați.
Pro
Contra
???? Cum să obții NovaDa gratuit?
- Crearea unei Novacontul da și deschideți pagina campaniei de probă gratuită.
- Distribuiți campania cu trei grupuri, apoi trimiteți capturi de ecran către echipele de sprijin.
- După aprobare, Novada adaugă un credit de 15 USD pentru proxy-uri și scrapingping unelte.
Credit de probă de 15 USD
7) Bright Data
Bright Data oferă Web predefinit Scraper API-uri, un Scraping browsere, Scraper Studio, proxy-uri și seturi de date. Echipele pot alege înregistrări structurate sau pot controla un browser la distanță cu Playwright și Puppeteer. Gestionarea accesului încorporată gestionează rotația, amprentele browserului și provocările de acces.
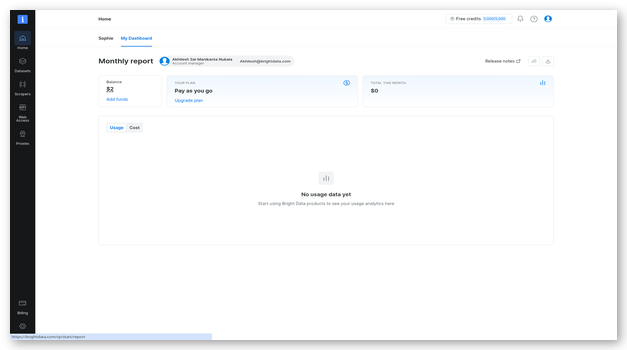
Panoul de control separă produsele, acreditările, utilizarea, colectorii și setările de livrare. API-urile predefinite reduc întreținerea pentru țintele acceptate, în timp ce accesul browserului gestionează interacțiunile personalizate. Bright Data Se potrivește proiectelor solicitante cu o acoperire largă și nevoi de asistență. Catalogul său vast de produse și opțiunile pentru întreprinderi pot părea excesive pentru o simplă muncă personală.ping.
Caracteristici:
- Scraper API-uri: API-urile predefinite returnează înregistrări structurate pentru site-urile web și categoriile acceptate. Echipele evită să întrețină selectorii și logica browserului pentru fiecare modificare a țintei.
- Cicatriceping Browser: Un browser găzduit se conectează prin Playwright sau Puppeteer. Dezvoltatorii pot executa JavaScriptează și automatizează interacțiunile în timp ce Bright Data gestionează infrastructura de acces.
- Scraper Studio: Instrumentele Studio ajută la construirea și implementarea colectoarelor personalizate. Opțiunile vizuale și asistate de inteligență artificială reduc timpul de configurare pentru țintele fără o API pregătită.
- Rețea proxy: Serviciile proxy integrate acoperă mai multe tipuri de conexiuni și locații. Fluxurile de lucru pot direcționa traficul fără a muta acreditările între mai mulți furnizori separați.
- Optiuni de livrare: Datele colectate pot fi transferate prin API-uri, webhook-uri sau destinații cloud acceptate. Echipele pot alimenta depozitele și canalele de analiză existente după fiecare rulare.
- Controlul cheltuielilor: Opțiunile de plată pe măsură ce utilizezi și limitele lunare ajută la gestionarea consumului. Vizualizările de utilizare din tabloul de bord arată cum afectează un colector bugetul proiectului.
- Înregistrări gratuite: Internetul Scraper Nivelul gratuit API include 5,000 de înregistrări în fiecare lună. Nu este necesar niciun card de plată pentru a începe acel nivel publicat.
Pro
Contra
???? Cum să obții Bright Data gratis?
- Operatii Deschise Bright DataWeb-ul lui Scraper Pagina de prețuri API.
- Selectați Începeți gratuit și înregistrați-vă fără a introduce un card de plată.
- Nivelul gratuit include 5,000 de abonamente web Scraper Înregistrări API în fiecare lună.
5,000 de înregistrări gratuite lunar
8) PrivateProxy
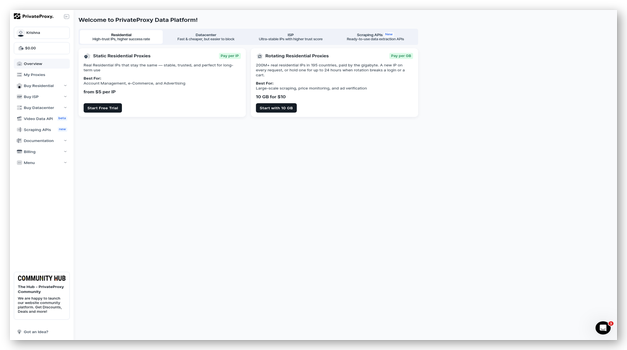
PrivateProxy oferă pachete proxy statice și rotative pentru scripturi și automatizare a browserului. Perioadele de probă rezidențiale și pentru centre de date statice permit utilizatorilor să testeze o adresă înainte de a se angaja, în timp ce planurile rotative plătite acoperă traficul bazat pe solicitări sau pe lățime de bandă. Conexiunile acceptă modele comune de autentificare.
Zona contului se concentrează pe pachete, locații, acreditări, utilizare și starea abonamentului. Opțiunile statice dedicate se potrivesc sarcinilor care necesită o adresă consistentă, în timp ce serviciile rotative se potrivesc accesărilor cu accesări mai ample. PrivateProxy este o componentă de infrastructură mai degrabă decât un scraper complet, așa că echipele trebuie să furnizeze extraclogica de cțiune, reîncercări, stocare și validare a datelor.
Caracteristici:
- Proxy-uri statice: Opțiunile statice pentru centre de date și ISP păstrează o singură adresă pe durata abonamentului. Acestea sunt potrivite pentru sesiunile care necesită continuitate sau acces pe lista de acces permis.
- Acces rotativ: Pachetele rotative schimbă adresele între cereri sau sesiuni. Acest lucru poate distribui traficul de crawler fără a menține o listă de proxy locale separată.
- Opțiuni de probă: Anumite pachete statice includ o perioadă de probă gratuită de două zile cu verificarea cardului. Pachetele de testare rotative percep în schimb un preț introductiv pentru primul ciclu.
- Autentificare: Acreditările de nume de utilizator și autorizarea bazată pe IP acceptă implementări comune de server. Echipele pot alege metoda care se potrivește cel mai bine mediului lor de crawler.
- Alegerea locației: Pachetele disponibile oferă opțiuni regionale în timpul comenzii. Utilizatorii pot potrivi o locație proxy cu piața sau site-ul web studiat.
- Controale privind abonamentele: Tabloul de bord afișează pachetele active și starea reînnoirii. Utilizatorii abonamentului în versiune de probă pot anula înainte de reînnoire pentru a evita taxa lunară afișată.
- Suport protocol: Conexiunile HTTP, HTTPS și SOCKS acoperă multe probleme.ping biblioteci și browsere. Instrumentele existente se pot conecta fără un exemplu specific furnizoruluitracSDK-ul tion.
Pro
Contra
???? Cum să obții PrivateProxy gratis?
- Operatii Deschise PrivateProxypagina de ajutor a și alegeți o versiune de probă statică eligibilă.
- Selectați detaliile locației și adăugați un card pentru verificare.
- Perioada de probă gratuită durează două zile și se reînnoiește dacă nu este anulată prompt.
2-zi de încercare gratuită
9) ScraperAPI
ScraperAPI oferă dezvoltatorilor un singur punct final pentru preluarea paginilor prin pool-urile de proxy gestionate. Se ocupă de rotația adreselor, reîncercările automate, CAPTCAnunțuri disponibile, geotargeting și opțiuni opționale JavaRedare script. Punctele finale structurate acoperă anumite ținte comerciale și de căutare, în timp ce API-ul asincron acceptă loturi de cereri mai mari.
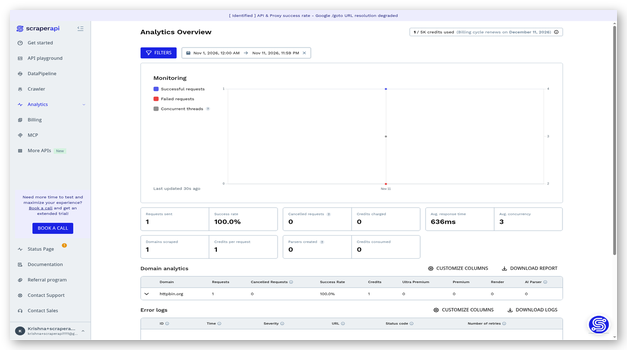
Tabloul de bord afișează acreditările API, utilizarea creditului, concurența și analiza solicitărilor. DataPipeline adaugă programarea și livrarea fără un serviciu de crawler separat. ScraperAPI se potrivește echipelor care știu deja ce pagini să solicite, dar doresc să evite operațiunile proxy. Costurile creditelor variază în funcție de țintă și de funcțiile activate.
Caracteristici:
- Punct final unic: O cerere API standard trimite ținta URL și cheia de autentificare. ScraperAPI gestionează selecția proxy-ului și returnează răspunsul paginii rezultată.
- Reîncercări automate: Încercările eșuate sau blocate pot fi reluate prin conexiuni diferite. Acest lucru reduce logica personalizată de reîncercare din cadrul scra-ului apelantului.ping aplicație.
- JavaRedare script: Randarea opțională încarcă conținutul din partea clientului înainte de a returna un răspuns. Paginile dinamice ale produselor și interfețele aplicației devin accesibile prin intermediul aceluiași API.
- Date structurate: Punctele de terminare dedicate returnează înregistrări analizate pentru țintele acceptate. Echipele pot evita menținerea selectorilor pentru paginile comune de produse, căutări și listări.
- Conductă de date: DataPipeline programează colecțiile și livrează fișierele finalizate către destinațiile acceptate. Analiștii pot opera joburi recurente fără a construi un strat de orchestrare complet.
- Estimator de costuri: Instrumentele tabloului de bord estimează consumul de credit pentru un URL și setul de parametri. Acest lucru ajută echipele să compare costurile de randare, proxy premium și ocolire.
- Alocație gratuită: Planul gratuit publicat include 1,000 de credite API și cinci conexiuni simultane. Utilizatorii pot testa solicitările standard înainte de a alege un plan plătit.
Pro
Contra
???? Cum să obții ScraperAPI gratis?
- Vizita ScraperAPIpagina de prețuri a și creați un cont gratuit.
- Copiați cheia API și testați o cerere standard.
- Abonamentul gratuit include 1,000 de credite și cinci conexiuni simultane lunar.
1,000 de credite gratuite lunar
10) ScrapingBee
ScrapingBee este o API pentru colectarea paginilor care necesită browsere, proxy-uri sau controale de locație. JavaRedarea scripturilor încarcă conținut interactiv, în timp ce conexiunile clasice, premium și stealth abordează diferite niveluri de dificultate. API-urile pentru capturi de ecran și căutare extind același cont dincolo de regăsirea HTML.
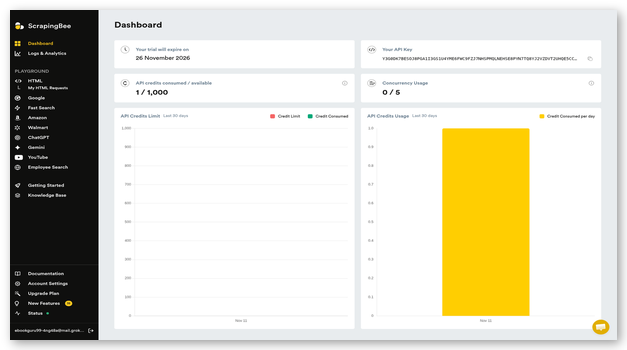
Tabloul de bord oferă o cheie API, un constructor de cereri, o estimare a creditului și un istoric de utilizare. Dezvoltatorii pot adăuga anteturi personalizate sau JavaScenarii de script pentru clicuri și derulare. Exemple de inteligență artificialătraction acceptă instrucțiuni de câmp în limbaj simplu. ScrapingBee este accesibil pentru utilizatorii API, deși opțiunile activate pot modifica brusc costul creditului.
Caracteristici:
- API-ul HTML: API-ul HTML returnează conținutul paginii randat sau nerandat printr-un singur punct final. Dezvoltatorii controlează nivelul proxy, locația, anteturile și comportamentul browserului.
- Scenarii JS: pachet personalizat JavaScenariile de script pot activa clicuri, derula, aștepta sau interacționa înainte de capturare. Acest lucru este compatibil cu paginile în care conținutul apare numai după acțiunile utilizatorului.
- Niveluri proxy: Rutele clasice, premium și stealth abordează diferite niveluri de blocare. Echipele pot începe cu acces cu costuri mai mici și pot escalada doar atunci când este nevoie.
- AI fosttracTION: Interogări și exemple în limbaj simplutracRegulile de selecție identifică câmpurile solicitate. Acest lucru reduce munca de selecție atunci când echipele au nevoie de un rezultat structurat rapid din schimbarea paginilor.
- Captură de ecran API: Cererile de captură de ecran permit realizarea unor pagini întregi sau a unor elemente selectate. Echipele de monitorizare pot stoca dovezi vizuale alături de exemple.tracvalorile ted și înregistrările de modificare.
- Generator de cereri: Constructorul de tablouri de bord generează cod și afișează costul estimat al creditului. Dezvoltatorii pot verifica parametrii înainte de a-i adăuga la o aplicație.
- Credite gratuite: Fiecare cont nou primește 1,000 de credite API fără a fi nevoie de un card de plată. Alocația permite evaluarea, dar nu se reînnoiește ca perioadă de probă temporară.
Pro
Contra
???? Cum să obții ScrapingBee gratis?
- Operatii Deschise ScrapingBee și înregistrați un cont nou fără card.
- Folosește constructorul de cereri din tabloul de bord pentru a genera un apel de test.
- Fiecare cont nou primește 1,000 de credite API gratuite pentru evaluare.
1,000 de credite gratuite de înscriere
Tabel comparativ al caracteristicilor de top ale scraper-ului webping Instrumente
Cum am ales cel mai bun scraping web gratuit?ping Instrumente?

At Guru99, ne angajăm să oferim informații corecte, relevante și obiective pentru a ajuta utilizatorii să ia decizii în cunoștință de cauză. Procesul nostru editorial se concentrează pe furnizarea de resurse informative și de încredere, asigurându-ne că conținutul este atât credibil, cât și de încredere. După recenzie a peste 18 dintre cele mai bune programe de scraping webping Unelte, inclusiv opțiuni gratuite și plătite, am compilat o selecție cuprinzătoare bazată pe caracteristicile, avantajele, dezavantajele și prețurile acestora. Acest ghid asigură o înțelegere detaliată a fiecărui instrument, ajutându-vă în alegerea celui mai bun pentru nevoile dumneavoastră. Ne concentrăm pe următorii factori în timp ce revizuim un instrument bazat pe funcționalitate, ușurință în utilizare și versatilitate.
- Usor de folosit: Am selectat instrumente pe baza interfeței lor ușor de utilizat, permițând începătorilor și experților să colecteze datele fără probleme.
- Eficiență: Experții din echipa noastră au prioritizat instrumentele optimizate pentru eficiență, asigurând o analiză rapidă și precisă a datelor.tracțiune fără compromisuri.
- De securitate: Ne-am asigurat că am selectat instrumente cu funcții de securitate puternice pentru a proteja datele sensibile și a menține confidențialitatea.
- Adaptabilitate: Am ales instrumentele în funcție de capacitatea lor de a gestiona diverse site-uri web și exemple.tracdate în diverse formate cu ușurință.
- Sprijin comunității: Echipa noastră a luat în considerare instrumente cu comunități active și asistență pentru clienți de încredere pentru a rezolva problemele în mod eficient.
- Flexibilitate: Am selectat instrumente care permit personalizarea, asigurându-ne că răspund nevoilor specifice ale diferiților utilizatori și proiecte.
Ce este un scraping webping instrument și cum funcționează?
O scrapă webping Instrumentul solicită o pagină web, citește conținutul acesteia și ex.traccâmpurile selectate într-un format structurat. Unele instrumente analizează direct HTML-ul. Altele rulează un browser astfel încât JavaScriptul se poate încărca mai întâi. API-urile gestionate rotesc și proxy-urile, reîncearcă cererile blocate și returnează rezultate printr-un singur punct final. Fluxul de lucru începe de obicei cu un URL si extracregula de funcționare. Se termină cu înregistrări în JSON, CSV sau o bază de date. Începătorii ar trebui să decidă mai întâi dacă au nevoie de pagini, câmpuri structurate, capturi de ecran sau monitorizare repetată. Această alegere determină tipul potrivit de instrument.
Ce model de acces gratuit se potrivește nevoilor tale de scraping webping proiect?
Accesul gratuit poate însemna o alocație lunară permanentă, credite unice de înscriere, o perioadă de probă temporară sau o evaluare plătită. Aceste modele nu sunt interschimbabile. Un plan reînnoibil se potrivește sarcinilor recurente mici. Creditele unice funcționează mai bine pentru testarea unei integrări. Perioadele de probă temporare ajută la evaluarea rapidă a asistenței și a obiectivelor dificile. Perioadele de probă plătite oferă adesea trafic proxy de calitate superioară decât un nivel gratuit. Verificați dacă este necesar un card, ce consumă credite și dacă expiră capacitatea neutilizată. Cea mai bună opțiune se potrivește cu frecvența solicitărilor, dificultatea țintei și toleranța pentru reconstrucție ulterioară.
Ce caracteristici ar trebui să cauți într-un web scrapingping instrumente?
Caracteristicile utile depind de lucrare, așa că începeți cu obiectivul și rezultatul dorit. Aceste verificări acoperă principalele decizii de cumpărare:
- De redare: JavaSuportul pentru scripturi este important atunci când datele necesare apar după răspunsul HTML inițial.
- Controlul accesului: Rotația proxy-urilor, sesiunile și direcționarea în funcție de locație determină dacă solicitările ajung la pagini regionale sau protejate.
- ieșire: JSON, CSV, Markdown, capturile de ecran și HTML brut deservesc diferite nevoi de analiză și dovezi.
- Operaacțiuni: Programarea, reîncercările, jurnalele, alertele și limitele de cheltuieli mențin lucrările recurente observabile și controlate.
- Suport: Documentația clară și răspunsul rapid ajută la reducerea timpilor de nefuncționare atunci când obiectivele sau regulile solicitărilor se modifică.
Cum se zgârieping API-urile se compară cu proxy-urile și instrumentele browserului?
Cicatriceping API-urile gestionează cererile, reîncercările și adesea randarea în spatele unui singur endpoint. Acestea sunt potrivite pentru echipele care doresc rezultate fără a opera infrastructură de rețea. Serviciile proxy direcționează doar traficul, așa că utilizatorii au nevoie în continuare de crawlere, parsere, stocare și gestionarea erorilor. Instrumentele browserului rulează JavaScrieți scripturi și simulați acțiuni precum clicuri sau derulări. Acestea gestionează pagini interactive, dar consumă mai multe resurse de calcul. Multe sisteme de producție combină aceste abordări. Un proxy poate suporta un crawler personalizat, în timp ce un browser gestionat gestionează pagini dificile. Alegeți metoda cea mai puțin complexă care returnează în mod fiabil datele necesare.
Cum poate inteligența artificială să îmbunătățească scraping-ul webping fluxuri de lucru?
IA poate traduce cererile de câmp în limbaj simplu în exempletracreguli de tion, normalizează valorile dezordonate și produc JSON sau Markdown mai curate. De asemenea, poate ajuta la repararea selectorilor atunci când machetele paginilor se modifică. Aceste capacități reduc timpul de configurare, în special pentru prototipuri și cercetare. Nu elimină necesitatea validării. Modelele pot eticheta greșit câmpurile, pot rata paginarea ascunsă sau pot îmbina valori fără legătură. Echipele ar trebui să compare mostrele cu pagina sursă și să monitorizeze modificările în timp. IA funcționează cel mai bine ca asistent în cazul solicitărilor controlate, al schemelor clare și al verificărilor de calitate repetabile.
Cum se face scraping-ul webping Instrumentele se conectează cu fluxurile de lucru de date?
Scrapare webping Instrumentele se conectează de obicei prin API-uri REST, SDK-uri, webhook-uri, stocare în cloud sau platforme de automatizare. Un job programat poate colecta pagini, salva înregistrări într-un set de date și trimite un webhook de finalizare. Un alt serviciu poate apoi valida, transforma sau încărca datele într-un depozit de date. Fluxurile de lucru bazate pe inteligență artificială utilizează din ce în ce mai mult ieșirea MCP sau Markdown pentru a furniza pagini curente agenților de cercetare. Integrarea ar trebui să conțină, de asemenea, starea de execuție, marcajele temporale și erorile. Fără acest context, sistemele din aval nu pot distinge înregistrările proaspete de colecțiile incomplete sau eșuate.
Este scraping webping legal și sigur?
Scrapare webping poate fi legală, dar legalitatea depinde de date, metoda de acces, jurisdicție și utilizarea preconizată. Un proiect responsabil ar trebui să documenteze aceste verificări:
- Acces public: Colectați doar informații accesibile în mod legal și relevante pentru un scop comercial sau de cercetare definit.
- Regulile site-ului: RevVezi termenii și condițiile de utilizare, îndrumările roboților, contraclimitele materiale și legile locale aplicabile înainte de colectarea datelor.
- Date personale: Minimizați colectarea, securizați înregistrările păstrate și respectați obligațiile de confidențialitate pentru informațiile identificabile.
- Încărcare solicitată: Folosește tarife rezonabile și memorare în cache, astfel încât traficul automat să nu perturbe site-ul web țintă.
- Revizuire juridică: Solicitați sfaturi calificate atunci când proiectul implică date sensibile, conturi, autentificare sau restricții neclare.
Cum poți proteja scraping-ul webping calitatea datelor?
Calitatea datelor începe cu o schemă clară și pagini de test reprezentative. Validați tipurile de câmpuri, valorile necesare, paginarea, duplicatele și marcajele temporale înainte de scalare. Salvați un mic eșantion de răspuns brut lângă înregistrările analizate, astfel încât erorile să rămână. tracposibil. Monitorizați numărul de înregistrări și ratele de câmpuri lipsă pe parcursul rulărilor. Modificările de aspect creează adesea rezultate plauzibile, dar incorecte, care sunt mai greu de observat decât o solicitare eșuată. Versiunea extracregulile de modificare și comparați mostrele după fiecare modificare. Pentru seturi de date importante, adăugați verificări independente cu pagini sursă de încredere înainte de a publica concluziile.
Cum se face scraping-ul webping Costurile se schimbă pe măsură ce proiectele se extind?
Costurile cresc în funcție de volumul solicitărilor, paginile randate, proxy-urile premium, concurența, stocarea și asistența. Unu URL poate consuma mai multe credite atunci când JavaScriptul, direcționarea în funcție de locație sau ocolirea avansată sunt activate. Încercările eșuate pot fi gratuite cu unele API-uri, dar facturabile cu altele. Calculați costul dintr-un eșantion reprezentativ, nu dintr-un număr simplu de solicitări. Includeți timpul de inginerie pentru întreținerea și monitorizarea parserului. O API gestionată poate costa mai mult per rezultat, dar poate reduce munca operațională. Setați limite de cheltuieli, revizuiți utilizarea în funcție de țintă și separați experimentele de acreditările de producție.
Ce probleme cauzează Web-ul ScraperPot eșua și cum pot fi remediate?
Scraperde obicei eșuează din cauza comportamentului paginii, a regulilor de acces sau a altor probleme.tracipotezele de corecție s-au schimbat. Fiecare corecție ar trebui să abordeze cauza observată, mai degrabă decât să reîncerce orbește.
- Problema: O pagină returnează cod HTML gol deoarece conținutul se încarcă prin aceasta. JavaScenariul după primul răspuns.
Soluţie: Operatorul ar trebui să activeze randarea în browser și să aștepte un selector stabil înainte de extraccompletarea câmpurilor solicitate. - Problema: Solicitările repetate declanșează CAPTCHA-uri, limite de rată sau blocări temporare în timpul rulărilor de colectare mai mari.
Soluţie: Echipa ar trebui să reducă viteza solicitărilor, să rotească proxy-urile adecvate, să reutilizeze sesiunile cu atenție și să respecte regulile de acces ale site-ului. - Problema: O pagină reproiectată mută câmpurile și produce în mod silențios valori goale sau nepotrivite.
Soluţie: Responsabilul cu întreținerea ar trebui să selecteze versiuni, să păstreze mostrele brute și să alerteze atunci când completarea câmpurilor obligatorii scade sub un prag convenit. - Problema: Paginarea se oprește prematur, lăsând produse, comentarii sau listări ulterioare în afara setului de date final.
Soluţie: Dezvoltatorul ar trebui să testeze logica paginii următoare, să înregistreze numărul de pagini și să compare totalurile colectate cu indicatorii vizibili ai sursei. - Problema: Consumul de credite crește neașteptat atunci când sunt activate randarea, rutele premium sau țintele dificile.
Soluţie: Proprietarul ar trebui să estimeze mai întâi solicitările reprezentanților, să stabilească limite de cheltuieli și să separe obiectivele costisitoare în fluxuri de lucru monitorizate. - Problema: Duplicat URLÎncercările sau reîncercările creează înregistrări repetate care distorsionează numărătoarea și analizele din aval.
Soluţie: Canalul ar trebui să atribuie chei de înregistrare stabile, să normalizeze URLs și deduplicarea înainte ca înregistrările să intre în rapoarte sau în spațiul de stocare.
Ce tendințe vor modela scraping-ul webping uneltele urmează?
Scrapare webping platformele se îndreaptă către exemple ghidate de inteligență artificialătracțiune, conexiuni ale agenților și o infrastructură de browser mai flexibilă. Schemele în limbaj simplu pot scurta configurarea, în timp ce integrările MCP permit agenților de cercetare să solicite paginile curente prin instrumente controlate. Furnizorii combină, de asemenea, scraping-ulping, căutare, crawling și acțiuni de browser în spatele conturilor partajate. Conformitatea și originea datelor vor primi mai multă atenție, deoarece colectarea automată alimentează deciziile de afaceri. Tendința utilă este o mai mare observabilitate: echipele au nevoie de costuri clare ale solicitărilor, marcaje temporale ale sursei, ex.tracversiuni și motive de defecțiune. O automatizare mai bună ar trebui să faciliteze aceste controale, nu să le ascundă.
Verdict
Am analizat lista scurtă în funcție de limitele de acces, profunzimea fluxului de lucru și cerințele de scalare. Trei opțiuni ofereau cea mai potrivită pentru scra distincte.ping nevoile mai complexe ale clienților.
- Oxylabs: Am preferat site-ul web gestionat Scraper API pentru ținte dificile, livrare structurată și controale de producție fără a menține o infrastructură separată de browser și proxy.
- Decodo: Recenzia mea l-a plasat pe primul loc pentru acces API gratuit și accesibil, șabloane pregătite, JavaRandare script și rezultate adaptate fluxurilor de lucru bazate pe date sau inteligență artificială.
- NodeMaven: L-am selectat pentru echipele care dețin deja scraping cod și necesită direcționare detaliată în funcție de locație, controale de rotație și adrese proxy verificate.
