
Ce este Star Schema în modelarea Data Warehouse?
 David Carter
⚡ Rezumat inteligent
Schema Star (schemă stea) în modelarea depozitului de date plasează un tabel central de fapte în centrul tabelelor de dimensiuni înconjurătoare, creând un design denormalizat, în formă de stea, care simplifică interogările analitice, accelerează raportarea și alimentează cuburile OLAP pe platformele de business intelligence.
Ce este o schemă stelară?
A schema stea Într-un depozit de date există o structură de modelare în care un tabel central de fapte se conectează la o serie de tabele de dimensiuni asociate. Se numește schemă stea deoarece aspectul seamănă cu o stea, cu tabelul de fapte situat în centru și tabelele de dimensiuni radiind spre exterior ca niște puncte.
Schema stea este cel mai simplu tip de schemă de depozit de date și este cunoscută și sub numele de schema de joncțiune stea. Deoarece tabelele sale de dimensiuni sunt denormalizate, modelul este optimizat pentru interogarea seturilor de date foarte mari, ceea ce îl face o alegere comună pentru modelare dimensională și raportare.
Ce este o schemă multidimensională?
A schemă multidimensională este conceput special pentru a modela sisteme de depozitare a datelor. Aceste scheme abordează nevoile unice ale bazelor de date foarte mari, construite în scopul analitic al OLAP mai degrabă decât pentru procesarea tranzacțiilor de rutină.
Tipuri de scheme de depozit de date: Există trei tipuri principale de scheme multidimensionale, fiecare oferind propriile avantaje.
- Schema stelelor – un tabel central de fapte unit direct cu tabele de dimensiuni denormalizate.
- Schema fulgilor de nea – o extensie a schemei în stea în care dimensiunile sunt normalizate în tabele de subdimensionare suplimentare.
- Schema galaxiei – numită și constelație de fapte, folosește mai multe tabele de fapte care au în comun tabele de dimensiuni.
Deoarece schema fulgului de zăpadă se bazează direct pe schema în stea, este util să comparați cele două modele înainte de a parcurge un exemplu detaliat de schemă în stea.
Schemă Stea vs. Schemă Fulg de Nea
Schema stea și schema fulgului de nea Ambele organizează datele în jurul tabelelor de fapte și dimensiuni, dar diferă prin modul în care sunt stocate dimensiunile. O schemă stea păstrează fiecare dimensiune într-un singur tabel denormalizat, în timp ce o schemă fulg de nea normalizează acele dimensiuni în mai multe tabele corelate.
- Structura: Schema stea este plată și simplă; schema fulg de zăpadă ramifică dimensiunile în subdimensiuni.
- Viteza de interogare: Schemele în stea necesită mai puține joncțiuni, așa că interogările se execută de obicei mai rapid, iar SQL-ul rămâne mai simplu.
- Depozitare: Schemele Snowflake elimină redundanța, deci utilizează mai puțin spațiu, dar adaugă complexitate designului.
- Integritatea datelor: Dimensiunile normalizate ale fulgului de zăpadă impun mai bine integritatea, în timp ce dimensiunile denormalizate ale stelelor favorizează performanța.
- Usor de folosit: O schemă în stea este mai simplu de înțeles pentru analiști și mai rapid de întreținut, în timp ce o schemă în formă de fulg de nea necesită o proiectare mai atentă.
În practică, echipele aleg adesea o schemă în stea pentru data mart-uri și tablouri de bord care necesită raportare rapidă și simplă și o schemă în formă de fulg de nea atunci când economiile de stocare și consecvența strictă contează mai mult.
Exemplu de schemă stea
În următorul exemplu de schemă stea, tabelul de fapte se află în centru și deține cheile pentru fiecare tabel de dimensiuni, cum ar fi Dealer_ID, Model_ID, Date_ID, Product_ID și Branch_ID, împreună cu atribute măsurabile, cum ar fi unitățile vândute și veniturile.
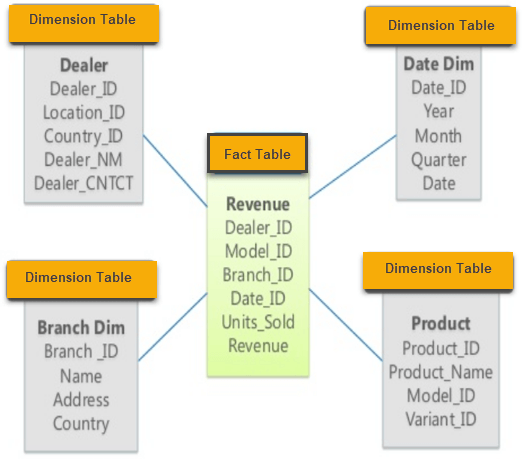
Fiecare tabel de dimensiuni înconjurător adaugă context descriptiv acelor măsuri, astfel încât o singură interogare poate grupa sau filtra informațiile despre vânzări după dealer, model, dată, produs sau sucursală, fără a uni alte tabele.
Tabele de fapte
Un tabel de fapte într-o schemă stea conține fapte și este conectat la dimensiuni. Un tabel de fapte conține două tipuri de coloane:
- O coloană care stochează faptele sau măsurile.
- Chei externe care fac legătura cu fiecare tabel de dimensiuni.
În general, cheia primară a unui tabel de fapte este o cheie compozită alcătuită din toate cheile externe care alcătuiesc tabelul.
Tabelele de fapte pot conține fapte la nivel de detaliu sau fapte agregate. Tabelele de fapte care includ fapte agregate sunt adesea numite tabele sumarizate și conțin de obicei fapte care au fost deja agregate la un anumit nivel.
Tabelele de dimensiuni
O dimensiune este o structură care clasifică datele într-o ierarhie. O dimensiune fără ierarhii și niveluri se numește dimensiune plată sau listă. Cheia primară a fiecărui tabel de dimensiuni face parte din cheia primară compozită a tabelului de fapte.
Un atribut de dimensiune este un atribut textual descriptiv care ajută la descrierea unei valori dimensionale, cum ar fi numele unui produs sau un oraș. Deoarece tabelele de dimensiuni stochează acest context descriptiv și nu evenimente tranzacționale, tabelele de fapte sunt de obicei mult mai mari decât tabelele de dimensiuni.
Cum se proiectează o schemă stea
Proiectarea unei scheme stea urmează abordarea de modelare dimensională popularizată de Ralph Kimball. Scopul este de a organiza măsurile de business în jurul unor dimensiuni clare și reutilizabile, astfel încât modelul finit să fie ușor de interogat și rapid de raportat. Cei cinci pași de mai jos prezintă procesul pe care îl urmează majoritatea proiectelor de modelare dimensională, trecând de la întrebarea de business de cel mai înalt nivel până la tabelele de fapte fizice și dimensiuni.
- Identificați procesul de afaceri: Alegeți activitatea pe care doriți să o analizați, cum ar fi vânzările, expediereaping, sau inventar. Această decizie definește ce va măsura tabelul de fapte.
- Declară grâul: Decideți nivelul de detaliu pe care îl reprezintă fiecare rând de fapte, de exemplu, un rând per linie, per tranzacție sau per zi. O granulație clară menține modelul consecvent.
- Identificați dimensiunile: Enumerați contextul descriptiv necesar pentru a analiza faptele, cum ar fi produsul, clientul, distribuitorul, sucursala și data. Fiecare dintre acestea devine un tabel de dimensiuni cu atribute.
- Identificați faptele: Determinați măsurile numerice pe care afacerea dorește să le track, cum ar fi unitățile vândute, veniturile sau costurile, și le plasați în tabelul central de fapte.
- Construiește steaua: Conectați tabelul de fapte la fiecare dimensiune prin chei externe, keeping dimensiunile au fost denormalizate, astfel încât diagrama formează un singur tabel central de fapte înconjurat de dimensiunile sale.
După ce steaua este construită, adăugați o cheie surogat la fiecare dimensiune, asigurați-vă că fiecare tabel de fapte are o dimensiune de dată asociată și confirmați că toate faptele se află la aceeași granulație. De asemenea, este o practică bună să încărcați mai întâi datele atomice, de nivel inferior, deoarece tabelele sumar pot fi întotdeauna derivate ulterior. Respectarea acestor reguli menține schema optimizată pentru performanță ridicată și simplitate. depozit de date de raportare.
Caracteristicile Schemei Stelare
- Fiecare dimensiune dintr-o schemă în stea este reprezentată de un singur tabel de dimensiuni.
- Fiecare tabel de dimensiuni conține propriul set de atribute.
- Tabelul de dimensiuni este unit la tabelul de fapte folosind o cheie externă.
- Tabelele de dimensiuni nu sunt unite între ele.
- Tabelul de fapte conține chei și măsuri.
- Schema în stea este ușor de înțeles și oferă o utilizare optimă a discului.
- Tabelele de dimensiuni nu sunt normalizate. De exemplu, în exemplul de mai sus, ID_Țară nu are un tabel separat de căutare a țărilor așa cum OLTP designul ar fi.
- Schema este larg acceptată de instrumentele BI.
Avantajele Schemei Stelare
Schema stea oferă mai multe beneficii care o fac un punct de plecare popular pentru proiectarea depozitului de date:
- Schemele stea utilizează o logică de joncțiune mai simplă decât alte scheme atunci când preiau date din surse tranzacționale cu un nivel ridicat de normalizare.
- Schema stea simplifică logica obișnuită de raportare a afacerii, cum ar fi raportarea perioadă de la perioadă la perioadă și la data de raportare.
- Schemele în stea sunt utilizate pe scară largă de sistemele OLAP pentru a construi cuburi eficient, iar o schemă în stea poate servi drept sursă fără a fi nevoie să se proiecteze o structură de cub în majoritatea sistemelor OLAP importante.
- Prin activarea ajustărilor specifice ale performanței care pot fi aplicate interogărilor, procesorul de interogări poate oferi planuri de execuție mai bune.
Dezavantajele schemei stelare
- Deoarece schema este puternic denormalizată, integritatea datelor nu este impusă cu strictețe.
- Nu este flexibil în ceea ce privește nevoile analitice avansate.
- Schemele în stea nu întăresc relațiile de tip „mulți-la-mulți” dintre entitățile comerciale.
Când să utilizați o schemă stea
O schemă stea este alegerea potrivită atunci când performanța rapidă și previzibilă a interogărilor contează mai mult decât economisirea spațiului de stocare. Deoarece modelul își menține tabelele de dimensiuni denormalizate și numărul de joncțiuni redus, aceasta este potrivită pentru sarcinile de lucru analitice în care utilizatorii de business rulează în mod repetat rapoarte, tablouri de bord și agregări similare pe volume mari de date istorice.
Situațiile tipice în care o schemă stea se potrivește bine includ:
- Data mart-uri: Departamental magazine de date cu relații simple și bine înțelese beneficiază de structura lizibilă.
- Tablouri de bord BI: Informații de afaceri Instrumentele se mapează perfect pe schemele stea, astfel încât rapoartele și elementele vizuale sunt rapid de creat.
- Cuburi OLAP: Schemele în stea sunt o sursă naturală pentru cuburi OLAP, agregare și analiză de tip slice-and-dice.
Dacă prioritatea se îndreaptă în schimb către stocare minimă, integritate strictă a datelor sau ierarhii profunde și schimbătoare, o schemă de tip „fulg de nea” sau un design mai normalizat ar putea fi mai potrivite. Multe echipe chiar combină cele două, începând cu o schemă stea și normalizând doar dimensiunile care o necesită cu adevărat.
