
SQL Server Architectură (explicată)
 Fiona Brown
⚡ Rezumat inteligent
SQL Server ArchiStructura urmează un model client-server organizat în trei straturi principale: Stratul Protocol pentru comunicarea în rețea, Motorul Relațional pentru procesarea interogărilor și Motorul de Stocare pentru gestionarea și recuperarea datelor.
MS SQL Server este o arhitectură client-server. Procesul MS SQL Server începe cu trimiterea unei cereri de către aplicația client. SQL Server acceptă, procesează și răspunde la cerere cu date procesate. Să discutăm în detaliu întreaga arhitectură prezentată mai jos:
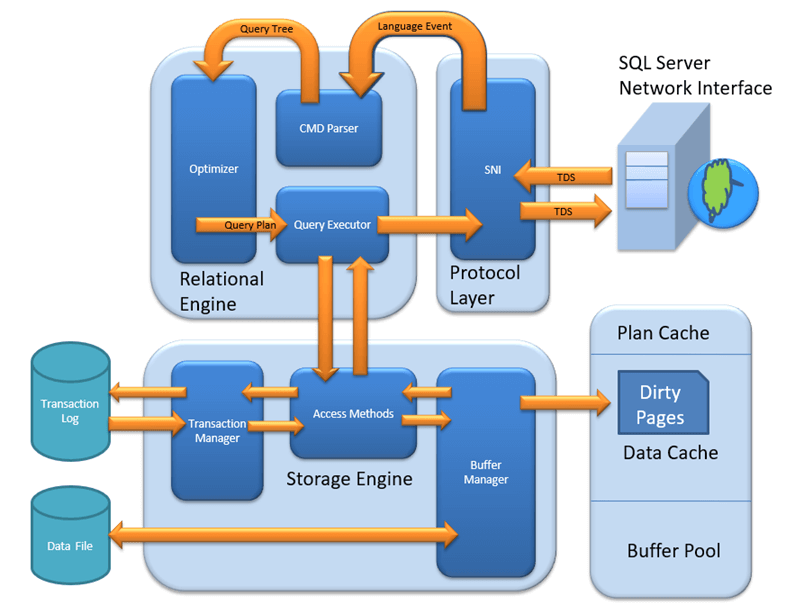
După cum se poate observa în diagrama de mai jos, există trei componente principale în SQL Server Architectura:
- Stratul de protocol
- Motor relațional
- Motor de stocare
Stratul de protocol – SNI
Stratul de protocol SQL Server, cunoscut și sub denumirea de Interfață de rețea a serverului (SNI), acceptă trei tipuri de arhitectură client-server. Fiecare protocol deservește un scenariu de rețea diferit. Înțelegerea acestor protocoale este esențială înainte de a explora modul în care interogările sunt procesate intern.
Memorie partajată
Să luăm în considerare un scenariu de conversație de dimineață devreme. Tom și mama lui sunt în același loc logic, acasă. Tom cere cafea, iar mama i-o servește direct. În mod similar, SQL Server oferă protocolul Shared Memory atunci când clientul și serverul rulează pe aceeași mașină. Ambele comunică prin memorie partajată, fără nicio supraîncărcare a rețelei.

Analogie: Tom se mapează la Client, Mom se mapează la SQL Server, Home se mapează la Machine, iar comunicarea verbală se mapează la protocolul Shared Memory.

Note de configurare: In SQL Management Studio, opțiunea „Nume server” pentru o conexiune locală poate fi „.”, „localhost”, „127.0.0.1” sau „Mașină\Instanță”.
TCP / IP
Acum, să ne gândim că Tom dorește cafea de la un magazin situat la 10 km distanță. Tom este acasă, iar cafeneaua se află într-o piață aglomerată. Ei comunică printr-o rețea celulară. În mod similar, SQL Server oferă... Protocol TCP / IP când clientul și SQL Server se află pe mașini separate conectate printr-o rețea.

Analogie: Tom se mapează la Client, cafeneaua la SQL Server, rețeaua de acasă și piața la locații îndepărtate, iar rețeaua celulară la protocolul TCP/IP.

Note de configurare: În SQL Management Studio, opțiunea „Nume server” pentru o conexiune TCP/IP trebuie să fie „Mașină\Instanță a serverului”. SQL Server utilizează portul 1433 în mod implicit pentru conexiunile TCP/IP.
Țevi numite
În cele din urmă, Tom vrea ceai verde de la vecina sa, Sierra. Se află în aceeași locație fizică, fiind vecini, și comunică printr-o rețea internă. În mod similar, SQL Server oferă protocolul Named Pipe atunci când clientul și serverul sunt conectate printr-o rețea locală (LAN).

Analogie: Tom se mapează la Client, Sierra se mapează la SQL Server, vecinii se mapează la LAN, iar intra-rețea se mapează la protocolul Named Pipe.
Note de configurare: Funcția Named Pipes este dezactivată în mod implicit și trebuie activată prin SQL Configuration Manager.
Ce este TDS?
Acum, că cele trei tipuri de arhitectură client-server sunt clare, iată o privire asupra TDS:
- TDS înseamnă Tabular Data Stream.
- Toate cele trei protocoale utilizează pachete TDS.
- TDS este încapsulat în pachete de rețea, permițând transferul de date de la mașina client la mașina server.
- TDS a fost dezvoltat inițial de Sybase și este acum deținut de Microsoft.
Următorul tabel compară cele trei protocoale de conectare SQL Server:
| Caracteristică | Memorie partajată | TCP / IP | Țevi numite |
|---|---|---|---|
| Domeniul de aplicare al rețelei | Aceeași mașină | La distanță (WAN/Internet) | Numai LAN |
| Port implicit | - | 1433 | 445 |
| Performanţă | Cel mai rapid (fără costuri suplimentare de rețea) | Bun (optimizat pentru WAN) | Bun (optimizat pentru LAN) |
| Activat în mod implicit | Da | Da | Nu |
| Cel mai bun caz de utilizare | Dezvoltare și testare locală | Acces de la distanță pentru producție | Medii LAN de încredere |
Odată cu gestionarea comunicațiilor în rețea prin intermediul nivelului de protocol, următorul pas în arhitectura SQL Server este procesarea interogării în sine. Aici preia controlul motorul relațional.
Motor relațional
Motorul relațional este cunoscut și sub denumirea de Procesor de interogări. Acesta conține componentele SQL Server care determină ce trebuie să facă o interogare și cum poate fi executată cel mai eficient. Este responsabil pentru executarea interogărilor utilizatorului prin solicitarea de date de la Motorul de stocare și procesarea rezultatelor returnate.
Așa cum este ilustrat în diagrama arhitecturală, există trei componente majore ale Motorului Relațional:
Analizor CMD
Datele primite de la nivelul Protocolului sunt transmise către Motorul Relațional. Parserul CMD este prima componentă care primește datele interogării. Sarcina sa principală este de a verifica interogarea pentru erori sintactice și semantice și apoi de a genera un arbore de interogare.

Verificare sintactică: Ca orice alt limbaj de programare, SQL Server are un set predefinit de cuvinte cheie și reguli gramaticale. SELECT, INSERT, UPDATE și multe altele aparțin listei de cuvinte cheie predefinite. Analizatorul CMD verifică dacă datele introduse respectă aceste reguli. Dacă datele introduse de utilizator deviază de sintaxa așteptată, analizorul returnează o eroare.
Exemplu: Să luăm în considerare un rus care intră într-un restaurant japonez și comandă în rusă. Chelnerul înțelege doar japoneza și nu poate procesa comanda. În mod similar, dacă un utilizator tastează „SELECR” în loc de „SELECT”, parserul CMD returnează o eroare deoarece nu recunoaște cuvântul cheie.
Verificare semantică: Acest proces este efectuat de Normalizator. Acesta verifică dacă numele coloanelor, numele tabelelor și alte obiecte interogate există într-adevăr în schemă. Dacă există, Normalizatorul le leagă de interogare. Acest proces este cunoscut și sub numele de Legare. Când interogările utilizatorului conțin o VIEW (vizualizare), Normalizatorul o înlocuiește cu definiția vizualizării stocată intern.
Exemplu: Alergare SELECT * from USER_ID ar determina parserul să genereze o eroare în timpul verificării semantice dacă tabelul USER_ID nu există în baza de date.
Creați arbore de interogări: Acest pas generează diferiți arbori de execuție care reprezintă diversele moduri în care o interogare poate fi executată. Toți arborii produc același rezultat dorit.
Instrumentul de optimizare a
Optimizatorul creează un plan de execuție pentru interogarea utilizatorului. Acest plan determină modul în care va fi executată interogarea. Nu toate interogările sunt optimizate. Optimizarea se aplică comenzilor DML (Data Modification Language) precum SELECT, INSERT, DELETE și UPDATE. Comenzile DDL precum CREATE și ALTER nu sunt optimizate, ci sunt compilate într-un formular intern.

Costul interogării este calculat pe baza unor factori precum utilizarea CPU, utilizarea memoriei și nevoile de intrare/ieșire. Rolul optimizatorului este de a găsi cel mai ieftin plan de execuție eficient din punct de vedere al costurilor, nu neapărat cel mai bun.
Exemplu: Imaginează-ți că vrei să deschizi un cont bancar online. O bancă durează maximum 2 zile. De asemenea, ai o listă cu alte 20 de bănci, care pot dura sau nu mai puțin timp. Căutarea în toate cele 20 de bănci s-ar putea să nu găsești o opțiune mai rapidă, iar căutarea în sine costă timp. Ar fi fost mai bine să alegi prima bancă. În mod similar, optimizatorul SQL folosește algoritmi exhaustivi și euristici pentru a minimiza timpul de execuție a interogărilor.
Optimizatorul caută în trei faze:
Faza 0: Căutarea unui plan trivial
Aceasta este etapa de pre-optimizare. Pentru unele interogări, există un singur plan practic, cunoscut sub numele de plan trivial. Nu este nevoie să se caute mai departe, deoarece orice căutare suplimentară ar găsi același plan de execuție la un cost suplimentar.
Faza 1: Căutarea planurilor de procesare a tranzacțiilor
Aceasta include căutarea atât a planurilor simple, cât și a celor complexe. Căutarea planului simplu utilizează analiza statistică a datelor de coloană și index, de obicei restricționată la un index per tabel. Dacă nu se găsește niciun plan simplu, se efectuează o căutare mai complexă care implică mai mulți indexuri per tabel.
Faza 2: Procesare paralelă și optimizare
Dacă strategiile anterioare nu produc un plan adecvat, Optimizatorul caută posibilități de procesare paralelă pe baza capacităților de procesare ale mașinii. Dacă procesarea paralelă nu este posibilă, începe o fază finală de optimizare care utilizează toate opțiunile rămase pentru a găsi cel mai bun plan de execuție posibil.
Executor de interogări
Executorul de interogări apelează metoda de acces din motorul de stocare. Acesta oferă un plan de execuție care conține logica de preluare a datelor necesară pentru execuție. Odată ce datele sunt primite de la motorul de stocare, rezultatul este publicat în nivelul de protocol și trimis utilizatorului final.

După ce Motorul Relațional stabilește cum să execute o interogare, Motorul de Stocare se ocupă de operațiunile cu datele fizice. Acest strat gestionează modul în care datele sunt stocate, memorate în cache și recuperate de pe disc.
Motor de stocare
Motorul de stocare este responsabil pentru stocarea datelor într-un sistem de stocare, cum ar fi un disc sau o rețea SAN, și pentru recuperarea acestora atunci când este nevoie. Înainte de a examina componentele motorului de stocare, este important să înțelegem cum sunt stocate fizic datele.

Fișiere de date și extensii
Fișierele de date stochează fizic datele sub formă de pagini de date, fiecare pagină având o dimensiune de 8KB. Aceasta este cea mai mică unitate de stocare din SQL ServerPaginile de date sunt grupate logic în extensii. Niciunui obiect nu i se atribuie direct o pagină individuală; în schimb, întreținerea se face prin extensii. Fiecare pagină are un antet de pagină (96 de octeți) care conține metadate precum tipul paginii, numărul paginii, spațiul utilizat, spațiul liber și indicatori către paginile următoare și anterioare.
Tipuri de fișiere

Fișier principal: Fiecare bază de date conține un fișier principal. Acesta stochează toate datele importante legate de tabele, vizualizări, declanșatoare și alte obiecte. Extensia este de obicei .mdf, dar poate fi orice extensie.
Fișier secundar: O bază de date poate conține sau nu mai multe fișiere secundare. Acestea sunt opționale și conțin date specifice utilizatorului. Extensia este de obicei .ndf, dar poate fi orice extensie.
Fișier jurnal: Cunoscute și sub denumirea de jurnale de scriere anticipată. Extensia este .ldf. Fișierele jurnal sunt utilizate pentru gestionarea tranzacțiilor, recuperarea din instanțe nedorite și efectuarea rollback-ului tranzacțiilor nevalidate.
Motorul de stocare are trei componente principale. Fiecare joacă un rol specific în gestionarea accesului la date și a integrității acestora.
Metoda de acces
Metoda de acces acționează ca o interfață între Executorul de interogări și Buffer Manager sau Jurnale de tranzacții. Nu efectuează execuția în sine, ci determină tipul de interogare:
- Dacă interogarea este o Instrucțiunea SELECT (DML), este transmis către Buffer Manager pentru procesare ulterioară.
- Dacă interogarea este o Instrucțiuni non-SELECT (DDL și DML), este transmisă Managerului de tranzacții. Aceasta include în mare parte instrucțiunile UPDATE, INSERT și DELETE.

Buffer Manager
Buffer Manager gestionează funcțiile de bază pentru Plan Cache, analiza datelor și gestionarea paginilor murdare.

Cache de planuri
Plan de interogare existent: Buffer Manager verifică dacă planul de execuție există în memoria cache a planurilor stocată. Dacă există, planul de interogare din memoria cache și memoria cache a datelor asociată sunt utilizate direct.
Plan de cache pentru prima utilizare: Dacă un plan de execuție a primei interogări este complex, acesta este stocat în memoria cache a planului. Acest lucru asigură o disponibilitate mai rapidă data viitoare când SQL Server primește aceeași interogare.
Analiza datelor: Buffer Cache și stocare de date
Buffer Managerul oferă acces la datele necesare. Sunt posibile două abordări, în funcție de existența datelor în memoria cache:
Buffer Cache – Analiză soft
Buffer Managerul caută date în Buffer Cache. Dacă datele sunt prezente, Query Executor le utilizează direct. Acest lucru îmbunătățește performanța deoarece preluarea datelor din cache necesită mai puține operațiuni I/O în comparație cu preluarea din spațiul de stocare pe disc.

Stocarea datelor – Analiză hard
Dacă datele nu sunt prezente în Buffer Cache, datele necesare sunt căutate în memoria de stocare de date de pe disc. Datele sunt apoi stocate și în memoria cache pentru utilizare ulterioară.

Manager de tranzacții
Managerul de tranzacții este invocat atunci când metoda de acces determină că o interogare este o instrucțiune non-SELECT. Acesta asigură consistența și durabilitatea datelor prin intermediul mai multor subcomponente:

Manager de jurnal
Managerul de jurnal păstrează track din toate actualizările efectuate în sistem prin intermediul jurnalelor stocate în Jurnalele de Tranzacții. Fiecare intrare în jurnal conține un Număr de Secvență al Jurnalului, împreună cu ID-ul Tranzacției și Înregistrarea Modificării Datelor. Acest mecanism tractranzacții confirmate și anulate (ks).
Manager de blocare
În timpul unei tranzacții, datele asociate din spațiul de stocare intră într-o stare blocată. Managerul de blocări gestionează acest proces, asigurând consistența și izolarea datelor. Aceste proprietăți sunt cunoscute și sub denumirea de ACID (Atomicitate, consistență, izolare, durabilitate).
Procesul de execuție
Procesul de execuție urmează acești pași:
- Managerul de jurnal începe înregistrarea în jurnal, iar Managerul de blocări blochează datele asociate.
- O copie a datelor este păstrată în Buffer cache.
- O copie a datelor care urmează să fie actualizate este păstrată în Jurnal Bufferși toate evenimentele actualizează datele din Date Buffer.
- Paginile care stochează date modificate sunt cunoscute sub numele de Pagini murdare.
Înregistrare în jurnal cu puncte de control și scriere anticipată
Procesul punctului de control rulează aproximativ o dată pe minut și marchează toate paginile murdare pentru scriere pe disc. Cu toate acestea, pagina este mai întâi mutată pe pagina de date a fișierului jurnal din Buffer Jurnal. Acest mecanism este cunoscut sub numele de înregistrare în jurnal cu scriere anticipată. Paginile murdare rămân în memoria cache chiar și după ce au fost scrise pe disc.
leneș Writer
Când SQL Server observă o încărcare mare și este necesară memorie tampon pentru tranzacții noi, acesta eliberează paginile murdare din memoria cache. Writer funcționează pe algoritmul LRU (Least Recently Used - cele mai puțin utilizate) pentru a curăța paginile din buffer pool-ul pe disc.
Cum procesează SQL Server o interogare end-to-end
Înțelegerea fiecărui strat în parte este valoroasă, dar observarea modului în care acestea funcționează împreună clarifică imaginea completă. Când o aplicație client trimite o interogare SQL, are loc următoarea secvență:
Stratul de protocol primește cererea prin memorie partajată, TCP/IP sau conducte numite și o încadrează într-un pachet TDS. Motor relațional apoi preia controlul: analizorul CMD verifică sintaxa și semantica, optimizatorul generează cel mai ieftin plan de execuție, iar executorul de query începe recuperarea datelor.
Executorul de interogări apelează Motorul de stocare Metoda de acces, care direcționează interogările SELECT către Buffer Manager și interogări de modificare către Managerul de tranzacții. Buffer Managerul verifică memoria cache a planului și Buffer Cache mai întâi (analiză soft). Dacă datele nu sunt memorate în cache, efectuează o citire a discului (analiză hard). Pentru operațiunile de scriere, Transaction Manager coordonează Log Manager, Lock Manager și procesul de checkpoint pentru a asigura conformitatea ACID.
Odată ce Storage Engine returnează datele solicitate, Relational Engine formatează setul de rezultate, iar Protocol Layer le livrează înapoi aplicației client prin același protocol TDS.
Cum să alegi protocolul potrivit pentru conexiunile SQL Server
Selectarea protocolului corect depinde de relația fizică dintre client și server, precum și de cerințele de performanță.
Utilizați memoria partajată când aplicația client rulează pe aceeași mașină ca SQL Server. Aceasta este cea mai rapidă opțiune deoarece elimină toate cheltuielile de rețea. Este ideală pentru dezvoltare locală, testare și implementări pe o singură mașină.
Utilizați TCP/IP când clientul și serverul se află pe mașini diferite conectate printr-o rețea WAN sau internet. Acesta este protocolul cel mai frecvent utilizat în mediile de producție. SQL Server ascultă implicit pe portul 1433, iar acest protocol acceptă conexiuni criptate prin TLS.
Utilizați conducte denumite când clientul și serverul se află pe aceeași rețea LAN de încredere și performanța în rețelele interne este o prioritate. Canalele cu nume sunt dezactivate în mod implicit și trebuie activate prin SQL Server Configuration Manager. Este mai puțin frecventă în implementările moderne, dar rămâne utilă pentru aplicațiile intranet vechi.
