
Modelul Seq2seq (Secvență la Secvență) cu PyTorch
 Echipa editorială
⚡ Rezumat inteligent
Seq2Seq este o arhitectură de tip encoder-decoder care mapează o secvență de intrare la o secvență de ieșire folosind două rețele neuronale recurente, alimentând traducerea automată și alte sarcini de procesare a limbajului natural în care lungimile de intrare și ieșire diferă.
Ce este NLP?
NLP sau Prelucrarea Limbajului Natural este una dintre ramurile populare ale Inteligenței Artificiale care ajută computerele să înțeleagă, să manipuleze sau să răspundă unui om în limbajul său natural. NLP este motorul din spatele... Google Translate care ne ajută să înțelegem alte limbi.
Ce este Seq2Seq?
Seq2Seq este o metodă de traducere automată bazată pe codificator-decodor și procesare a limbajului care mapează o intrare a secvenței la o ieșire a secvenței cu o etichetă și o valoare de atenție. Ideea este de a folosi 2 RNN-uri care vor lucra împreună cu un token special și vor încerca să prezică următoarea secvență de stare din secvența anterioară.
Cum să preziceți secvența din secvența anterioară
Următorii sunt pașii pentru a prezice o secvență din secvența anterioară cu PyTorch.
Pasul 1) Încărcarea datelor noastre
Pentru setul nostru de date, veți folosi un set de date de la Perechi de propoziții bilingve delimitate de tabulatori. Aici voi folosi setul de date din engleză în indoneziană. Puteți alege orice doriți, dar nu uitați să schimbați numele fișierului și directorul din cod.
from __future__ import unicode_literals, print_function, division
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F

import numpy as np
import pandas as pd

import os
import re
import random

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
Pasul 2) Pregătirea datelor
Nu puteți utiliza setul de date direct. Trebuie să împărțiți propozițiile în cuvinte și să le convertiți într-un vector cu un singur punct de reper. Fiecare cuvânt va fi indexat în mod unic în clasa Lang pentru a crea un dicționar. Clasa Lang va stoca fiecare propoziție și o va împărți cuvânt cu cuvânt cu ajutorul funcției addSentence. Apoi, creați un dicționar indexând fiecare cuvânt necunoscut pentru modelele Sequence to Sequence.
SOS_token = 0
EOS_token = 1
MAX_LENGTH = 20

#initialize Lang Class
class Lang:
   def __init__(self):
       #initialize containers to hold the words and corresponding index
       self.word2index = {}
       self.word2count = {}
       self.index2word = {0: "SOS", 1: "EOS"}
       self.n_words = 2  # Count SOS and EOS

#split a sentence into words and add it to the container
   def addSentence(self, sentence):
       for word in sentence.split(' '):
           self.addWord(word)

#If the word is not in the container, the word will be added to it, else, update the word counter
   def addWord(self, word):
       if word not in self.word2index:
           self.word2index[word] = self.n_words
           self.word2count[word] = 1
           self.index2word[self.n_words] = word
           self.n_words += 1
       else:
           self.word2count[word] += 1
Clasa Lang este o clasă care ne va ajuta să creăm un dicționar. Pentru fiecare limbă, fiecare propoziție va fi împărțită în cuvinte și apoi adăugată în container. Fiecare container va stoca cuvintele în indexul corespunzător, va număra cuvintele și va adăuga indexul cuvântului, astfel încât să îl putem folosi pentru a găsi indexul unui cuvânt sau pentru a găsi un cuvânt din indexul său.
Deoarece datele noastre sunt separate prin TAB, trebuie să le utilizați panda ca încărcător de date. Pandas va citi datele noastre ca un dataFrame și le va împărți în propoziția sursă și propoziția țintă. Pentru fiecare propoziție pe care o aveți, o veți normaliza la litere mici, veți elimina toate caracterele non-caractere, veți converti în ASCII din Unicode și veți împărți propozițiile astfel încât să aveți fiecare cuvânt în ea.
#Normalize every sentence
def normalize_sentence(df, lang):
   sentence = df[lang].str.lower()
   sentence = sentence.str.replace('[^A-Za-z\s]+', '')
   sentence = sentence.str.normalize('NFD')
   sentence = sentence.str.encode('ascii', errors='ignore').str.decode('utf-8')
   return sentence

def read_sentence(df, lang1, lang2):
   sentence1 = normalize_sentence(df, lang1)
   sentence2 = normalize_sentence(df, lang2)
   return sentence1, sentence2

def read_file(loc, lang1, lang2):
   df = pd.read_csv(loc, delimiter='\t', header=None, names=[lang1, lang2])
   return df

def process_data(lang1,lang2):
   df = read_file('text/%s-%s.txt' % (lang1, lang2), lang1, lang2)
   print("Read %s sentence pairs" % len(df))
   sentence1, sentence2 = read_sentence(df, lang1, lang2)

   source = Lang()
   target = Lang()
   pairs = []
   for i in range(len(df)):
       if len(sentence1[i].split(' ')) < MAX_LENGTH and len(sentence2[i].split(' ')) < MAX_LENGTH:
           full = [sentence1[i], sentence2[i]]
           source.addSentence(sentence1[i])
           target.addSentence(sentence2[i])
           pairs.append(full)

   return source, target, pairs
O altă funcție utilă pe care o veți folosi este conversia perechilor în tensori. Acest lucru este foarte important deoarece rețeaua noastră citește doar date de tip tensor. De asemenea, este important deoarece aceasta este partea în care, la fiecare sfârșit de propoziție, va exista un token pentru a indica rețelei că intrarea s-a terminat. Pentru fiecare cuvânt din propoziție, aceasta va obține indexul de la cuvântul corespunzător din dicționar și va adăuga un token la sfârșitul propoziției.
def indexesFromSentence(lang, sentence):
   return [lang.word2index[word] for word in sentence.split(' ')]

def tensorFromSentence(lang, sentence):
   indexes = indexesFromSentence(lang, sentence)
   indexes.append(EOS_token)
   return torch.tensor(indexes, dtype=torch.long, device=device).view(-1, 1)

def tensorsFromPair(input_lang, output_lang, pair):
   input_tensor = tensorFromSentence(input_lang, pair[0])
   target_tensor = tensorFromSentence(output_lang, pair[1])
   return (input_tensor, target_tensor)
Modelul Seq2Seq

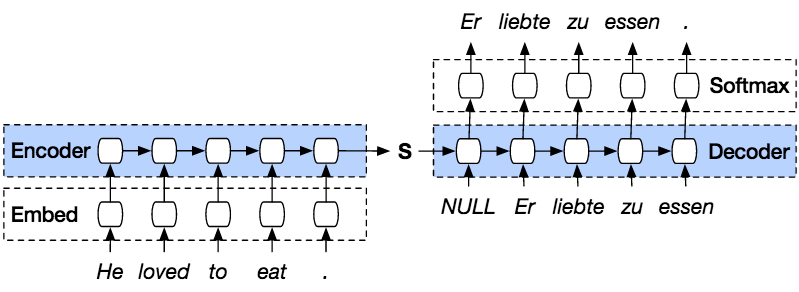
PyTorModelul ch Seq2seq este un tip de model care folosește un PyTorDecodorul ch este amplasat deasupra modelului. Encodorul va codifica propoziția cuvânt cu cuvânt într-un index de vocabular sau cuvinte cunoscute cu un index, iar decodorul va prezice ieșirea intrării codificate decodând intrarea în secvență și va încerca să utilizeze ultima intrare ca următoare intrare, dacă este posibil. Cu această metodă, este posibilă și prezicerea următoarei intrări pentru a crea o propoziție. Fiecărei propoziții i se va atribui un token pentru a marca sfârșitul secvenței. La sfârșitul predicției, va exista și un token pentru a marca sfârșitul ieșirii. Deci, de la encodor, acesta va transmite o stare către decodor pentru a prezice ieșirea.

Codificatorul va codifica propoziția noastră de intrare cuvânt cu cuvânt în secvență, iar la final va exista un token pentru a marca sfârșitul unei propoziții. Codificatorul este format dintr-un strat de încorporare și un strat GRU. Stratul de încorporare este un tabel de căutare care stochează încorporarea datelor noastre de intrare într-un dicționar de cuvinte de dimensiune fixă. Acesta va fi transmis unui strat GRU. Stratul GRU este o unitate recurentă cu porți care constă dintr-un tip de... RNN care va calcula intrarea secvențială. Acest strat va calcula starea ascunsă față de cel precedent și va actualiza resetarea, actualizarea și porțile noi.

Decodorul va decodifica intrarea de la ieșirea encoderului. Va încerca să prezică următoarea ieșire și să o folosească ca următoare intrare, dacă este posibil. Decodorul este format dintr-un strat de încorporare, un strat GRU și un strat liniar. Stratul de încorporare va crea un tabel de căutare pentru ieșire și îl va transmite unui strat GRU pentru a calcula starea de ieșire prezisă. După aceea, un strat liniar va ajuta la calcularea funcției de activare pentru a determina valoarea reală a ieșirii prezise.
class Encoder(nn.Module):
   def __init__(self, input_dim, hidden_dim, embbed_dim, num_layers):
       super(Encoder, self).__init__()

       #set the encoder input dimesion , embbed dimesion, hidden dimesion, and number of layers
       self.input_dim = input_dim
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.num_layers = num_layers

       #initialize the embedding layer with input and embbed dimention
       self.embedding = nn.Embedding(input_dim, self.embbed_dim)
       #intialize the GRU to take the input dimetion of embbed, and output dimention of hidden and
       #set the number of gru layers
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)

   def forward(self, src):
       embedded = self.embedding(src).view(1,1,-1)
       outputs, hidden = self.gru(embedded)
       return outputs, hidden

class Decoder(nn.Module):
   def __init__(self, output_dim, hidden_dim, embbed_dim, num_layers):
       super(Decoder, self).__init__()

#set the encoder output dimension, embed dimension, hidden dimension, and number of layers
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.output_dim = output_dim
       self.num_layers = num_layers

# initialize every layer with the appropriate dimension. For the decoder layer, it will consist of an embedding, GRU, a Linear layer and a Log softmax activation function.
       self.embedding = nn.Embedding(output_dim, self.embbed_dim)
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)
       self.out = nn.Linear(self.hidden_dim, output_dim)
       self.softmax = nn.LogSoftmax(dim=1)

   def forward(self, input, hidden):
# reshape the input to (1, batch_size)
       input = input.view(1, -1)
       embedded = F.relu(self.embedding(input))
       output, hidden = self.gru(embedded, hidden)
       prediction = self.softmax(self.out(output[0]))
       return prediction, hidden

class Seq2Seq(nn.Module):
   def __init__(self, encoder, decoder, device, MAX_LENGTH=MAX_LENGTH):
       super().__init__()

#initialize the encoder and decoder
       self.encoder = encoder
       self.decoder = decoder
       self.device = device

   def forward(self, source, target, teacher_forcing_ratio=0.5):
       input_length = source.size(0) #get the input length (number of words in sentence)
       batch_size = target.shape[1]
       target_length = target.shape[0]
       vocab_size = self.decoder.output_dim

#initialize a variable to hold the predicted outputs
       outputs = torch.zeros(target_length, batch_size, vocab_size).to(self.device)

#encode every word in a sentence
       for i in range(input_length):
           encoder_output, encoder_hidden = self.encoder(source[i])

#use the encoder's hidden layer as the decoder hidden
       decoder_hidden = encoder_hidden.to(device)

#add a token before the first predicted word
       decoder_input = torch.tensor([SOS_token], device=device)  # SOS

#topk is used to get the top K value over a list
#predict the output word from the current target word. If we enable the teaching force, then the next decoder input is the next word, else, use the decoder output highest value.
       for t in range(target_length):
           decoder_output, decoder_hidden = self.decoder(decoder_input, decoder_hidden)
           outputs[t] = decoder_output
           teacher_force = random.random() < teacher_forcing_ratio
           topv, topi = decoder_output.topk(1)
           input = (target[t] if teacher_force else topi)
           if(teacher_force == False and input.item() == EOS_token):
               break

       return outputs
Pasul 3) Antrenarea modelului
Procesul de antrenament în modelele Seq2seq începe cu convertirea fiecărei perechi de propoziții în Tensori din indicele lor Lang. Modelul nostru secvență-secvență va folosi SGD ca optimizator și funcția NLLLoss pentru a calcula pierderile. Procesul de antrenament începe cu introducerea perechii de propoziții în model pentru a prezice rezultatul corect. La fiecare pas, rezultatul modelului va fi calculat cu cuvintele adevărate pentru a găsi pierderile și a actualiza parametrii. Așadar, deoarece veți utiliza 75000 de iterații, modelul nostru secvență-secvență va genera 75000 de perechi aleatorii din setul nostru de date.
teacher_forcing_ratio = 0.5

def clacModel(model, input_tensor, target_tensor, model_optimizer, criterion):
   model_optimizer.zero_grad()

   input_length = input_tensor.size(0)
   loss = 0
   epoch_loss = 0
   # print(input_tensor.shape)

   output = model(input_tensor, target_tensor)

   num_iter = output.size(0)
   print(num_iter)

#calculate the loss from a predicted sentence with the expected result
   for ot in range(num_iter):
       loss += criterion(output[ot], target_tensor[ot])

   loss.backward()
   model_optimizer.step()
   epoch_loss = loss.item() / num_iter

   return epoch_loss

def trainModel(model, source, target, pairs, num_iteration=20000):
   model.train()

   optimizer = optim.SGD(model.parameters(), lr=0.01)
   criterion = nn.NLLLoss()
   total_loss_iterations = 0

   training_pairs = [tensorsFromPair(source, target, random.choice(pairs))
                     for i in range(num_iteration)]

   for iter in range(1, num_iteration+1):
       training_pair = training_pairs[iter - 1]
       input_tensor = training_pair[0]
       target_tensor = training_pair[1]

       loss = clacModel(model, input_tensor, target_tensor, optimizer, criterion)

       total_loss_iterations += loss

       if iter % 5000 == 0:
           avarage_loss= total_loss_iterations / 5000
           total_loss_iterations = 0
           print('%d %.4f' % (iter, avarage_loss))

   torch.save(model.state_dict(), 'mytraining.pt')
   return model
Pasul 4) Testați modelul
Procesul de evaluare al Seq2seq PyTorch este pentru a verifica rezultatul modelului. Fiecare pereche de modele Secvență-Secvență va fi introdusă în model și va genera cuvintele prezise. După aceea, veți analiza cea mai mare valoare la fiecare rezultat pentru a găsi indicele corect. Și, în final, o veți compara pentru a vedea predicția modelului nostru cu propoziția adevărată.
def evaluate(model, input_lang, output_lang, sentences, max_length=MAX_LENGTH): with torch.no_grad(): input_tensor = tensorFromSentence(input_lang, sentences[0]) output_tensor = tensorFromSentence(output_lang, sentences[1]) decoded_words = [] output = model(input_tensor, output_tensor) # print(output_tensor) for ot in range(output.size(0)): topv, topi = output[ot].topk(1) # print(topi) if topi[0].item() == EOS_token: decoded_words.append('' ) break else: decoded_words.append(output_lang.index2word[topi[0].item()]) return decoded_words def evaluateRandomly(model, source, target, pairs, n=10): for i in range(n): pair = random.choice(pairs) print('source {}'.format(pair[0])) print('target {}'.format(pair[1])) output_words = evaluate(model, source, target, pair) output_sentence = ' '.join(output_words) print('predicted {}'.format(output_sentence))
Acum, să începem antrenamentul cu Seq to Seq, cu un număr de iterații de 75000 și un număr de straturi RNN de 1 cu o dimensiune ascunsă de 512.
lang1 = 'eng'
lang2 = 'ind'
source, target, pairs = process_data(lang1, lang2)

randomize = random.choice(pairs)
print('random sentence {}'.format(randomize))

#print number of words
input_size = source.n_words
output_size = target.n_words
print('Input : {} Output : {}'.format(input_size, output_size))

embed_size = 256
hidden_size = 512
num_layers = 1
num_iteration = 100000

#create encoder-decoder model
encoder = Encoder(input_size, hidden_size, embed_size, num_layers)
decoder = Decoder(output_size, hidden_size, embed_size, num_layers)

model = Seq2Seq(encoder, decoder, device).to(device)

#print model
print(encoder)
print(decoder)

model = trainModel(model, source, target, pairs, num_iteration)
evaluateRandomly(model, source, target, pairs)
După cum puteți vedea, propoziția noastră prezisă nu se potrivește foarte bine, așa că pentru a obține o acuratețe mai mare, trebuie să vă antrenați cu mult mai multe date și să încercați să adăugați mai multe iterații și un număr de straturi folosind învățarea secvență la secvență.
random sentence ['tom is finishing his work', 'tom sedang menyelesaikan pekerjaannya']
Input : 3551 Output : 4253
Encoder(
  (embedding): Embedding(3551, 256)
  (gru): GRU(256, 512)
)
Decoder(
  (embedding): Embedding(4253, 256)
  (gru): GRU(256, 512)
  (out): Linear(in_features=512, out_features=4253, bias=True)
  (softmax): LogSoftmax()
)
5000 4.0906
10000 3.9129
15000 3.8171
20000 3.8369
25000 3.8199
30000 3.7957
75000 3.7044
