
SAP DS (Servicii de date) în HANA
 Mason Garcia
⚡ Rezumat inteligent
SAP Data Services este platforma ETL a întreprinderii care mută și curăță datele din surse eterogene în SAP HANA. Designer, Job Server, Engine, Repository și Access Server lucrează împreună pentru a construi, programa și rula fluxuri de date.
Ce Este SAP Servicii de date?
SAP Data Services este un instrument ETL care oferă o soluție unică la nivel de întreprindere pentru integrarea, transformarea, calitatea datelor, profilarea datelor și procesarea datelor text dintr-o sursă eterogenă într-o bază de date țintă sau un depozit de date.
Aplicațiile, numite joburi, sunt create în Designer, unde harta datelorping și transformarea sunt definite. Produsul este denumit și SAP BusinessObjects Data Services, prescurtat ca SAP BODS, iar ambele denumiri descriu același instrument. SAP Data Services 4.3 este versiunea curentă; versiunea 4.2 a ajuns la sfârșitul perioadei de întreținere mainstream pe 31 mai 2023, așadar noile implementări ar trebui să înceapă cu versiunea 4.3.
În cadrul unui SAP Peisaj HANA, SAP Serviciile de date sunt opțiunea aleasă atunci când datele trebuie remodelate pe parcurs, mai degrabă decât copiate așa cum sunt. Secțiunile de mai jos prezintă ce oferă instrumentul, cum se îmbină componentele sale și o sarcină de lucru completă dintr-un SAP Tabelul ECC în SAP HANA.
Caracteristicile SAP Servicii de date
Capacitățile de mai jos explică de ce SAP Data Services este poziționată ca o platformă de nivel enterprise, mai degrabă decât ca un simplu utilitar de copiere.
- Oferă transformări paralele de înaltă performanță.
- Are instrumente administrative complete și un instrument de raportare.
- Acceptă mai mulți utilizatori.
- SAP BODS este foarte flexibil cu aplicațiile bazate pe servicii web.
- Permite un limbaj de scripting cu seturi bogate de funcții.
- SAP Serviciile de date se pot integra cu SAP Server de replicare LT (SLT) folosind tehnologie bazată pe declanșatoare. SLT adaugă capabilități delta la fiecare SAP sau non-SAP tabelul sursă, care permite capturarea datelor modificate și transferul datelor delta din tabelul sursă.
- Validarea datelor cu tablouri de bord și audit de proces.
- Un instrument de administrare cu capacități de programare și monitorizare a tablourilor de bord.
- Depanare, profilare încorporată și vizualizare date.
- SAP Serviciile de date acceptă o gamă largă de surse și ținte:
- Orice aplicație, de exemplu SAP.
- Orice bază de date, cu încărcare în bloc și captura de date modificate.
- Fișiere: lățime fixă, delimitate prin virgulă, COBOL, XML și Excel.
Aceste caracteristici sunt oferite de un set mic de componente instalabile, fiecare cu un rol distinct.
Componente ale SAP Servicii de date
SAP Serviciile de date au următoarele componente.
- proiectant – Este un instrument de dezvoltare prin care putem crea, testa și executa un job care populează un depozit de date. Permite dezvoltatorului să creeze obiecte și să le configureze selectând o pictogramă într-o diagramă de flux sursă-țintă. Poate fi utilizat pentru a crea o aplicație specificând fluxurile de lucru și de date. Pentru a deschide Data Services Designer, accesați Meniu Start -> Toate programele -> SAP Servicii de date -> Designer de servicii de date.

- Server de locuri de muncă – Este o aplicație care lansează motorul de procesare Data Services și servește ca interfață pentru motor și suita Data Services.
- Motor – Motorul Data Services execută joburile individuale definite în aplicație.
- Repertoriu – Repozitoriul este o bază de date care stochează obiecte predefinite de Designer și obiecte definite de utilizator (metadate sursă și țintă, reguli de transformare). Repozitoriile sunt de două tipuri:
- Depozitul local (utilizat de Designer și Job Server).
- Depozitul central (utilizat pentru partajarea obiectelor și controlul versiunilor).
- Server de acces – Serverul de acces transmite mesaje între aplicațiile web, serverul de joburi Data Services și motoare.
- Administrator – Administratorul web asigură administrarea bazată pe browser a resurselor Serviciilor de Date, detaliată după cum urmează:
- Configurarea, pornirea și oprireaping servicii în timp real.
- Planificarea, monitorizarea și executarea joburilor în lot.
- Configurarea serverului de joburi, a serverului de acces și a utilizării repozitoriului.
- Gestionarea utilizatorilor.
- Publicarea joburilor în lot și a serviciilor în timp real prin intermediul serviciilor web.
- Configurarea și gestionarea adaptoarelor.
Cunoașterea funcției fiecărei componente reprezintă doar jumătate din imagine. Arhitectura de mai jos arată cum comunică acestea în timpul unei încărcări.
SAP Servicii de date Architectură
Arhitectura serviciilor de date are următoarele componente:
- Depozit central – este utilizat pentru configurarea depozitului pentru serverele de joburi, gestionarea securității, controlul versiunilor și partajarea obiectelor.
- Designer – utilizat pentru a crea un proiect, un job, un flux de lucru și un flux de date și pentru a le rula.
- Depozit local – aici puteți crea, modifica și porni joburi, fluxuri de lucru și fluxuri de date.
- Server și motor de lucrări – gestionează lucrările.
- Server de acces – este utilizat pentru a executa joburile în timp real create de dezvoltatori în repozitorii.
În imaginea de mai jos sunt prezentate Serviciile de Date și relațiile dintre componentele sale.

SAP BODS Architectură
Detaliu fereastră de designer
Designerul este componenta în care un dezvoltator petrece cel mai mult timp, așa că merită să aprofundezi mai întâi aspectul său. Detaliile fiecărei secțiuni a Data Services Designer sunt prezentate mai jos:
- Bara de instrumente (utilizat pentru Deschidere, Salvare, Înapoi, Validare, Executare etc.).
- Zona Proiectului (conține proiectul curent, care include jobul, fluxul de lucru și fluxul de date. În Data Services, toate entitățile sunt obiecte).
- Spațiu de lucru (zona ferestrei aplicației în care definim, afișăm și modificăm obiecte).
- Biblioteca de obiecte locale (conține obiecte din repozitoriul local, cum ar fi transformări, joburi, fluxuri de lucru, fluxuri de date etc.).
- Paleta de instrumente (butoanele din paleta de instrumente vă permit să adăugați obiecte noi în spațiul de lucru).

Ierarhia obiectelor
Diagrama de mai jos prezintă relațiile ierarhice pentru tipurile de obiecte cheie din cadrul Data Services.

Notă: Legenda de mai jos identifică elementele opționale din ierarhie.

Fluxurile de lucru și condițiile sunt opționale.
Obiectele folosite în SAP Serviciile de date sunt detaliate mai jos.
| Obiecte | Descriere |
|---|---|
| Proiect | Un proiect este obiectul de cel mai înalt nivel din fereastra Designer. Proiectele vă oferă o modalitate de a organiza celelalte obiecte pe care le creați în Data Services. Doar un singur proiect este deschis la un moment dat, unde „deschis” înseamnă „vizibil în zona proiectului”. |
| Loc de munca | Un „job” este cea mai mică unitate de lucru pe care o puteți programa independent pentru execuție. |
| Script-uri | Un subset de linii într-o procedură. |
| Workflow | Un „flux de lucru” este încorporarea mai multor fluxuri de date într-un flux coerent de lucru pentru un întreg proiect. Un flux de lucru este opțional. Un flux de lucru este o procedură care poate:
|
| Flux de date | Un „flux de date” este procesul prin care datele sursă sunt transformate în date țintă. Un flux de date este un obiect reutilizabil. Este întotdeauna apelat dintr-un flux de lucru sau dintr-un job. Este utilizat pentru:
|
| Magazin de date | Un canal logic care conectează Data Services la bazele de date sursă și țintă. Depozite de date:
|
| Target | Tabelul sau fișierul în care Data Services încarcă date din sursă. |
SAP Servicii de date vs. SLT vs. DXC
SAP Serviciile de date sunt una dintre multele furnizarea datelor opțiuni pentru SAP HANA, iar alegerea celei greșite adaugă costuri pe care nicio ajustare nu le poate recupera. Tabelul de mai jos compară cele trei metode pe server.
| Criterii | SAP Servicii de date | SLT | DXC |
|---|---|---|---|
| Latență | În lot sau programat | Timp real | Lot, programat de DataSource |
| Transformare | ETL complet, curățare și profilare | Reguli simple de filtrare și câmp | Nimeni dincolo de fosttraclogica tor |
| Domeniul de aplicare al sursei | SAP și non-SAP, fișiere, aplicații | SAP și non-SAP baze de date | SAP Numai Suită Business |
| Este necesar un server suplimentar | Da, Job Server | De obicei da | Nu |
| Cel mai potrivit pentru | Calitatea datelor și consolidarea multi-sursă | Operaraportare națională pe date în timp real | Reutilizarea conținutului de afaceri existent, ex.tractori |
Pe scurt, alege SAP Servicii de date atunci când datele trebuie curățate, unite sau standardizate înainte de a fi livrate. Alegeți SLT atunci când raportul trebuie să reflecte tranzacția așa cum se întâmplă și DXC când un expert în conținut de afaceri dovedittractor produce deja semantica de care aveți nevoie. Pentru un set de date unic, fără programare repetitivă, un încărcare fișier plat este mai rapid decât configurarea oricăreia dintre cele trei.
Cum se încarcă datele dintr-un SAP Tabel sursă folosind SAP Servicii de date
Totul în Data Services este un obiect. Este nevoie de un depozit de date separat pentru fiecare bază de date sursă și țintă.
Secvența completă pentru încărcarea datelor dintr-un SAP Tabelul sursă este listat mai jos. Fiecare pas este apoi prezentat în detaliu.
- Creați un depozit de date între sursă și BODS
- Importați metadatele (structurile) în BODS
- Configurați serverul de import
- Importați metadatele în sistemul HANA
- Creați un depozit de date între BODS și HANA
- Creați un proiect
- Creați un job (în lot sau în timp real)
- Creați un flux de lucru
- Creați un flux de date
- Adăugați obiecte la fluxul de date
- Execută treaba
- Verificați previzualizarea datelor în HANA
Pas 1) Creați un depozit de date între SAP sursă și BODS.
- Pentru a încărca date dintr-un SAP sursa în SAP HANA prin SAP BODS, este necesar un datastore. Așadar, creăm mai întâi un datastore, așa cum se arată mai jos – Proiect -> Nou -> Magazin de date

- Va apărea o fereastră pop-up pentru Creare depozit de date nou. Introduceți detaliile de mai jos:
- Introduceți numele depozitului de date „ds_ecc”.
- Selectați numele tipului de depozit de date ca „SAP Aplicații”.
- Introduceți numele serverului bazei de date.
- Introduceți numele de utilizator și parola.
- Faceți clic pe butonul „Aplicați”.
- Faceți clic pe butonul „OK”.

- Depozitul de date va fi creat. Vizualizați depozitul de date creat așa cum este prezentat mai jos.
- Accesați Biblioteca de obiecte locale.
- Selectați fila Depozit de date.
- Va fi afișat depozitul de date „ds_ecc”.

Pas 2) Importați metadatele (structura) în serverul BODS.
Am creat un depozit de date pentru ECC către BODS; acum importăm metadate din ECC în BODS. Pentru a importa, urmați pașii de mai jos.
- Selectați depozitul de date „ds_ecc” și faceți clic dreapta pe el.
- Selectați opțiunea Import după nume.

Va fi afișată o fereastră pop-up pentru Import după nume. Introduceți detaliile de mai jos:
- Selectați Tip ca tabel.
- Introduceți numele tabelului de importat. Aici importăm tabelul KNA1.
- Faceți clic pe butonul „Import”. Tabelul KNA1 va apărea sub nodul Tabel al sursei de date „ds_ecc”.

Metadatele tabelului vor fi importate în datastore-ul ds_ecc după cum urmează.

Pas 3) Configurați serverul de import.
Până acum am importat un tabel în datastore-ul „ds_ecc” creat pentru ECC pentru a SAP Conexiune BODS. Pentru a importa date în SAP HANA, trebuie să configurăm serverul de import.
- Pentru a face acest lucru, du-te la Vizualizare rapidă -> Configurare server de import ca mai jos.

- Va apărea o fereastră pop-up pentru Selectare sistem. Selectați SAP Sistemul HANA (HDB aici), așa cum se arată mai jos.

- Faceți clic pe butonul „Următorul”. Va apărea o altă fereastră pop-up pentru acreditările Data Services. Introduceți următoarele detalii:
- SAP Adresa serverului BODS (aici BODS:6400).
- SAP Numele depozitului BODS (numele depozitului HANAUSER).
- Sursă de date ODBC (ZTDS_DS).
- Port implicit pentru SAP Serverul BODS (8080).

Faceți clic pe butonul „Finalizare”.
Pas 4) Importați metadatele în sistemul HANA.
Serverul de import este acum configurat, astfel încât metadatele pot fi importate din SAP Serverul BODS.
- Faceți clic pe opțiunea Import din Vizualizare rapidă.
- Va fi afișată o fereastră pop-up pentru opțiunile de import. Selectați opțiunea „Import selectiv al metadatelor”.

Faceți clic pe butonul „Next”.
Va fi afișată o fereastră pop-up pentru „Import selectiv al metadatelor”, în care selectăm sistemul țintă.
- selectaţi SAP Sistemul HANA (HDB aici).

Faceți clic pe butonul „Next”.
Pas 5) Creați un depozit de date între BODS și HANA.
În BODS este necesar un depozit de date separat pentru sursă și destinație. Depozitul de date sursă există deja, așa că în continuare se creează un depozit de date destinație între BODS și HANA cu numele „DS_BODS_HANA”.
- Accesați Proiect -> Nou -> Magazin de date.
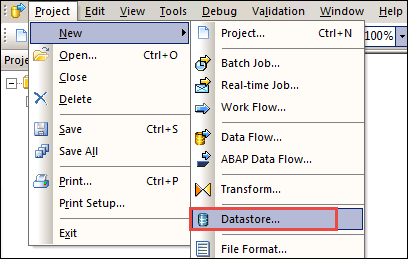
- Va apărea un ecran pentru Creare depozit de date nou, ca mai jos.
- Introduceți numele depozitului de date (DS_BODS_HANA).
- Introduceți tipul depozitului de date ca Bază de date.
- Introduceți tipul bazei de date ca SAP HANA.
- Selectați versiunea bazei de date.
- Introduceţi SAP Numele serverului bazei de date HANA.
- Introduceți numele portului pentru SAP Baza de date HANA.
- Introduceți numele de utilizator și parola.
- Bifați „Activați transferul automat de date”.

Faceți clic pe „Aplicați” și apoi pe butonul „OK”.
Depozitul de date „DS_BODS_HANA” va fi afișat în fila Depozit de date din Biblioteca de obiecte locale, așa cum se arată mai jos.

- Acum importăm un tabel în datastore-ul „DS_BODS_HANA”.
- Selectați depozitul de date „DS_BODS_HANA” și faceți clic dreapta pe el.
- Selectați Import după nume.

- Va apărea o fereastră pop-up pentru Import după nume, ca mai jos.
- Selectați Tip ca tabel.
- Introduceți numele ca KNA1.
- Proprietarul va fi afișat ca Hanauser.
- Faceți clic pe butonul Import.

Tabelul va fi importat în depozitul de date „DS_BODS_HANA”. Pentru a vizualiza datele din tabel, urmați pașii de mai jos.
- Faceți clic pe tabelul „KNA1” din depozitul de date „DS_BODS_HANA”.
- Datele vor fi afișate în format tabelar.

Pasul 6) Definiți proiectul. Un proiect grupează și organizează obiecte corelate. Un proiect poate conține orice număr de joburi, fluxuri de lucru și fluxuri de date.
- Accesați meniul Proiect Designer.
- Selectați opțiunea Nou.
- Selectați opțiunea Proiect.

Apare o fereastră pop-up pentru crearea unui proiect nou, ca mai jos. Introduceți numele proiectului și faceți clic pe butonul Creare. Aceasta va crea un folder pentru proiect, în cazul nostru BODS_DHK.

Pasul 7) Definiți postul. Un job este un obiect reutilizabil. Acesta conține fluxuri de lucru și fluxuri de date. Joburile pot fi executate manual sau programat. Pentru a executa un proces BODS, trebuie definit un job.
Creăm un job numit JOB_Customer.
- Selectați proiectul (BODS_DHK) creat în pasul anterior, faceți clic dreapta și selectați „New Batch Job”.
- Redenumiți-l în „JOB_Customer”.

Pasul 8) Definiți fluxul de lucru.
- Selectați jobul „JOB_Customer” în zona proiectului.
- Faceți clic pe butonul flux de lucru din paleta de instrumente. Faceți clic pe zona goală a spațiului de lucru. O pictogramă de flux de lucru va apărea în spațiul de lucru.
- Schimbați numele fluxului de lucru în „WF_Customer”.

Faceți clic pe numele fluxului de lucru și în spațiul de lucru va apărea o vizualizare goală pentru fluxul de lucru.

Pasul 9) Definiți fluxul de date.
- Faceți clic pe fluxul de lucru „WF_Customer”.
- Faceți clic pe butonul flux de date din paleta de instrumente. Faceți clic pe zona goală a spațiului de lucru. O pictogramă pentru fluxul de date va apărea în spațiul de lucru.
- Schimbați numele fluxului de date în „DF_Customer”.
- Fluxul de date apare și în zona proiectului din stânga, sub numele jobului.

Pasul 10) Adăugați obiecte la fluxul de date.
În cadrul fluxului de date, oferim instrucțiuni pentru transformarea datelor sursă în forma dorită pentru tabelul țintă.
Se folosesc trei obiecte:
- Un obiect pentru sursă.
- Un obiect pentru tabelul țintă.
- Un obiect pentru transformarea Query, care mapează coloanele de la sursă la țintă.
Faceți clic pe fluxul de date DF_Customer. Va apărea un spațiu de lucru gol, ca mai jos.
- Specificați obiectul pentru sursă – Accesați depozitul de date „ds_ecc”, selectați tabelul KNA1 și glisați-l și plasați-l pe ecranul gol al fluxului de date.
- Specificați obiectul pentru țintă – Selectați depozitul de date „DS_BODS_HANA” din depozit și selectați tabelul KNA1.
- Trageți și plasați-l în spațiul de lucru și selectați „Creare Target„”. Acum vor exista două tabele, una sursă și una destinație.

- Transformarea interogării – Acesta este un instrument utilizat pentru a recupera date pe baza schemei de intrare pentru o condiție specifică utilizatorului și pentru a transporta date de la sursă la destinație.
- Selectați pictograma Transformare interogare din paleta de instrumente și trageți-o și plasați-o între obiectele sursă și țintă din spațiul de lucru.
- Legați obiectul Query la sursă.
- Legați obiectul Query la tabelul țintă.

Double-faceți clic pe pictograma Interogare pentru a mapa coloanele din schema de intrare la schema de ieșire. O mapareping apare o fereastră în care facem următoarele:
- Tabelul sursă KNA1 este selectat.
- Selectați toate coloanele din tabelul sursă, faceți clic dreapta și selectați Mapă la ieșire.
- Rezultatul țintă este selectat ca Interogare, iar coloanele vor fi mapate.

Salvați și validați proiectul. Faceți clic pe pictograma Validare. Apare o fereastră pop-up care confirmă succesul validării.

Pasul 11) Executați lucrarea. Pentru a executa lucrarea, urmați calea de mai jos.
- Selectați pictograma zonei proiectului pentru a deschide proiectul și selectați proiectul creat.
- Selectați jobul și faceți clic dreapta.
- Selectați opțiunea Executare pentru a executa jobul.
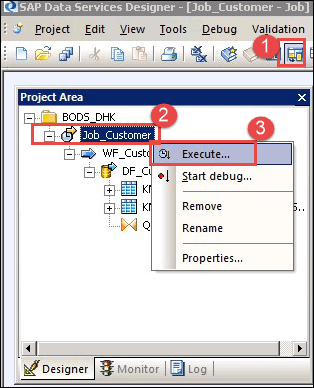
După executarea lucrării, se afișează o fereastră Jurnal lucrări, în care apar toate mesajele referitoare la lucrare. Ultimul mesaj va fi „Jurnal lucrări” este finalizată cu succes”.

Pasul 12) Validați și verificați datele din SAP Baza de date HANA.
- Conectați-vă la SAP Baza de date HANA prin SAP HANA Studioși selectați schema HANAUSER.
- Selectați tabelul KNA1 din nodul Tabel.
- Faceți clic dreapta pe tabelul KNA1 și selectați Deschidere previzualizare date.
- Datele KNA1 încărcate de procesul BODS vor fi afișate în ecranul de previzualizare a datelor.

Un număr de rânduri corespondent între tabelul sursă și această previzualizare confirmă încărcarea finalizată corect, iar jobul poate fi apoi programat de Administrator pentru execuții repetate.
