
Modelul de date relațional în SGBD: Concepts & Exemplu
 Echipa editorială
⚡ Rezumat inteligent
Modelul relațional reprezintă o bază de date ca o colecție de relații, unde fiecare relație este un tabel de rânduri și coloane. Acesta definește concepte de bază, constrângeri de integritate și operațiuni de actualizare care mențin datele relaționale consistente și ușor de interogat.
Ce este modelul relațional?
Model relațional (RM) reprezintă baza de date ca o colecție de relații. O relație nu este altceva decât un tabel de valori. Fiecare rând din tabel reprezintă o colecție de valori de date asociate. Aceste rânduri din tabel denotă o entitate sau o relație din lumea reală.
Numele tabelului și numele coloanelor ajută la interpretarea semnificației valorilor din fiecare rând. Datele sunt reprezentate ca un set de relații. În modelul relațional, datele sunt stocate sub formă de tabele. Cu toate acestea, stocarea fizică a datelor este independentă de modul în care datele sunt organizate logic.
Modelul a fost propus de EF Codd în 1970 și rămâne fundamentul aproape tuturor bazelor de date utilizate astăzi. Câteva sisteme populare de gestionare a bazelor de date relaționale sunt:
- DB2 și Informix Dynamic Server – IBM
- Oracle și RDB – Oracle
- SQL Server și acces - Microsoft
Modelul relațional Concepts în SGBD
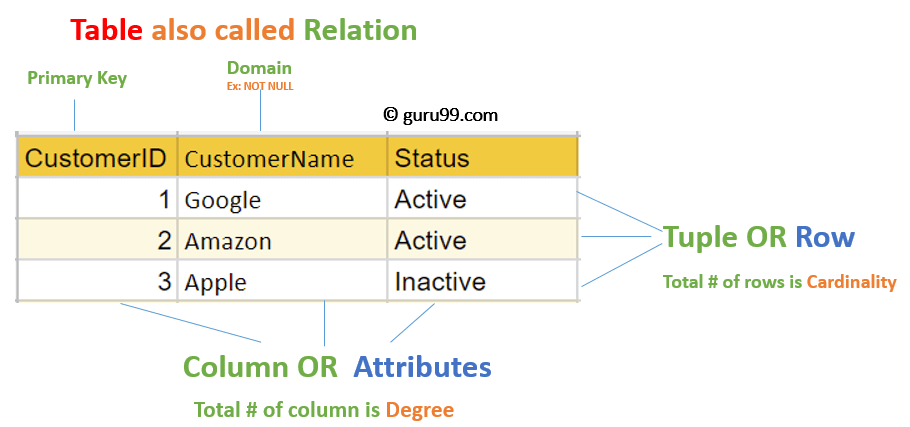
- Atribut: Fiecare coloană dintr-un tabel. Atributele sunt proprietățile care definesc o relație, de exemplu, Student_Rollnr, NUME etc.
- Mese: În modelul relațional, relațiile sunt salvate în format tabelar. Acestea sunt stocate împreună cu entitățile lor. Un tabel are două proprietăți, rânduri și coloane. Rândurile reprezintă înregistrări, iar coloanele reprezintă atribute.
- tuplu: Nu este altceva decât un singur rând al unui tabel, care conține o singură înregistrare.
- Schema de relații: O schemă de relație reprezintă numele relației cu atributele acesteia.
- Gradul: Numărul total de atribute din relație se numește gradul relației.
- Cardinalitate: Numărul total de rânduri prezente în tabel.
- Coloană: Coloana reprezintă setul de valori pentru un anumit atribut.
- Instanța relației: O instanță de relație este o mulțime finită de tupluri în sistemul RDBMS. Instanțele de relație nu au niciodată tupluri duplicate.
- Cheie de relație: Fiecare rând are unul, două sau mai multe atribute, numite cheia relației.
- Domeniul atributelor: Fiecare atribut are o valoare și un domeniu de aplicare predefinite, cunoscute sub numele de domeniu al atributelor.
Cu vocabularul la locul lui, următoarea preocupare este keeping datele din acele relații sunt valide, ceea ce este sarcina constrângerilor de integritate.
Relațional Integrity Constrângerile
Restricțiile de integritate relațională în SGBD se referă la condițiile care trebuie să fie prezente pentru o relație validă. Aceste restricții relaționale sunt derivate din regulile din mini-lumea pe care o reprezintă baza de date.
Există multe tipuri de constrângeri de integritate. Constrângerile impuse sistemului de gestionare a bazelor de date relaționale sunt în mare parte împărțite în trei categorii principale:
- Constrângeri de domeniu
- Constrângeri cheie
- Referenţial Integrity Constrângerile
Constrângeri de domeniu
Restricțiile de domeniu pot fi încălcate dacă valoarea unui atribut nu apare în domeniul corespunzător sau dacă nu este de tipul de date corespunzător.
Constrângerile de domeniu specifică faptul că, în cadrul fiecărui tuplu, valoarea fiecărui atribut trebuie să fie atomică și extrasă din domeniul corect. Domeniile sunt specificate ca tipuri de date, care includ tipuri standard, cum ar fi numere întregi, numere reale, caractere, valori booleene și șiruri de lungime variabilă.
Exemplu:
CREATE DOMAIN CustomerName
CHECK (value NOT NULL)
Exemplul prezentat demonstrează crearea unei constrângeri de domeniu astfel încât CustomerName să nu fie NULL.
Constrângeri cheie
Un atribut care poate identifica în mod unic un tuplu într-o relație se numește cheia tabelului. Valoarea atributului pentru diferite tupluri din relație trebuie să fie unică.
Exemplu:
În tabelul dat, CustomerID este un atribut cheie al tabelului Customer. Cel mai probabil, există o singură cheie pentru un client; CustomerID = 1 este doar pentru CustomerName „GoogleO prezentare completă a diferitelor tipuri de chei este prezentată în ghidul pentru Chei DBMS.
| Număr de înregistrare client | Numele clientului | Stare |
|---|---|---|
| 1 | Activ | |
| 2 | Amazon | Activ |
| 3 | Apple | Inactiv |
Referenţial Integrity Constrângerile
Restricțiile de integritate referențială în SGBD-uri se bazează pe conceptul de chei externe. O cheie externă este un atribut important al unei relații, la care ar trebui să se facă referire în alte relații. O constrângere de integritate referențială apare atunci când o relație se referă la un atribut cheie al unei relații diferite sau identice. Elementul cheie respectiv trebuie să existe în tabelul la care se face referire.
Exemplu:

În exemplul de mai sus, avem două relații, Client și BillING.
Tuplul pentru CustomerID = 1 este referențiat de două ori în relație Billing. Deci știm NumeClient „Google„are o sumă de facturare de 300 USD.”
Operațiuni în Modelul Relațional
Patru operațiuni de actualizare de bază sunt efectuate asupra modelului de baze de date relaționale: inserare, actualizare, ștergere și selectare.
- Funcția Insert este utilizată pentru a insera date în relație.
- Delete este folosit pentru a șterge tupluri din tabel.
- Modificare vă permite să modificați valorile unor atribute în tupluri existente.
- Select vă permite să alegeți un interval specific de date.
Ori de câte ori se aplică una dintre aceste operațiuni, constrângerile de integritate specificate în schema bazei de date relaționale nu trebuie niciodată încălcate.
Insera OperaTION
Operația de inserare oferă valorile atributelor pentru un nou tuplu care ar trebui inserat într-o relație.

Actualizează OperaTION
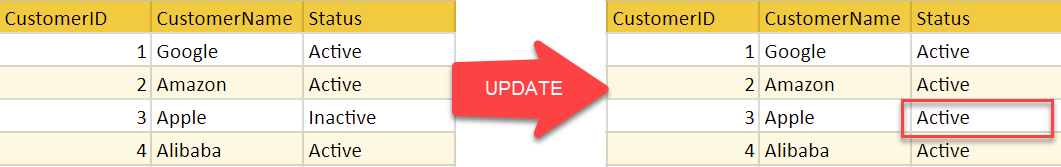
Puteți vedea că în tabelul de relații de mai jos, CustomerName „Apple” este actualizat de la Inactiv la Activ.
Șterge OperaTION
Pentru a specifica ștergerea, o condiție asupra atributelor relației selectează tuplu care trebuie șters.

În exemplul de mai sus, CustomerName „Apple” este șters din tabel.
Operația de ștergere ar putea încălca integritatea referențială dacă tuplul șters este referențiat de chei externe din alte tupluri din același Baza de date.
Selectați OperaTION

În exemplul de mai sus, NumeClient „Amazon" este selectat.
Model relațional vs. modele ierarhice și de rețea
Modelul relațional a înlocuit două abordări anterioare, iar contrastul explică de ce a devenit dominant. Tabelul de mai jos prezintă cele trei una lângă alta.
| Aspect | Modelul relațional | Model ierarhic | Model de rețea |
|---|---|---|---|
| Structure | Tabele (relații) | Arbore, de la părinte la copil | Grafic, de la mulți la mulți |
| Acces la date | Declarativ, prin valoare | Navigație, pe cale | Navigație, prin indicator |
| Relaţii | Cheile externe | Legături părinte-copil | Seturi și pointeri |
| Limbajul de interogare | SQL | Cod procedural | Cod procedural |
| Flexibilitate | Înalt | Scăzut | Mediu |
Deoarece modelul relațional abordează datele prin valoare, mai degrabă decât prin navigarea prin legături fizice, un limbaj de nivel înalt precum SQL poate exprima o interogare fără a ști cum sunt stocate datele.
Cele mai bune practici pentru crearea unui model relațional
- Datele trebuie reprezentate ca o colecție de relații.
- Fiecare relație trebuie reprezentată clar în tabel.
- Rândurile ar trebui să conțină date despre instanțele unei entități.
- Coloanele trebuie să conțină date despre atributele entității.
- Celulele tabelului trebuie să conțină o singură valoare.
- Fiecare coloană ar trebui să aibă un nume unic.
- Nicio două rânduri nu pot fi identice.
- Valorile unui atribut ar trebui să provină din același domeniu.
Avantajele modelului de baze de date relaționale
- Simplitate: Un model de date relațional într-un SGBD este mai simplu decât modelele ierarhice și de rețea.
- Independență structurală: Baza de date relațională se preocupă doar de date și nu de structură, ceea ce poate îmbunătăți performanța modelului.
- Ușor de utilizat: Modelul relațional este ușor de utilizat, deoarece tabelele formate din rânduri și coloane sunt naturale și simplu de înțeles.
- Capacitate de interogare: Acest lucru face posibil ca un limbaj de interogare de nivel înalt, precum SQL, să evite navigarea complexă în bazele de date.
- Independenta datelor: Structura unei baze de date relaționale poate fi modificată fără a fi nevoie să se modifice vreo aplicație.
- Scalable: În ceea ce privește numărul de înregistrări sau rânduri și numărul de câmpuri, o bază de date poate fi extinsă pentru a-i îmbunătăți utilizabilitatea.
Dezavantajele modelului relațional
- Puține baze de date relaționale au limite privind lungimea câmpurilor, care nu pot fi depășite.
- Bazele de date relaționale pot deveni uneori complexe pe măsură ce cantitatea de date crește, iar relațiile dintre elementele de date devin mai complicate.
- Sistemele complexe de baze de date relaționale pot duce la baze de date izolate în care informațiile nu pot fi partajate de la un sistem la altul.
