
MongoDB Expresie regulată ($regex) cu exemple
 Echipa editorială
⚡ Rezumat inteligent
MongoDB Expresiile regulate efectuează potrivirea de șabloane pentru a găsi șiruri de caractere în documente, folosind operatorul $regex, indicatorul $options pentru insensibilitatea la majuscule/minuscule, ancore pentru potriviri exacte și delimitatori slash atunci când valoarea exactă a câmpului este necunoscută.
Expresiile regulate sunt folosite pentru potrivirea modelelor, care este practic pentru găsirea șirurilor de caractere în documente.
Uneori, atunci când preluați documente dintr-o colecție, este posibil să nu știți exact care este valoarea exactă a câmpului pe care să o căutați. Prin urmare, se pot folosi expresii regulate pentru a ajuta la preluarea datelor bazate pe valorile de căutare potrivite pentru modele.
Folosind operatorul $regex pentru potrivirea modelelor
Operatorul $regex din MongoDB este folosit pentru a căuta anumite șiruri din colecție. Următorul exemplu arată cum se poate face acest lucru.
Să presupunem că avem aceeași colecție Angajați care are numele de câmp „Employeeid” și „EmployeeName”. Să presupunem, de asemenea, că avem următoarele documente în colecția noastră.
| Card de identitate al angajatului | numele angajatului |
|---|---|
| 22 | NewMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
În codul de mai jos am folosit operatorul $regex pentru a specifica criteriile de căutare.

db.Employee.find({EmployeeName : {$regex: "Gu" }}).forEach(printjson)
Code Explicaţie:
- Aici dorim să găsim toate numele angajaților care conțin caracterele „Gu”. Prin urmare, specificăm operatorul $regex pentru a defini criteriile de căutare pentru „Gu”.
- Printjson este folosit pentru a imprima fiecare document care este returnat de interogare într-un mod mai bun.
Dacă comanda este executată cu succes, va fi afișată următoarea ieșire:
ieșire:

Rezultatul arată în mod clar că acele documente în care numele angajatului conține caracterele „Gu” sunt returnate.
Dacă presupunem că colecția dvs. are următoarele documente, împreună cu un document suplimentar care conține numele angajatului ca „Guru999”. Dacă ați introdus criteriile de căutare ca „Guru99”, ar returna și documentul care avea „Guru999”. Dar să presupunem că nu am dori acest lucru și am dori doar să returnăm documentul cu „Guru99”. Apoi putem face acest lucru cu potrivirea exactă a modelelor. Pentru a face o potrivire exactă a modelelor, vom folosi caracterele ^ și $. Vom adăuga caracterul ^ la începutul șirului și $ la sfârșitul șirului.
| Card de identitate al angajatului | numele angajatului |
|---|---|
| 22 | NewMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 8 | Guru999 |
Următorul exemplu arată cum se poate face acest lucru.
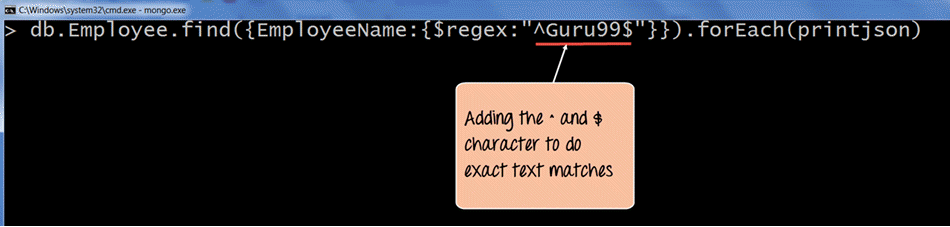
db.Employee.find({EmployeeName : {$regex: "^Guru99$"}}).forEach(printjson)
Code Explicaţie:
- Aici, în criteriile de căutare, folosim caracterele ^ și $. ^ este folosit pentru a ne asigura că șirul începe cu un anumit caracter, iar $ este folosit pentru a ne asigura că șirul se termină cu un anumit caracter. Așadar, atunci când codul se execută, va prelua doar șirul cu numele „Guru99. "
- Printjson este folosit pentru a imprima fiecare document care este returnat de interogare într-un mod mai bun.
Dacă comanda este executată cu succes, va fi afișată următoarea ieșire:
ieșire:
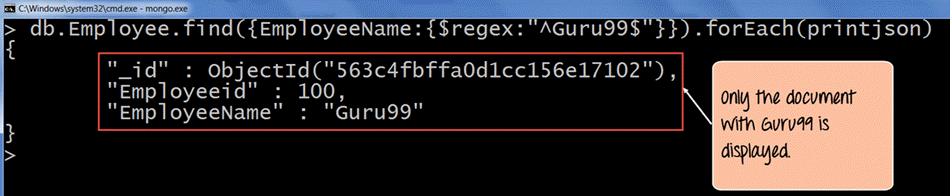
În rezultat, este clar vizibil șirul „GuruSe preiau 99”.
Potrivirea modelului cu $opțiuni
Când se utilizează operatorul $regex, se pot oferi și opțiuni suplimentare utilizând $opțiuni cuvânt cheie. De exemplu, să presupunem că doriți să găsiți toate documentele care au avut „Gu” în numele angajatului lor, indiferent dacă au fost sensibile la majuscule sau minuscule. Dacă se dorește un astfel de rezultat, atunci trebuie să folosim $opțiuni cu parametrul de insensibilitate la majuscule/minuscule.
Următorul exemplu arată cum se poate face acest lucru.
Să presupunem că avem aceeași colecție de angajați care are numele de câmp „Employeeid” și „EmployeeName”.
Să presupunem, de asemenea, că avem următoarele documente în colecția noastră.
| Card de identitate al angajatului | numele angajatului |
|---|---|
| 22 | NewMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU99 |
Acum, dacă rulăm aceeași interogare ca în subiectul precedent, nu vom vedea niciodată documentul cu „GURU99” în rezultat. Pentru a ne asigura că acesta apare în setul de rezultate, trebuie să adăugăm parametrul „i” din $options.
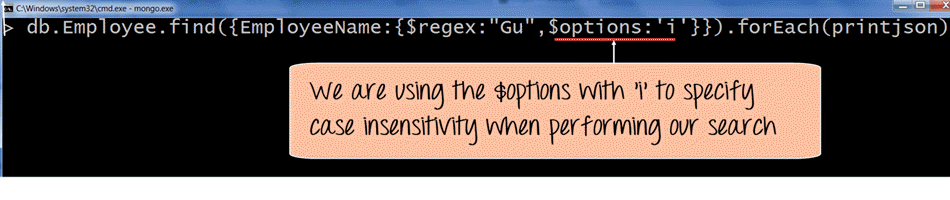
db.Employee.find({EmployeeName:{$regex: "Gu",$options:'i'}}).forEach(printjson)
Code Explicaţie:
- Opțiunile $ cu parametrul 'i' (care înseamnă insensibilitate la majuscule/minuscule) specifică faptul că dorim să efectuăm căutarea indiferent dacă găsim literele 'Gu' cu majuscule sau minuscule.
Dacă comanda este executată cu succes, va fi afișată următoarea ieșire:
ieșire:
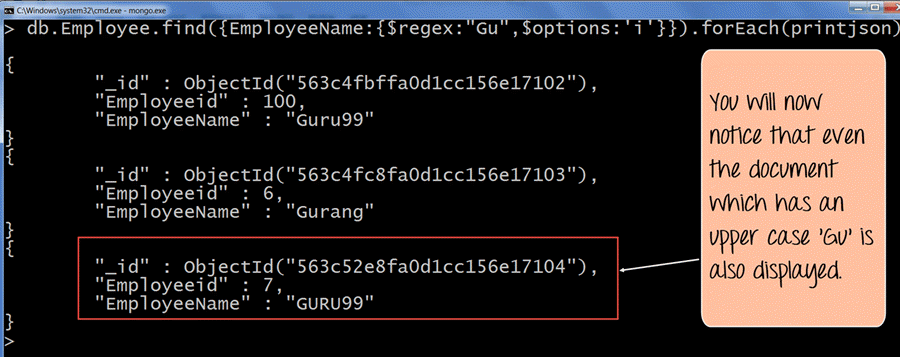
- Rezultatul arată clar că, deși un document are majuscula „Gu”, documentul este totuși afișat în setul de rezultate.
Potrivirea modelului fără operatorul regex
Se poate face și potrivirea de șabloane fără operatorul $regex. Următorul exemplu arată cum se poate face acest lucru.
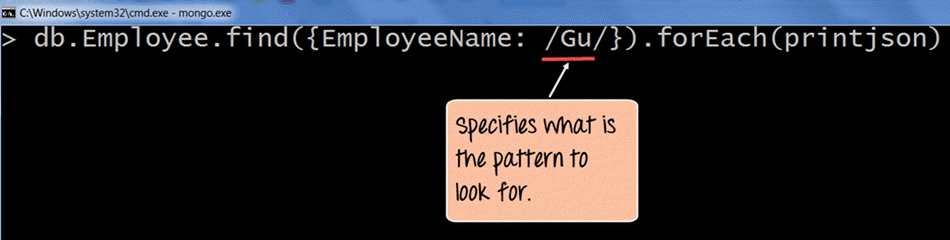
db.Employee.find({EmployeeName: /Gu/}).forEach(printjson)
Code Explicaţie:
- Delimitatorii „//” au, practic, scopul de a specifica criteriile de căutare în cadrul acestor delimitatori. Prin urmare, specificăm /Gu/ pentru a găsi din nou acele documente care au „Gu” în NumeleAngajatului.
Dacă comanda este executată cu succes, va fi afișată următoarea ieșire:
ieșire:
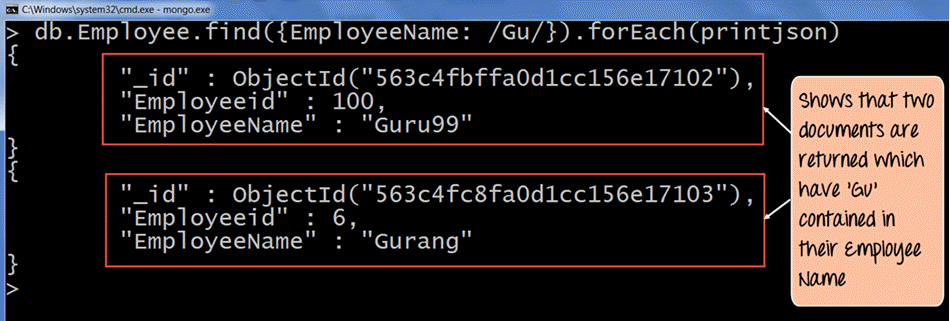
Rezultatul arată în mod clar că acele documente în care numele angajatului conține caracterele „Gu” sunt returnate.
Preluarea ultimelor „n” documente dintr-o colecție
Există diferite moduri de a obține ultimele n documente dintr-o colecție.
Să analizăm una dintre modalități prin următorii pași.
Următorul exemplu arată cum se poate face acest lucru.
Să presupunem că avem aceeași colecție de angajați care are numele de câmp „Employeeid” și „EmployeeName”.
Să presupunem, de asemenea, că avem următoarele documente în colecția noastră:
| Card de identitate al angajatului | numele angajatului |
|---|---|
| 22 | NewMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU99 |
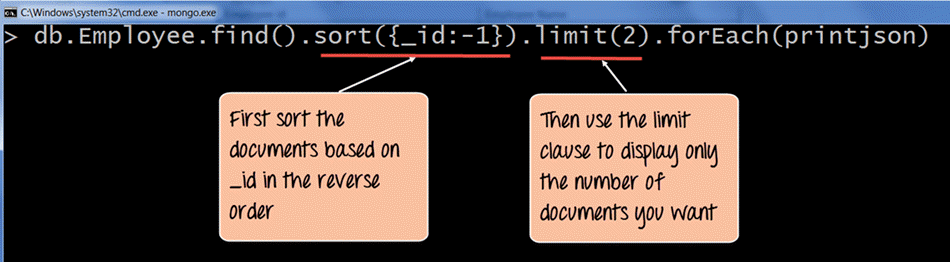
db.Employee.find().sort({_id:-1}).limit(2).forEach(printjson)
Code Explicaţie:
- Când interogați documente, utilizați funcția de sortare pentru a sorta înregistrările în ordine inversă pe baza valorii câmpului _id din colecție. Valoarea -1 indică practic sortarea documentelor în ordine inversă sau descrescătoare, astfel încât ultimul document să devină primul document afișat.
- Apoi, folosiți clauza limit pentru a afișa doar numărul de înregistrări dorite. Aici am setat clauza limit (2), astfel încât va prelua ultimele două documente.
Dacă comanda este executată cu succes, va fi afișată următoarea ieșire:
ieșire:
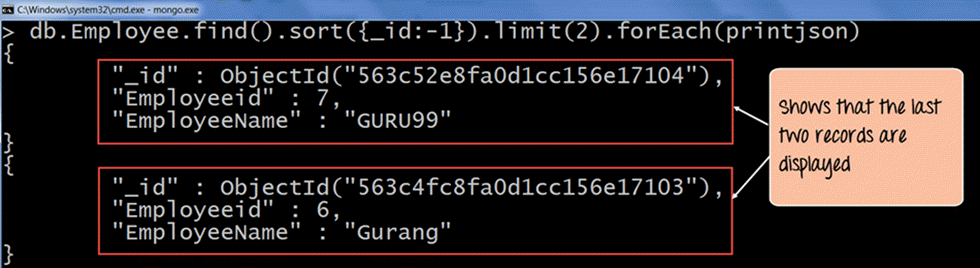
Rezultatul arată clar că ultimele două documente din colecție sunt afișate. Prin urmare, am arătat clar că pentru a prelua ultimele „n” documente din colecție, putem mai întâi să sortăm documentele în ordine descrescătoare și apoi să folosim clauza limită pentru a returna numărul „n” de documente necesare.
notițe: Dacă căutarea este efectuată pe un șir care este mai mare decât să zicem 38,000 de caractere, nu va afișa rezultatele corecte.
