
Tutorial Hadoop Pig: Ce este Apache Pig? Architectură, Exemplu
 Prafulla Ranadive
⚡ Rezumat inteligent
Apache Pig este o platformă de nivel înalt pentru analiza seturilor mari de date pe Hadoop, care combină limbajul de flux de date Pig Latin cu un runtime care compilează fiecare script în MapReduce, Tez sau... Spark locuri de muncă automat.
Acest tutorial începe cu ideea din spatele Apache Pig, apoi prezintă instalarea acestuia și rularea completă a unui Pig în alfabet latin, de la început până la sfârșit.
Ce este Apache Pig?
Porcul este un nivel înalt limbaj de programare util pentru analizarea seturilor mari de date. Pig a fost rezultatul eforturilor de dezvoltare de la Yahoo!
Într-un framework MapReduce, programele trebuie traduse într-o serie de etape Map și Reduce. Cu toate acestea, acesta nu este un model de programare cu care analiștii de date sunt familiarizați. Așadar, pentru a acoperi această lacună, un model abstracțiune numită Pig a fost construită deasupra Hadoop.
Apache Pig permite oamenilor să se concentreze mai mult pe analizarea seturilor de date în masă și să petreacă mai puțin timp scriind programe MapReduce. Similar porcilor, care mănâncă orice, limbajul de programare Apache Pig este conceput să lucreze cu orice tip de date. De aceea, numele, Pig! Mascota proiectului de mai jos subliniază același lucru.

Proiectul este încă activ. Apache Pig 0.18.0 a fost lansat pe 15 septembrie 2025 și adaugă suport pentru Hadoop 3, Tez 0.10, Hive 3, Spark 3, HBase 2 și Python 3, conform Pagina de lansări Apache PigGhidul de mai jos a fost scris inițial pentru linia mult mai veche 0.12.1, așa că câțiva pași au o notă în care o versiune curentă se comportă diferit.
Porc Architectură
Arhitectura Pig este formată din două componente:
- Pasareasca, care este o limbă
- Un mediu de rulare, pentru rularea programelor Pig Latin.
Un program Pig Latin constă dintr-o serie de operații sau transformări care sunt aplicate datelor de intrare pentru a produce ieșire. Aceste operații descriu un flux de date care este tradus într-o reprezentare executabilă de către mediul de execuție Hadoop Pig. Mai jos, rezultatele acestor transformări sunt o serie de MapReduce locuri de muncă de care un programator nu este conștient. Așadar, într-un fel, Pig în Hadoop permite programatorului să se concentreze pe date, mai degrabă decât pe natura execuției.
Pig Latin este un limbaj relativ rigid care folosește cuvinte cheie familiare din procesarea datelor, de exemplu, Join, Group și Filter. Diagrama de mai jos traceste un script din shell-ul Grunt prin parser, optimizator și compilator în drumul său către motorul de execuție.

Moduri de execuție
Pig în Hadoop are două moduri de execuție, iar tutorialul de instalare de mai jos le folosește pe ambele:
- Mod local: În acest mod, limbajul Hadoop Pig rulează într-un singur FMV și utilizează sistemul de fișiere local. Acest mod este potrivit doar pentru analiza seturilor de date mici folosind Pig în Hadoop.
- Mod MapReduce: În acest mod, interogările scrise în limbajul Pig Latin sunt traduse în joburi MapReduce și sunt rulate pe un cluster Hadoop (clusterul poate fi pseudo-distribuit sau complet distribuit). Modul MapReduce cu un cluster complet distribuit este util pentru rularea Pig pe seturi de date mari.
Acelea două sunt perechea clasică. Versiunile actuale expun de fapt șase tipuri de execuție, sau execttypes, fiecare selectat cu aceleași -x steag, așa cum este documentat în Ghid introductiv pentru Pig 0.18.0.
| Tip de execuție | Comandă | Unde se desfășoară lucrarea |
|---|---|---|
| Local | porc -x local | O singură JVM împotriva sistemului de fișiere local |
| Tez local | pig -x tez_local | O singură JVM folosind runtime-ul Tez (experimental) |
| Spark local | pig -x spark_local | O singură JVM care utilizează Spark timp de execuție (experimental) |
| MapReduce | porc sau porc -x mapreduce | Un cluster Hadoop cu HDFS; aceasta este setarea implicită |
| Tez | porc -x tez | Un cluster Hadoop care rulează motorul Tez |
| Spark | scânteie de porc -x | A Spark, Cluster YARN sau Mesos cu HDFS |
Tipuri de date latine pentru porci și Operatori
Înainte de a scrie un script, este util să știi ce poate stoca Pig și ce poate face cu acesta. Modelul de date este complet imbricat, ceea ce permite lui Pig să citească fișiere jurnal și alte intrări structurate slab pe care un tabel relațional le-ar respinge.
Pig Latin oferă două familii de tipuri:
- Tipuri scalare:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerșibigdecimalScriptul exemplu de mai târziu declară fiecare coloană cachararray. - Tipuri complexe: a tuplu este un set ordonat de câmpuri și se comportă ca un rând; a sac este o colecție neordonată de tupluri și se comportă ca un tabel; a Hartă este un set de perechi cheie-valoare a căror cheie trebuie să fie o
chararray.
Operatorii au un număr mic de locuri de muncă, iar câțiva dintre ei transportă aproape fiecare conductă:
| OperaTdR | Ce face |
|---|---|
| ÎNCĂRCARE / DEPOZITARE | Citește o relație din sistemul de fișiere și scrie rezultatul înapoi |
| FILTRU | Păstrați doar tuplurile care îndeplinesc o condiție |
| PENTRU FIECARE … GENERARE | Lucrați coloană cu coloană, construind câmpuri noi |
| GRUP / COGRUP | Grupează o relație sau două sau mai multe relații după o cheie |
| JOIN | Combinarea relațiilor cu o joncțiune internă sau externă |
| UNIUNE / DESPARTIRE | Îmbinarea relațiilor sau împărțirea uneia în mai multe |
| ORDINE DUPĂ / DISTINCT / LIMITĂ | Sortarea, deduplicarea și limitarea numărului de tupluri |
| A DESCARCA / A DESCRIE / A EXPLICA / A ILUSTRA | Inspectați rezultatele, schemele, planurile de execuție și rulările de eșantionare |
Cei patru operatori de inspecție au și ei scurtături Grunt, ceea ce economisește timp.ping în timpul depanării: \d pentru DEPOZITARE, \de pentru DESCRIERE, \e pentru EXPLICAȚI și \i pentru ILLUSTRATE.
Cerințe preliminare
Pig este un instrument client-side. Acesta analizează un script, planifică munca și trimite joburi, dar nu oferă spațiu de stocare sau un cluster propriu, așa că trebuie să existe mai întâi o instalare Hadoop funcțională. Lista de cerințe Apache este scurtă.
| Component | Cerinţă | De ce este nevoie |
|---|---|---|
| Hadoop | Hadoop 2.x sau 3.x, cu HADOOP_HOME exportat | Furnizează HDFS și motorul de execuție. Fără HADOOP_HOME, Pig 0.18.0 folosește un Hadoop 2.7.3 încorporat. |
| Java | Java 1.7 sau o versiune ulterioară, cu JAVA_HOME setat la rădăcina de instalare | Pig și daemonii Hadoop sunt Java programe |
| Python (Opțional) | Python 2.7 | Necesar doar pentru streaming Python funcții definite de utilizator |
| Furnică (opțional) | Furnica 1.8 | Necesar doar la construirea sau recompilarea Pig din sursă |
Două aspecte practice se adaugă la această listă. În primul rând, rulați totul ca utilizator Linux care are deja un director principal în HDFS și permisiunea de a scrie în acesta; acest tutorial folosește hduser, contul creat în timpul configurării Hadoop. În al doilea rând, porniți clusterul înainte de a lansa Pig în modul MapReduce, deoarece Pig eșuează imediat dacă NameNode și ResourceManager nu sunt disponibile. Dacă Hadoop nu este încă instalat, continuați cu cum se instalează Hadoop mai întâi.
Cum să descărcați și să instalați Pig
Acum, în acest tutorial Apache Pig, vom învăța cum să descărcați și să instalați Pig:
Înainte de a începe procesul propriu-zis, asigurați-vă că aveți Hadoop instalat. Schimbați numele utilizatorului în „hduser” (ID-ul folosit la configurarea Hadoop; puteți comuta la ID-ul de utilizator folosit în timpul propriei configurări Hadoop).

Pas 1) Descărcați cea mai recentă versiune stabilă de Pig Hadoop de pe oricare dintre site-urile mirror disponibile la
https://pig.apache.org/releases.html
Selectați fișierul tar.gz (și nu src.tar.gz) pentru descărcare, așa cum se arată mai jos.

Pas 2) După finalizarea descărcării, navigați la directorul care conține fișierul tar descărcat și mutați fișierul tar în locația unde doriți să configurați Pig Hadoop. În acest caz, vom muta fișierul în /usr/local.

Mutați-vă în directorul care va conține fișierele Pig Hadoop.
cd /usr/local
Extracconținutul fișierului tar după cum urmează.
sudo tar -xvf pig-0.12.1.tar.gz

Pas 3) Modificați ~/.bashrc pentru a adăuga variabile de mediu legate de Pig.
Deschideți fișierul ~/.bashrc în orice editor de text la alegere și faceți modificările de mai jos.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

Pas 4) Acum, configurați această configurație de mediu folosind comanda de mai jos.
. ~/.bashrc

Pas 5) Trebuie să recompilăm Pig pentru a oferi suport pentru Hadoop 2.2.0.
Iată pașii pentru a face acest lucru.
Accesați directorul principal Pig.
cd $PIG_HOME
Instalați Ant.
sudo apt-get install ant

Notă: Descărcarea va începe și va consuma timp în funcție de viteza conexiunii la internet.
Recompilează Pig.
sudo ant clean jar-all -Dhadoopversion=23

Rețineți că în acest proces de recompilare sunt descărcate mai multe componente, așadar sistemul trebuie să fie conectat la internet.
De asemenea, în cazul în care acest proces se blochează undeva și nu vedeți nicio mișcare în linia de comandă timp de mai mult de 20 de minute, apăsați Ctrl + c și rulați din nou aceeași comandă.
În cazul nostru, durează 20 de minute.

Această etapă de recompilare aparține erei 0.12.1, când versiunile JAR livrate au fost construite pentru Hadoop 1 și -Dhadoopversion=23 flag a schimbat versiunea Ant la linia Hadoop 0.23 și 2.x. Apache Pig 0.18.0 livrează binare care rulează deja pe Hadoop 2.7 și versiuni ulterioare, precum și pe Hadoop 3, așa că pe o versiune curentă puteți dezarhiva în mod normal arhiva tarball și să treceți direct la testul de mai jos.
Pas 6) Testați instalarea Pig folosind comanda
pig -help

Exemplu de Script Pig
Cu Pig instalat, restul acestui tutorial Apache Pig rulează un script complet. Vom folosi scripturi Pig pentru a afla numărul de produse vândute în fiecare țară.
Intrare: Setul nostru de date de intrare este un fișier CSV, VânzăriJan2009.csv.
Pas 1) Porniți Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Pas 2) Pig în Big Data preia un fișier din HDFS în modul MapReduce și stochează rezultatele înapoi în HDFS.
Copiați fișierul SalesJan2009.csv (stocat în sistemul de fișiere local la ~/input/SalesJan2009.csv) în directorul principal HDFS (Hadoop Distributed File System).
Aici, în acest exemplu Apache Pig, fișierul se află în folderul input. Dacă fișierul este stocat într-o altă locație, dați-i acel nume în schimb.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Verificați dacă fișierul a fost într-adevăr copiat sau nu.
$HADOOP_HOME/bin/hdfs dfs -ls /

Pas 3) Configurația porcului.
Mai întâi, navigați la $PIG_HOME/conf și păstrați o copie a fișierului de proprietăți original.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Deschideți fișierul pig.properties folosind un editor de text la alegere și specificați calea fișierului jurnal folosind pig.logfile.
sudo gedit pig.properties

Loggerul va folosi acest fișier pentru a înregistra erorile.
Pas 4) Rulați comanda „pig”, care va porni promptul de comandă Pig, un shell interactiv pentru interogările Pig.
pig

Pas 5) În linia de comandă Grunt pentru Pig, executați comenzile Pig de mai jos în ordine.
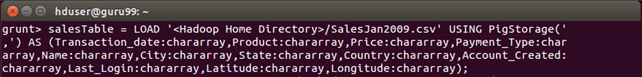
— A. Încărcați fișierul care conține date.
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Apăsați Enter după această comandă.
— B. Grupați datele după câmpul Țară.
GroupByCountry = GROUP salesTable BY Country;

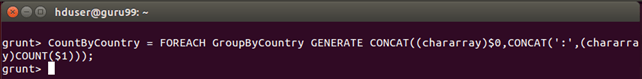
— C. Pentru fiecare tuplu din „GroupByCountry”, generați șirul rezultat de forma Numele țării: Nr. de produse vândute.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Apăsați Enter după această comandă.
— D. Stocați rezultatele fluxului de date în directorul „pig_output_sales” pe HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

Executarea acestei comenzi va dura ceva timp. După finalizare, ar trebui să vedeți următorul ecran.

Pas 6) Rezultatul poate fi văzut prin interfața de comandă ca
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

Rezultatele pot fi vizualizate și prin intermediul unei interfețe web.
Deschideți http://localhost:50070/ într-un browser web.
Portul 50070 este interfața web NameNode pe Hadoop 2. Hadoop 3 a mutat aceeași pagină pe portul 9870, așa că folosiți acea adresă dacă clusterul dvs. rulează Hadoop 3.

Acum selectați „Răsfoiți sistemul de fișiere” și navigați până la /user/hduser/pig_output_sales.

Deschideți part-r-00000 pentru a citi perechile țară și număr-produs produse de script.

Apache Pig vs. Hive vs. MapReduce
Pig este rareori evaluat de unul singur. Întrebarea obișnuită este dacă un loc de muncă își are locul în Pig, în Stup sau într-un program MapReduce scris de mână, deoarece toate trei ajung ca joburi pe același cluster.
| Aspect | Reducerea Hărții (Java) | Porc Apache | Apache Hive |
|---|---|---|---|
| interfaţă | Java API | Pig Latin, un limbaj de scripting pentru fluxuri de date | HiveQL, un dialect SQL |
| Nivelul abdomenuluitracTION | Scăzut | Mediu | Înalt |
| Utilizator tipic | Java dezvoltator | Inginer sau cercetător de date | Analist familiarizat cu SQL |
| Datele care se potrivesc | Orice, manipulat manual | Structurat și semi-structurat; schema este opțională la momentul încărcării | Tabele structurate înregistrate într-un metastore |
| Code volum | Majoritatea liniilor | Mai puține linii | Cele mai puține linii pentru o interogare |
| Rulează ca | O lucrare MapReduce | Compilează în MapReduce, Tez sau Spark de locuri de muncă | Compilează în MapReduce, Tez sau Spark de locuri de muncă |
| Cel mai bun la | Control deplin și logică personalizată | Conducte ETL cu mai mulți pași | Interogare și raportare ad-hoc |
În practică, divizarea este simplă. Apelați la Hive când datele arată deja ca un tabel, iar întrebarea arată ca SQL. Apelați la Pig când datele de intrare sunt dezordonate, când canalul este un lanț de transformări în loc de o singură interogare sau când același script trebuie să se ramifice și să se reunească. Apelați la MapReduce doar când niciuna dintre absențe nu...tracțiunea poate exprima logica, deoarece numărul de linii crește rapid.
Porcul stă confortabil, de asemenea, lângă restul ecosistemului. Sqoop și Flume aterizează datele brute, Pig sau Hive le modelează și un planificator precum Apache Oozie înlănțuie pașii într-o conductă repetabilă. Pentru o imagine mai amplă a locului în care se încadrează aceste instrumente, consultați ghidul pentru Datele mari și rezumatul instrumente de date mari; pentru o alternativă ETL comercială la scripturile scrise de mână, vezi Talend.
