
Exemplu Hadoop MapReduce: Primul Java Program cu Code
 Prafulla Ranadive
⚡ Rezumat inteligent
Programele Hadoop MapReduce sunt scrise în trei Java clase, un mapper, un reducer și un driver, care sunt compilate, împachetate într-un fișier jar și trimise clusterului pentru a număra vânzările pe țară.
În acest tutorial, veți învăța să utilizați Hadoop cu exemple MapReduce. Datele de intrare utilizate sunt VânzăriJan2009.csvConține informații legate de vânzări, cum ar fi numele produsului, prețul, metoda de plată, orașul și țara clientului. Scopul este de a afla numărul de produse vândute în fiecare țară.
Primul program Hadoop MapReduce
Acum în asta Tutorial MapReduce, vom crea primul nostru Java Programul MapReduce:
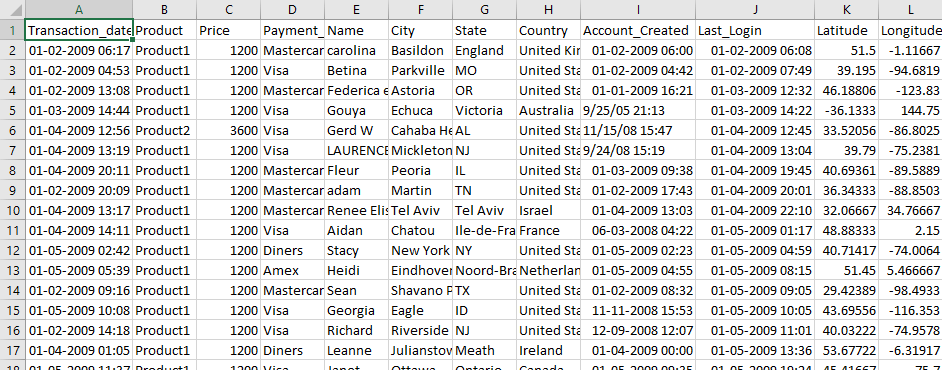
Captura de ecran de mai jos prezintă datele brute SalesJan2009, unde fiecare linie reprezintă o tranzacție, iar țara se află în a opta coloană separată prin virgulă.
Asigurați-vă că aveți Hadoop instalat. Înainte de a începe procesul propriu-zis, schimbați numele utilizatorului în „hduser” (ID-ul folosit la configurarea Hadoop - puteți comuta la ID-ul de utilizator folosit în timpul propriei configurări Hadoop).
su - hduser_
Solicitarea se schimbă în contul hduser, așa cum se arată mai jos.

Pasul 1) Creați directorul proiectului și fișierele sursă
Creați un director nou cu numele MapReduceTutorial, așa cum se arată în exemplul MapReduce de mai jos.
sudo mkdir MapReduceTutorial

Acordați permisiuni
sudo chmod -R 777 MapReduceTutorial

Creați cele trei Java fișierele sursă de mai jos, în MapReduceTutorial. Rețineți că toate trei folosesc versiunea mai veche org.apache.hadoop.mapred API, care este încă inclus în Hadoop 3.x.
SalesMapper.java
package SalesCountry;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesMapper extends MapReduceBase implements Mapper <LongWritable, Text, Text, IntWritable> {
	private final static IntWritable one = new IntWritable(1);

	public void map(LongWritable key, Text value, OutputCollector <Text, IntWritable> output, Reporter reporter) throws IOException {

		String valueString = value.toString();
		String[] SingleCountryData = valueString.split(",");
		output.collect(new Text(SingleCountryData[7]), one);
	}
}
SalesCountryReducer.java
package SalesCountry;

import java.io.IOException;
import java.util.*;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {

	public void reduce(Text t_key, Iterator<IntWritable> values, OutputCollector<Text,IntWritable> output, Reporter reporter) throws IOException {
		Text key = t_key;
		int frequencyForCountry = 0;
		while (values.hasNext()) {
			// replace type of value with the actual type of our value
			IntWritable value = (IntWritable) values.next();
			frequencyForCountry += value.get();

		}
		output.collect(key, new IntWritable(frequencyForCountry));
	}
}
SalesCountryDriver.java
package SalesCountry;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.*;
import org.apache.hadoop.mapred.*;

public class SalesCountryDriver {
    public static void main(String[] args) {
        JobClient my_client = new JobClient();
        // Create a configuration object for the job
        JobConf job_conf = new JobConf(SalesCountryDriver.class);

        // Set a name of the Job
        job_conf.setJobName("SalePerCountry");

        // Specify data type of output key and value
        job_conf.setOutputKeyClass(Text.class);
        job_conf.setOutputValueClass(IntWritable.class);

        // Specify names of Mapper and Reducer Class
        job_conf.setMapperClass(SalesCountry.SalesMapper.class);
        job_conf.setReducerClass(SalesCountry.SalesCountryReducer.class);

        // Specify formats of the data type of Input and output
        job_conf.setInputFormat(TextInputFormat.class);
        job_conf.setOutputFormat(TextOutputFormat.class);

        // Set input and output directories using command line arguments,
        //arg[0] = name of input directory on HDFS, and arg[1] =  name of output directory to be created to store the output file.

        FileInputFormat.setInputPaths(job_conf, new Path(args[0]));
        FileOutputFormat.setOutputPath(job_conf, new Path(args[1]));

        my_client.setConf(job_conf);
        try {
            // Run the job
            JobClient.runJob(job_conf);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
Arhiva se extinde în aceleași trei fișiere sursă, așa cum se arată aici.
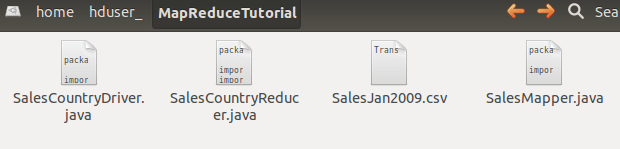
Verificați permisiunile pentru toate aceste fișiere

Dacă lipsesc permisiunile de „citire”, atunci acordați-le:

Pasul 2) Exportați calea de clasă Hadoop
Exportați calea de clasă așa cum se arată în exemplul Hadoop de mai jos.
export CLASSPATH="$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-common-2.2.0.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.2.0.jar:~/MapReduceTutorial/SalesCountry/*:$HADOOP_HOME/lib/*"
Calea de clasă exportată este readusă la prompt.

Pasul 3) Compilați Java fișiere
Compilați Java fișiere (aceste fișiere sunt prezente în directorul Final-MapReduceHandsOn). Fișierele lor de clasă vor fi plasate în directorul pachetului.
javac -d . SalesMapper.java SalesCountryReducer.java SalesCountryDriver.java
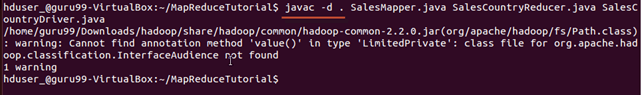
Acest avertisment poate fi ignorat în siguranță — raportează doar că API-ul mapred este depreciat.
Această compilare va crea un director în directorul curent numit cu numele pachetului specificat în Java fișierul sursă (de exemplu, SalesCountry în cazul nostru) și puneți toate fișierele de clasă compilate în el.

Pasul 4) Creați fișierul manifest
Creați un fișier nou Manifest.txt
sudo gedit Manifest.txt
Adăugați următoarea linie la aceasta:
Main-Class: SalesCountry.SalesCountryDriver

SalesCountry.SalesCountryDriver este numele clasei principale. Rețineți că trebuie să apăsați tasta Enter la sfârșitul acestei linii.
Pasul 5) Împachetați clasele într-un borcan
Creați un fișier Jar
jar cfm ProductSalePerCountry.jar Manifest.txt SalesCountry/*.class

Verificați dacă fișierul jar este creat

Pasul 6) Porniți Hadoop
Porniți Hadoop
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Pasul 7) Copiați fișierul de intrare în HDFS
Copiați fișierul SalesJan2009.csv în ~/inputMapReduce
Acum folosiți comanda de mai jos pentru a copia ~/inputMapReduce în HDFS.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/inputMapReduce /
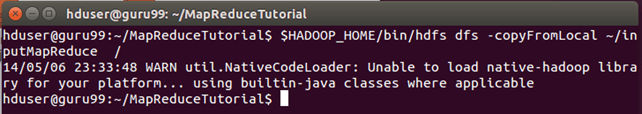
Putem ignora în siguranță acest avertisment.
Verificați dacă un fișier este copiat sau nu.
$HADOOP_HOME/bin/hdfs dfs -ls /inputMapReduce

Pasul 8) Executați jobul MapReduce
Rulați jobul MapReduce
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales

Aceasta va crea un director de ieșire numit mapreduce_output_sales on HDFS. Conținutul acestui director va fi un fișier care conține vânzările de produse pe țară.
Pasul 9) Citiți rezultatele
Rezultatul poate fi văzut prin interfața de comandă ca fiind,
$HADOOP_HOME/bin/hdfs dfs -cat /mapreduce_output_sales/part-00000
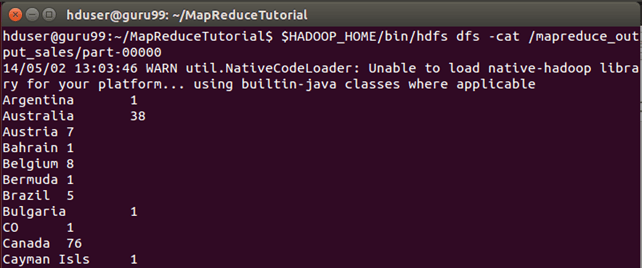
Rezultatele pot fi văzute și printr-o interfață web ca-
Operatii Deschise http://localhost:50070/ într-un browser web. Pe Hadoop 3.x, interfața web NameNode a fost mutată în port 9870, deci folosește http://localhost:9870/ acolo în schimb.

Acum selectați „Răsfoiți sistemul de fișiere” și navigați la /mapreduce_output_sales

Deschideți piesa-r-00000

Explicația clasei SalesMapper
Având în vedere că jobul se desfășoară de la un capăt la altul, următoarele trei secțiuni prezintă ce face de fapt fiecare clasă.
În această secțiune, vom înțelege implementarea clasei SalesMapper.
1. Începem prin a specifica un nume de pachet pentru clasa noastră. SalesCountry este numele pachetului nostru. Rețineți că rezultatul compilării, SalesMapper.class, va intra într-un director numit cu acest nume de pachet: SalesCountry.
După aceasta, importăm pachete de bibliotecă.
Mai jos este prezentată o implementare a clasei SalesMapper -

Eşantion Code Explicaţie:
1. Definiția clasei SalesMapper-
public class SalesMapper extends MapReduceBase implements Mapper<LongWritable, Text, Text, IntWritable> {
Fiecare clasă mapper trebuie să fie extinsă din clasa MapReduceBase și trebuie să implementeze interfața Mapper.
2. Definirea funcției „hartă”-
public void map(LongWritable key,
         Text value,
OutputCollector<Text, IntWritable> output,
Reporter reporter) throws IOException
Partea principală a clasei Mapper este metoda „map()” care acceptă patru argumente.
La fiecare apel al metodei „map()”, se transmite o pereche cheie-valoare („key” și „value” în acest cod).
Metoda 'map()' începe prin divizarea textului de intrare primit ca argument. Aceasta împarte fiecare linie în câmpuri.
String valueString = value.toString();
String[] SingleCountryData = valueString.split(",");
Aici, se folosește „,” ca delimitator.
După aceasta, se formează o pereche folosind o înregistrare la al 7-lea index al matricei „SingleCountryData” și o valoare „1”.
output.collect(new Text(SingleCountryData[7]), one);
Alegem înregistrarea la al 7-lea index deoarece avem nevoie de date despre țară, iar acestea se află la al 7-lea index din matricea „SingleCountryData”.
Vă rugăm să rețineți că datele noastre de intrare sunt în formatul următor (unde Țara se află la al 7-lea indice, cu 0 ca indice de pornire) -
Transaction_date,Product,Price,Payment_Type,Name,City,State,Country,Account_Created,Last_Login,Latitude,Longitude
O ieșire a funcției mapper este din nou o pereche cheie-valoare emisă folosind metoda „collect()” a funcției „OutputCollector”.
Explicația clasei SalesCountryReducer
În această secțiune, vom înțelege implementarea clasei SalesCountryReducer.
1. Începem prin a specifica numele pachetului pentru clasa noastră. SalesCountry este numele pachetului nostru. Rețineți că rezultatul compilării, SalesCountryReducer.class, va intra într-un director numit cu acest nume de pachet: SalesCountry.
După aceasta, importăm pachete de bibliotecă.
Instantaneul de mai jos prezintă o implementare a clasei SalesCountryReducer-
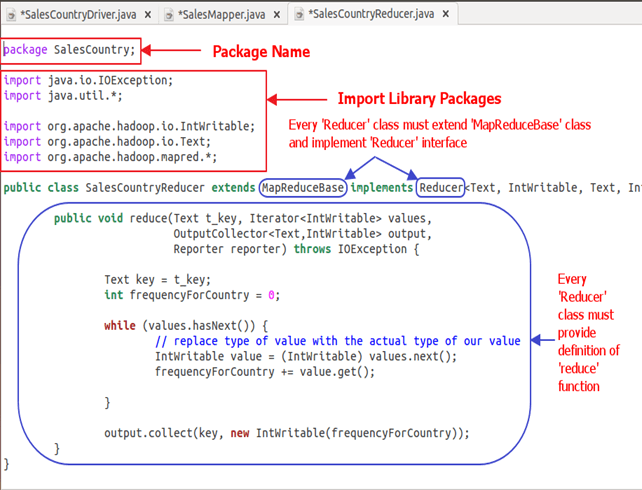
Code Explicaţie:
1. Definiția clasei SalesCountryReducer-
public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {
Aici, primele două tipuri de date, „Text” și „IntWritable”, reprezintă tipul de date al cheii-valoare de intrare a reductorului.
Rezultatul mapperului este sub forma , Această ieșire a mapper-ului devine intrare pentru reducer. Așadar, pentru a se alinia cu tipul său de date, se folosesc aici tipuri de date Text și IntWritable.
Ultimele două tipuri de date, „Text” și „IntWritable”, sunt tipurile de date de ieșire generate de reductor sub forma unei perechi cheie-valoare.
Fiecare clasă Reducer trebuie să fie extinsă din clasa MapReduceBase și trebuie să implementeze interfața Reducer.
2. Definirea funcției „reduce”-
public void reduce( Text t_key,
             Iterator<IntWritable> values,
             OutputCollector<Text,IntWritable> output,
             Reporter reporter) throws IOException {
O intrare pentru metoda reduce() este o cheie cu o listă de valori multiple.
De exemplu, în cazul nostru, va fi...
, , , , , .
Acest lucru este dat reductorului ca
Deci, pentru a accepta argumente de această formă, se utilizează primele două tipuri de date, și anume Text și Iterator. Textul este un tip de date cheie și iterator. este un tip de date pentru o listă de valori pentru cheia respectivă.
Următorul argument este de tip OutputCollector care colectează ieșirea fazei reducătoare.
Metoda reduce() începe prin copierea valorii cheii și inițializarea numărului de frecvență la 0.
Text key = t_key;int frequencyForCountry = 0;
Apoi, folosind bucla „while”, iterăm prin lista de valori asociate cheii și calculăm frecvența finală prin însumarea tuturor valorilor.
 while (values.hasNext()) {
            // replace type of value with the actual type of our value
            IntWritable value = (IntWritable) values.next();
            frequencyForCountry += value.get();

        }
Acum, trimitem rezultatul către colectorul de ieșire sub forma unei chei și a numărului de frecvență obținut.
Codul de mai jos face asta -
output.collect(key, new IntWritable(frequencyForCountry));
Explicația clasei SalesCountryDriver
În această secțiune, vom înțelege implementarea clasei SalesCountryDriver.
1. Începem prin a specifica un nume de pachet pentru clasa noastră. SalesCountry este numele pachetului nostru. Rețineți că rezultatul compilării, SalesCountryDriver.class, va intra într-un director numit cu acest nume de pachet: SalesCountry.
Aici este o linie care specifică numele pachetului urmat de cod pentru a importa pachete de bibliotecă.

2. Definiți o clasă de driver care va crea un nou loc de muncă client, un obiect de configurare și va face publicitate claselor Mapper și Reducer.
Clasa de șoferi este responsabilă pentru setarea jobului nostru MapReduce pentru a rula HadoopÎn această clasă, specificăm numele jobului, tipul de date de intrare/ieșire și numele claselor mapper și reducer.

3. În fragmentul de cod de mai jos, setăm directoarele de intrare și de ieșire care sunt folosite pentru a consuma setul de date de intrare și, respectiv, a produce ieșiri.
arg[0] și arg[1] sunt argumentele din linia de comandă transmise odată cu o comandă dată în MapReduce hands-on, adică,
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales
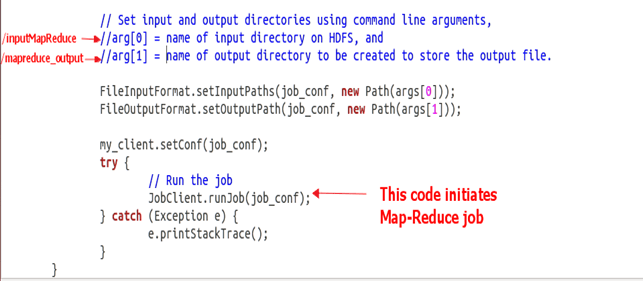
4. Declanșează-ne jobul
Codul de mai jos pornește execuția jobului MapReduce-
try {
    // Run the job
    JobClient.runJob(job_conf);
} catch (Exception e) {
    e.printStackTrace();
}
