
Tutorial Apache Flume: Ce este, ArchiExemplu de tectură și Hadoop
 Prafulla Ranadive
⚡ Rezumat inteligent
Apache Flume este un serviciu distribuit pentru colectarea, agregarea și mutarea unor volume mari de date de jurnal în HDFS, construit în jurul unor agenți care leagă împreună o sursă, un canal și un sink.
Ce este Apache Flume în Hadoop?
Apache Flume este un sistem fiabil și distribuit pentru colectarea, agregarea și mutarea unor cantități masive de date de jurnal. Are o arhitectură simplă, dar flexibilă, bazată pe fluxuri de date în flux continuu. Apache Flume este utilizat pentru a colecta datele de jurnal prezente în fișierele de jurnal de pe serverele web și a le agrega în... HDFS pentru analiză.
Flume în Hadoop acceptă mai multe surse, inclusiv:
- „tail” (care redirecționează datele dintr-un fișier local și le scrie în HDFS prin Flume, similar comenzii Unix „tail”)
- Jurnalele de sistem
- Apache log4j (ceea ce permite Java aplicații pentru a scrie evenimente în fișiere în HDFS prin Flume).
Versiunea actuală este Flume 1.11.0, publicat la 25 octombrie 2022 și disponibil la Pagina de descărcare Apache FlumeAceastă soluție a fost scrisă pentru versiunea 1.4.0, așa că mai mulți pași de mai jos conțin o notă privind situațiile în care o versiune curentă se comportă diferit.
uluc Architectură
Un agent Flume este un FMV proces cu trei componente – sursa Flume, canalul Flume și absorbantul Flume – prin care evenimentele se propagă după ce sunt inițiate la o sursă externă. Diagrama de mai jos arată cum se conectează acestea.
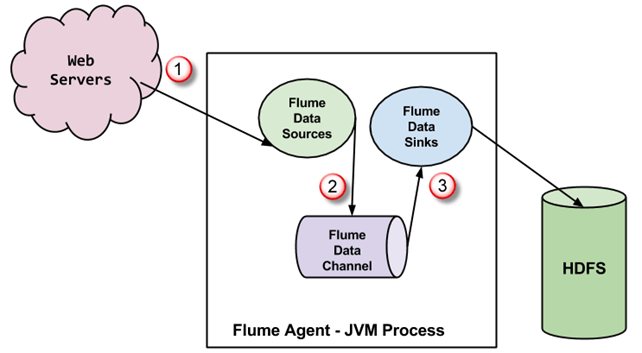
- Evenimentele generate de sursa externă (un server web) sunt consumate de sursa Flume. Sursa externă trimite evenimente către sursa Flume într-un format pe care sursa țintă îl recunoaște.
- Sursa Flume primește un eveniment și îl stochează într-unul sau mai multe canale. Canalul acționează ca un depozit care păstrează evenimentul până când este consumat de către sursa Flume. Acest canal poate utiliza un sistem de fișiere local pentru a stoca aceste evenimente.
- Sink-ul Flume elimină evenimentul dintr-un canal și îl stochează într-un depozit extern, cum ar fi HDFS. Pot exista mai mulți agenți Flume, caz în care sink-ul Flume redirecționează evenimentul către sursa Flume a următorului agent din flux.
Câteva caracteristici importante ale Flume
- Flume are un design flexibil bazat pe fluxuri de date în flux continuu. Este tolerant la erori și robust, cu multiple mecanisme de failover și recuperare. Flume oferă diferite niveluri de fiabilitate, inclusiv „livrare cu cel mai bun efort” și „livrare de la capăt la capăt”. Livrare cu cel mai bun efort nu tolerează nicio defecțiune a nodului Flume, în timp ce livrare cap la cap garantează livrarea chiar și în cazul defecțiunilor mai multor noduri.
- Flume transportă date între surse și receptori. Această colectare de date poate fi fie programată, fie determinată de evenimente. Flume are propriul motor de procesare a interogărilor, ceea ce facilitează transformarea fiecărui lot nou de date înainte de a fi mutat în receptorul dorit.
- Posibil Flume se scufundă include HDFS și HBaseFlume poate transporta, de asemenea, date despre evenimente, cum ar fi date despre traficul de rețea, date generate de site-urile de socializare și mesaje de e-mail.
Flume, biblioteca și configurarea codului sursă
Înainte de a începe procesul propriu-zis, asigurați-vă că aveți Hadoop instalat; dacă nu, parcurgeți cum se instalează Hadoop Mai întâi. Schimbați utilizatorul în „hduser” (ID-ul folosit la configurarea Hadoop; puteți comuta la ID-ul de utilizator folosit în timpul propriei configurații Hadoop).

Pas 1) Creați un director nou cu numele „FlumeTutorial”.
sudo mkdir FlumeTutorial
- Acordați permisiuni de citire, scriere și execuție.
sudo chmod -R 777 FlumeTutorial
- Copiați fișierele MyTwitterSource.java și MyTwitterSourceForFlume.java în acest director.
Descărcați fișierele de intrare de aici
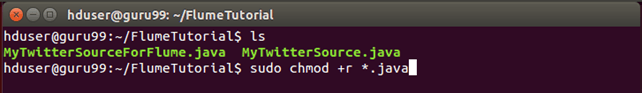
Verificați permisiunile tuturor acestor fișiere, așa cum este prezentat mai jos, și acordați permisiunea de „citire” dacă aceasta lipsește.
Pas 2) Descărcați „Apache Flume” de la https://flume.apache.org/download.html.
Apache Flume 1.4.0 a fost folosit în acest tutorial Flume.

Apoi, faceți clic pe o oglindă.

Pas 3) Copiați fișierul tar descărcat în directorul ales și ex.tract conținutul folosind următoarea comandă.
sudo tar -xvf apache-flume-1.4.0-bin.tar.gz

Aceasta creează un nou director numit apache-flume-1.4.0-bin și extracfișierele în el. Directorul respectiv este denumit în restul articolului.
Pas 4) Configurarea bibliotecii Flume. Copiați twitter4j-core-4.0.1.jar, flume-ng-configuration-1.4.0.jar, flume-ng-core-1.4.0.jar și flume-ng-sdk-1.4.0.jar în
/lib/
Este posibil ca oricare dintre fișierele JAR copiate sau toate acestea să aibă permisiunea de execuție setată, ceea ce poate cauza o problemă la compilarea codului, așa că revocați-o. În cazul meu, twitter4j-core-4.0.1.jar avea permisiunea de execuție. Am revocat-o după cum urmează.
sudo chmod -x twitter4j-core-4.0.1.jar

După aceasta, comanda de mai jos acordă permisiunea de „citire” asupra fișierului twitter4j-core-4.0.1.jar tuturor.
sudo chmod +rrr /usr/local/apache-flume-1.4.0-bin/lib/twitter4j-core-4.0.1.jar
Vă rog să rețineți că am descărcat twitter4j-core-4.0.1.jar de la Depozit Mavenși toate fișierele JAR Flume, adică flume-ng-*-1.4.0.jar, de la artefactele org.apache.flume.
Încărcați date de pe Twitter folosind Flume
Pas 1) Accesați directorul care conține fișierele cu codul sursă.
Pas 2) Setați CLASSPATH să conțină /lib/* și ~/FlumeTutorial/flume/mytwittersource/*.
export CLASSPATH="/usr/local/apache-flume-1.4.0-bin/lib/*:~/FlumeTutorial/flume/mytwittersource/*"

Pas 3) Compilați codul sursă folosind comanda de mai jos.
javac -d . MyTwitterSourceForFlume.java MyTwitterSource.java

Pas 4) Creați un fișier JAR. Mai întâi, creați un fișier Manifest.txt folosind un editor de text la alegere și adăugați linia de mai jos în acesta.
Main-Class: flume.mytwittersource.MyTwitterSourceForFlume
Aici, flume.mytwittersource.MyTwitterSourceForFlume este numele clasei principale. Rețineți că trebuie să apăsați tasta Enter la sfârșitul acestei linii, așa cum se arată mai jos.

Acum, creați fișierul JAR „MyTwitterSourceForFlume.jar” după cum urmează.
jar cfm MyTwitterSourceForFlume.jar Manifest.txt flume/mytwittersource/*.class

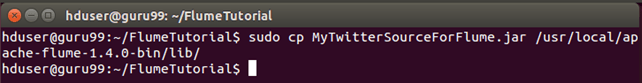
Pas 5) Copiați acest JAR în /lib/.
sudo cp MyTwitterSourceForFlume.jar <Flume Installation Directory>/lib/
Pas 6) Accesați directorul de configurare al Flume, /conf.
Dacă fișierul flume.conf nu există, copiați fișierul flume-conf.properties.template și redenumiți-l în flume.conf.
sudo cp flume-conf.properties.template flume.conf

Dacă fișierul flume-env.sh nu există, copiați fișierul flume-env.sh.template și redenumiți-l în flume-env.sh.
sudo cp flume-env.sh.template flume-env.sh

Crearea unei aplicații Twitter
Citește asta mai întâi. Streaming-ul v1.1 statuses/filter endpoint-ul necesar pentru twitter4j 4.0.1 a fost retras pe 9 martie 2023, iar fluxul filtrat API v2 care l-a înlocuit, acum la developer.x.com, se află în spatele unui nivel plătit. Tratați ecranele de mai jos ca un model de sursă personalizată, apoi direcționați același agent către un fișier, un executor sau o sursă Kafka.
Pas 1) Creați o aplicație Twitter conectându-vă la portalul pentru dezvoltatori.


Pas 2) Accesați „Aplicațiile mele” (această opțiune apare când faceți clic pe butonul „Ou” din colțul din dreapta sus).

Pas 3) Creați o aplicație nouă făcând clic pe „Creați aplicație nouă”.
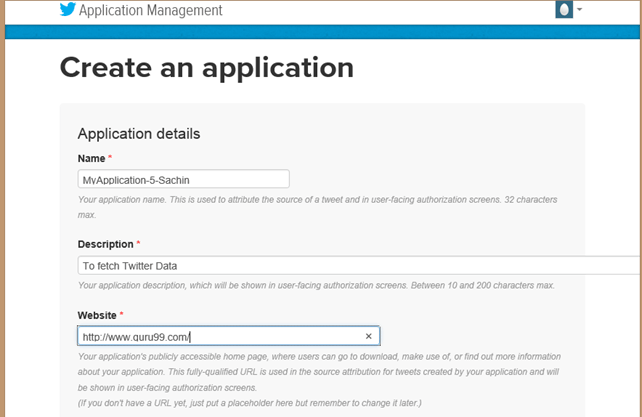
Pas 4) Completați detaliile aplicației specificând numele aplicației, o descriere și un site web. Puteți consulta notele de sub fiecare câmp de introducere a datelor.
Pas 5) Derulați pagina în jos, acceptați termenii bifând „Da, sunt de acord” și faceți clic pe butonul „Creați aplicația dvs. Twitter”.

Pas 6) În fereastra aplicației nou create, accesați fila „Chei API”, derulați în jos pe pagină și faceți clic pe butonul „Creează-mi tokenul de acces”.


Pas 7) Reincarca Pagina.
Pas 8) Faceți clic pe „Test OAuth”. Aceasta afișează setările „OAuth” ale aplicației.

Pas 9) Modificați fișierul „flume.conf” folosind aceste setări OAuth. Pașii pentru modificarea fișierului „flume.conf” sunt prezentați mai jos.

Trebuie să copiem cheia consumatorului, secretul consumatorului, tokenul de acces și secretul tokenului de acces pentru a actualiza „flume.conf”.
Notă: Aceste valori aparțin utilizatorului și, prin urmare, sunt confidențiale, așadar nu ar trebui partajate.
Modificați fișierul „flume.conf”.
Pas 1) Deschideți fișierul „flume.conf” în modul de scriere și setați valorile pentru parametrii de mai jos.
sudo gedit flume.conf
Copiați conținutul de mai jos.
MyTwitAgent.sources = Twitter
MyTwitAgent.channels = MemChannel
MyTwitAgent.sinks = HDFS
MyTwitAgent.sources.Twitter.type = flume.mytwittersource.MyTwitterSourceForFlume
MyTwitAgent.sources.Twitter.channels = MemChannel
MyTwitAgent.sources.Twitter.consumerKey = <Copy consumer key value from Twitter App>
MyTwitAgent.sources.Twitter.consumerSecret = <Copy consumer secret value from Twitter App>
MyTwitAgent.sources.Twitter.accessToken = <Copy access token value from Twitter App>
MyTwitAgent.sources.Twitter.accessTokenSecret = <Copy access token secret value from Twitter App>
MyTwitAgent.sources.Twitter.keywords = guru99
MyTwitAgent.sinks.HDFS.channel = MemChannel
MyTwitAgent.sinks.HDFS.type = hdfs
MyTwitAgent.sinks.HDFS.hdfs.path = hdfs://localhost:54310/user/hduser/flume/tweets/
MyTwitAgent.sinks.HDFS.hdfs.fileType = DataStream
MyTwitAgent.sinks.HDFS.hdfs.writeFormat = Text
MyTwitAgent.sinks.HDFS.hdfs.batchSize = 1000
MyTwitAgent.sinks.HDFS.hdfs.rollSize = 0
MyTwitAgent.sinks.HDFS.hdfs.rollCount = 10000
MyTwitAgent.channels.MemChannel.type = memory
MyTwitAgent.channels.MemChannel.capacity = 10000
MyTwitAgent.channels.MemChannel.transactionCapacity = 1000

Pas 2) De asemenea, setați TwitterAgent.sinks.HDFS.hdfs.path ca mai jos.
TwitterAgent.sinks.HDFS.hdfs.path = hdfs:// : / /flume/tweets/

A găsi , şi , consultați valoarea parametrului „fs.defaultFS” setat în $HADOOP_HOME/etc/hadoop/core-site.xml, prezentată mai jos.

Pas 3) Pentru a elimina datele în HDFS pe măsură ce apar, ștergeți intrarea de mai jos, dacă există.
TwitterAgent.sinks.HDFS.hdfs.rollInterval = 600
Exemplu: transmiterea în flux a datelor Twitter folosind Flume
Pas 1) Deschideți fișierul „flume-env.sh” în modul de scriere și setați valorile pentru parametrii de mai jos.
JAVA_HOME=<Installation directory of Java>
FLUME_CLASSPATH="<Flume Installation Directory>/lib/MyTwitterSourceForFlume.jar"

Pas 2) Porniți Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Pas 3) Două dintre fișierele JAR din arhiva tarball Flume nu sunt compatibile cu Hadoop 2.2.0, așa că în acest exemplu Apache Flume urmăm pașii de mai jos pentru a face Flume compatibil cu Hadoop 2.2.0. Această schimbare JAR este o remediere din era 1.4.0; Flume 1.11.0 include deja versiunile protobuf și Guava actuale, așa că o arhivă tarball modernă nu are nevoie în mod normal de niciuna dintre acestea.
a. Mutați protobuf-java-2.4.1.jar din ' /lib'. Accesați mai întâi directorul respectiv.
CD /lib
sudo mv protobuf-java-2.4.1.jar ~/

b. Găsiți fișierul JAR „guava” așa cum este indicat mai jos.
find . -name "guava*"

Mută guava-10.0.1.jar din ' /lib'.
sudo mv guava-10.0.1.jar ~/

c. Descărcați guava-17.0.jar de pe Depozit Maven, prezentat mai jos.

Acum, copiați acest fișier JAR descărcat în ' /lib'.
Pas 4) Mergi la /bin' și porniți Flume după cum urmează.
./flume-ng agent -n MyTwitAgent -c conf -f <Flume Installation Directory>/conf/flume.conf

Fereastra de comandă unde Flume preia tweet-uri arată astfel.

Din mesajul ferestrei de comandă putem vedea că ieșirea este scrisă în directorul /user/hduser/flume/tweets/. Acum, deschideți acest director folosind un browser web.
Pas 5) Pentru a vedea rezultatul încărcării datelor, deschideți http://localhost:50070/ într-un browser, răsfoiți sistemul de fișiere, apoi accesați directorul în care au fost încărcate datele, adică
/flume/tweets/
Portul 50070 este interfața web NameNode pe Hadoop 2; Hadoop 3 a mutat aceeași pagină pe portul 9870.

Flume este jumătate din ingestie: Sqoop importă tabele în loturi, Flume transmite evenimente în flux, apoi Porc or Stup formați fișierele și Oozie programează lanțul. Vezi și instrumente de analiză a datelor mari, Join-uri și contoare MapReduce și Talend.
