
Creați și plasați INDEX în Cassandra
 David Carter
⚡ Rezumat inteligent
Creați și plasați indexul în Cassandra permite filtrarea pe coloane care nu fac parte din cheia primară. Această pagină prezintă comenzile CREATE INDEX și DROP INDEX, regulile de denumire, tipurile de index disponibile și cazurile în care un index este răspunsul greșit.
Cassandra Creați index
Comanda „Creare index” creează un index pe coloana specificată de utilizator. Dacă datele există deja pentru coloana pe care doriți să o indexați, Cassandra creează indecși asupra datelor în timpul executării instrucțiunii „create index”.
- După crearea unui index, Cassandra indexează automat datele noi atunci când sunt introduse.
- Indexul nu poate fi creat pe cheia primară, deoarece o cheie primară este deja indexată.
- Indexurile pe coloanele colecției sunt acceptate, utilizând formularele KEYS, VALUES sau ENTRIES, în funcție de ceea ce trebuie căutat.
- Fără indexare pe coloană, Cassandra Nu se poate filtra acea coloană decât dacă este o cheie primară.
De aceea, pentru filtrarea coloanelor în Cassandra, trebuie creați indexuri.
Sintaxă
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
Exemplu
Iată instantaneul în care s-a încercat să filtreze coloana „dept” fără a crea indexul. Ca răspuns, eroarea a fost returnată.

Aici este instantaneul în care este creat indexul pe coloana dept.

CREATE INDEX DeptIndex ON University.Student (dept);
Iată instantaneul în care va fi filtrată cu succes coloana „dept”.

SELECT * FROM University.Student WHERE dept = 'CS';
Numele indexului este opțional. Omiterea lui permite Cassandra va genera unul automat, ceea ce contează atunci când indexul trebuie ulterior eliminat.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Indicele de picături
Comanda „Drop index” scade indexul specificat. Dacă numele indexului nu a fost dat în timpul creării indexului, atunci numele indexului este TableName_ColumnName_idx.
- Dacă indexul nu există, va returna o eroare, cu excepția cazului în care se folosește IF EXISTS, care va returna no-op.
- Trebuie să specificați numele spațiului cheie împreună cu numele indexului, altfel indexul va fi căutat în spațiul cheie curent.
Sintaxă
DROP INDEX IF EXISTS KeyspaceName.IndexName;
Exemplu
Iată instantaneul comenzii executate „Drop index” care scade indexul DeptIndex.
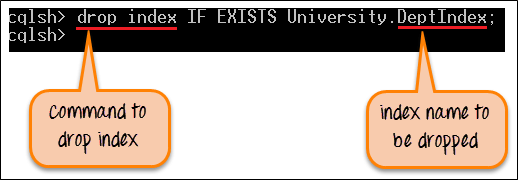
DROP INDEX IF EXISTS University.DeptIndex;
După executarea cu succes a comenzii, DeptIndex va fi eliminat din spațiul de taste. Acum datele nu pot fi filtrate de departamentul de coloană.
Pentru a confirma ce indexuri există înainte de eliminareping Unu, descrieți tabelul și citiți definițiile indexului din partea de jos a rezultatului.
DESCRIBE TABLE University.Student;
Tipuri de index în Cassandra
Comanda de mai sus creează un index secundar standard, dar există trei mecanisme distincte, care se comportă foarte diferit.
| Tip | Abordarea Noastră | Cel mai bun pentru |
|---|---|---|
| Index secundar | Fiecare nod indexează doar propriile date locale, așadar o interogare fără o cheie de partiție trebuie să contacteze fiecare nod. | Coloane cu cardinalitate moderată interogate alături de o cheie de partiție. |
| Indicele SASI | Un index atașat care permite potrivirea prefixelor și sufixelor LIKE, plus intervale numerice. | Modele de căutare text. Încă marcate ca experimentale, așa că testați înainte de utilizarea în producție. |
| Index atașat la stocare (SAI) | Introdus în Cassandra 5.0, partajând o structură de index pe coloane cu costuri suplimentare de scriere mai mici. | Înlocuitorul modern pentru ambele de mai sus pe Cassandra 5 clustere. |
Indexarea unei coloane de colecție utilizează un modificator care specifică ce parte trebuie indexată.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VALUES caută elementele unui set sau ale unei liste, KEYS caută chei de hartă, iar ENTRIES potrivește o pereche cheie-valoare. Indexarea colecțiilor este prezentată mai detaliat în Cassandra colecții tutorial.
Când nu se utilizează un index în Cassandra
Un index secundar este convenabil, dar nu este un index relațional, iar utilizarea unuia în locul greșit este o cauză frecventă a clusterelor lente. Patru situații necesită o abordare diferită.
- Cardinalitate foarte mare. Indexarea a ceva aproape unic, cum ar fi o adresă de e-mail, înseamnă că aproape fiecare partiție conține un rând potrivit, astfel încât interogarea se extinde pe întregul cluster pentru a returna o singură înregistrare.
- Cardinalitate foarte scăzută. Indexarea unui indicator cu două valori, cum ar fi activ sau inactiv, produce partiții de index enorme, iar citirea uneia returnează jumătate din tabel.
- Coloane actualizate frecvent. Fiecare modificare scrie o intrare de index și o piatră tombstone pentru cea veche, astfel încât acumularea de pietre tombstone degradează citirile în timp.
- Interogări fără cheie de partiție. Fără unul, coordonatorul trebuie să contacteze fiecare nod și să îmbine rezultatele, ceea ce nu se scalează pe măsură ce sunt adăugate noduri.
Alternativa durabilă este un al doilea tabel cu cheie conform coloanei care necesită căutare, scris în același timp cu primul. Aceasta respectă principiul „interogare pe primul loc” descris în Cassandra regulile modelului de dateși păstrează fiecare citire către o singură partiție pe un singur nod.
Ca regulă de lucru, un index se potrivește unei coloane cu cardinalitate moderată care este interogată împreună cu o cheie de partiție cunoscută. Orice element în afara acestei descrieri este mai bine deservit de un tabel special conceput.
