
Tutorial despre Rețele Neuronale Artificiale (ANN) cu TensorFlow
 Echipa editorială
⚡ Rezumat inteligent
Rețelele neuronale artificiale învață prin transmiterea de date de intrare prin straturi conectate, prin notarea rezultatului cu o funcție de pierdere și prin corectarea ponderilor cu un optimizator. Acest ghid complet construiește una în TensorFlow și clasifică cifrele MNIST.
Ce este rețeaua neuronală artificială?
An Rețea neuronală artificială (ANN) este un sistem informatic inspirat de rețelele neuronale biologice pentru crearea de creiere artificiale bazate pe o colecție de unități conectate numite neuroni artificiali. Este conceput pentru a analiza și procesa informații așa cum o fac oamenii. O rețea neuronală artificială are capacități de auto-învățare pentru a produce rezultate mai bune pe măsură ce sunt disponibile mai multe date.
Diagrama de mai jos tracEste vorba de o trecere completă printr-o astfel de rețea, de la intrarea brută la optimizatorul care corectează ponderile.

O rețea neuronală artificială (ANN) este compusă din patru obiecte principale:
- Straturi: Toată învățarea are loc în straturi. Există 3 straturi: 1) Intrare, 2) Ascuns și 3) Ieșire.
- Caracteristică și etichetă: Date de intrare în rețea (caracteristici) și date de ieșire din rețea (etichete)
- Funcția de pierdere: Metrica utilizată pentru estimarea performanței fazei de învățare
- Optimizator: Îmbunătățiți învățarea prin actualizarea cunoștințelor în rețea
O rețea neuronală preia datele de intrare și le transmite într-un ansamblu de straturi. Rețeaua își evaluează apoi performanța cu o funcție de pierdere. Funcția de pierdere oferă rețelei o idee despre calea pe care trebuie să o parcurgă înainte de a stăpâni cunoștințele. Rețeaua îmbunătățește aceste cunoștințe cu ajutorul unui optimizator.
Dacă aruncați o privire la figura de mai sus, veți înțelege mecanismul de bază.
Programul preia niște valori de intrare și le introduce în două straturi complet conectate. Imaginează-ți că ai o problemă de matematică. Primul lucru pe care îl faci este să citești capitolul corespunzător pentru a o rezolva. Apoi aplici noile cunoștințe la problemă. Există șanse mari să nu obții un scor foarte bun. La fel este și în cazul unei rețele: prima dată când vede datele și face o predicție, rezultatul nu se va potrivi perfect cu datele reale.
Pentru a-și îmbunătăți cunoștințele, rețeaua folosește un optimizator. În această analogie, un optimizator poate fi considerat ca recitind capitolul. Obții noi perspective citind din nou. În mod similar, rețeaua folosește optimizatorul, își actualizează cunoștințele și le testează pentru a verifica cât mai are de învățat. Programul repetă acest pas până când face cea mai mică eroare posibilă.
În analogia problemei de matematică, înseamnă că citești capitolul din manual de mai multe ori până când înțelegi pe deplin conținutul cursului. Chiar și după ce citești de mai multe ori, dacă continui să faci greșeli, înseamnă că ai atins capacitatea de cunoștințe a materialului curent. Trebuie să folosești un alt manual sau să testezi o altă metodă pentru a-ți îmbunătăți scorul. Pentru o rețea neuronală, este același proces. Dacă eroarea nu mai cade și curba pierderilor devine plată, arhitectura actuală nu mai poate învăța nimic altceva. Rețeaua trebuie să fie mai bine optimizată pentru a îmbunătăți cunoștințele.
Aceste patru obiecte se mapează direct pe componentele pe care le configurați atunci când proiectați o rețea.
Retea neurala Architectură
Arhitectura unei rețele neuronale artificiale este alcătuită din următoarele componente:
- Straturi
- Funcția de activare
- Funcția de pierdere
- Instrumentul de optimizare a
Straturi
Un strat este locul unde are loc toată învățarea. În interiorul unui strat se află un număr arbitrar de neuroni, fiecare având propria pondere. O rețea neuronală tipică este adesea procesată de straturi dens conectate (numite și straturi complet conectate). Aceasta înseamnă că toate intrările sunt conectate la ieșire.
O rețea neuronală tipică preia un vector de intrare și un scalar care conține etichetele. Cea mai simplă configurație este o clasificare binară cu doar două clase: 0 și 1.
Rețeaua preia o intrare, o trimite către toate nodurile conectate și calculează semnalul cu o funcție de activare. Diagrama numerotată de mai jos extinde un singur nod, astfel încât să puteți vedea separat suma ponderată și pasul de activare.

Figura de mai sus ilustrează această idee. Primul strat conține valorile de intrare. Al doilea strat, numit strat ascuns, primește datele de intrare ponderate de la stratul anterior.
- Primul nod reprezintă valorile de intrare.
- Neuronul este descompus în partea de intrare și funcția de activare. Partea stângă primește toate intrările de la stratul anterior. Partea dreaptă este suma intrărilor transmise unei funcții de activare.
- Valoarea de ieșire calculată din straturile ascunse și utilizată pentru a face o predicție. Pentru clasificare, este egală cu numărul de clase. Pentru regresie, se prezice o singură valoare.
Funcția de activare
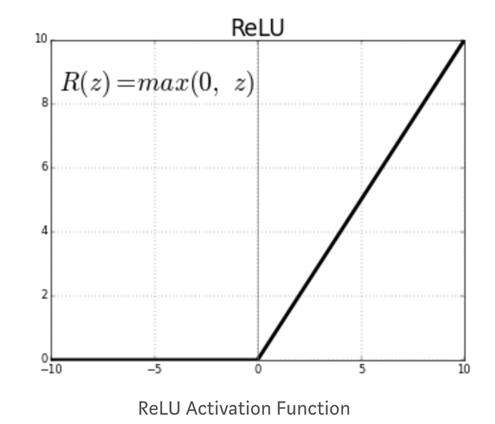
Funcția de activare a unui nod definește ieșirea dată unui set de intrări. Aveți nevoie de o funcție de activare pentru a permite rețelei să învețe modele neliniare. O funcție de activare comună este ReLU, Unitatea Liniară Rectificată. Funcția dă un zero pentru toate valorile negative.
Celelalte funcții de activare sunt:
- Linear pe bucăți
- sigmoid
- Tanh
- Leaky ReLU
Graficul de mai jos arată de ce ReLU este descris în acest fel: curba este plată la zero pentru fiecare intrare negativă și crește liniar ulterior.
Decizia critică de luat la construirea unei rețele neuronale este:
- Câte straturi din rețeaua neuronală
- Câte unități ascunse pentru fiecare strat
Rețelele neuronale cu multe straturi și unități ascunse pot învăța o reprezentare complexă a datelor, dar fac ca procesul de calcul al rețelei să fie foarte costisitor.
Funcția de pierdere
După ce ați definit straturile ascunse și funcția de activare, trebuie să specificați funcția de pierdere și optimizatorul.
Pentru clasificarea binară, este o practică obișnuită să se utilizeze o funcție de pierdere a entropiei încrucișate binare. În regresie liniara, folosești eroarea medie pătratică.
Funcția de pierdere este o măsură importantă pentru estimarea performanței optimizatorului. În timpul antrenamentului, această măsurătoare va fi redusă la minimum. Trebuie să selectați această cantitate cu atenție în funcție de tipul de problemă cu care vă confruntați.
Instrumentul de optimizare a
Funcția de pierdere este o măsură a performanței modelului. Optimizatorul va ajuta la îmbunătățirea ponderilor rețelei pentru a reduce pierderea. Există diferiți optimizatori disponibili, dar cel mai comun este Stochastic Gradient Descent.
Optimizatorii convenționali sunt:
- Momentum optimizare
- Gradient accelerat Nesterov
- AdaGrad
- optimizare Adam
ArchiTextura singură nu garantează un model utilizabil.
Limitările rețelei neuronale
Iată limitele unei rețele neuronale:
Suprapunere
O problemă frecventă a unei rețele neuronale complexe este dificultatea generalizării la date nevăzute. O rețea neuronală cu multe ponderi poate identifica foarte bine detalii specifice în setul de trenuri, dar acest lucru duce adesea la supraadaptare. Dacă datele sunt dezechilibrate în cadrul grupurilor (adică nu sunt disponibile suficiente date în unele grupuri), rețeaua va învăța foarte bine în timpul antrenamentului, dar nu va avea capacitatea de a generaliza astfel de modele la date nemaivăzute până acum.
Există un compromis în masina de învățare între optimizare și generalizare.
- Optimizarea unui model necesită găsirea celor mai buni parametri care minimizează pierderea setului de antrenament.
- Generalizarea, totuși, spune cum se comportă modelul pentru datele nevăzute.
Pentru a împiedica modelul să capteze detalii specifice sau tipare nedorite ale datelor de antrenament, puteți utiliza diferite tehnici. Cea mai bună metodă este să aveți un set de date echilibrat cu o cantitate suficientă de date. Arta reducerii supraadaptării se numește regularizare. Cele trei tehnici de mai jos sunt punctele de plecare convenționale.
| Metoda de măsurare | Ceea ce constrânge | Setare tipică în acest tutorial |
|---|---|---|
| Dimensiunea rețelei | Numărul de straturi și unități ascunse | Două straturi ascunse, 300 și 100 de unități |
| Regularizarea ponderilor L1 / L2 | Magnitudinea coeficienților de ponderare | l1_regularization_strength și l2_regularization_strength de 0.01 |
| Renunța | Ponderea unităților dezactivate per etapă de antrenament | abandon școlar de 0.3 |
Dimensiunea rețelei
O rețea neuronală cu prea multe straturi și unități ascunse este cunoscută ca fiind extrem de sofisticată. O modalitate simplă de a reduce complexitatea modelului este reducerea dimensiunii acestuia. Nu există o singură practică optimă pentru definirea numărului de straturi. Trebuie să începeți cu un număr mic de straturi și să creșteți dimensiunea până când descoperiți că modelul se supraadaptează.
Regularizarea greutății
O tehnică standard pentru a preveni supraadaptarea este adăugarea de constrângeri la ponderile rețelei. Constrângerea forțează ponderile rețelei să ia doar valori mici. Constrângerea este adăugată la funcția de pierdere a erorii. Există două tipuri de regularizare:
- L1 (Laso): Costul este proporțional cu valoarea absolută a coeficienților de ponderare.
- L2 (Creastă): Costul este proporțional cu pătratul valorii coeficienților de ponderare.
Renunța
Abandonarea este o tehnică ciudată, dar utilă. O rețea cu abandonare înseamnă că unele unități vor fi oprite aleatoriu în timpul unei etape de antrenament, astfel încât semnalul lor de ieșire devine zero. Imaginați-vă că aveți o matrice de ponderi [0.1, 1.7, 0.7, -0.9]. Dacă rețeaua neuronală are o abandonare, aceasta va deveni [0.1, 0, 0, -0.9] cu 0 distribuit aleatoriu. Parametrul care controlează abandonarea este rata de abandonare. Rata definește câte unități sunt oprite. O rată între 0.2 și 0.5 este comună.
Un mic exemplu interactiv face ca bucla de antrenament să fie ușor de urmărit.
Exemplu de rețea neuronală în TensorFlow
Iată un exemplu de rețea neuronală artificială în acțiune, care arată cum funcționează o rețea neuronală la o problemă tipică de clasificare. Există două intrări, x1 și x2, fiecare cu o valoare aleatorie. Ieșirea este o clasă binară. Obiectivul este de a clasifica eticheta pe baza celor două caracteristici. Pentru a îndeplini această sarcină, arhitectura rețelei neuronale este definită după cum urmează:
- Două straturi ascunse
- Primul strat are patru neuroni complet conectați
- Al doilea strat are doi neuroni complet conectați
- Funcția de activare este o ReLU
- Adăugați o regularizare L2 cu o rată de învățare de 0.003
Rețeaua va optimiza ponderile pe parcursul a 180 de epoci cu o dimensiune a lotului de 10. În animația exemplului ANN de mai jos, puteți vedea cum evoluează ponderile în timp și cum îmbunătățește rețeaua harta de clasificare.ping.

În primul rând, rețeaua atribuie valori aleatorii tuturor ponderilor.
- Cu ponderi aleatorii, adică fără optimizare, pierderea de ieșire este de 0.453. Imaginea de mai jos reprezintă rețeaua cu diferite culori.
- În general, culoarea portocalie reprezintă valori negative, în timp ce culorile albastre arată valorile pozitive.
- Punctele de date au aceeași reprezentare: cele albastre sunt etichetele pozitive, iar cele portocalii etichetele negative.

În interiorul celui de-al doilea strat ascuns, liniile sunt colorate urmând semnul ponderilor. Liniile portocalii poartă ponderi negative, iar cele albastre ponderi pozitive.
După cum puteți vedea, în harta de ieșireping, rețeaua face destul de multe greșeli. Acum uitați-vă cum se comportă rețeaua după optimizare.
Imaginea exemplului de rețea neuronală artificială de mai jos prezintă rezultatele rețelei optimizate. În primul rând, observați că rețeaua a învățat cu succes cum să clasifice punctele de date. Comparând cu imaginea anterioară, ponderea inițială a fost de -0.43, în timp ce după optimizare rezultă o pondere de -0.95.

Ideea poate fi generalizată pentru rețele cu mai multe straturi și neuroni ascunși. Puteți experimenta singuri cu setările în Locul de joacă TensorFlow.
Ghidul de mai jos construiește aceeași idee în cod pe un set de date real.
Cum să antrenezi o rețea neuronală cu TensorFlow
Iată procesul pas cu pas despre cum să antrenezi o rețea neuronală cu TensorFlow Rețea neuronală artificială (ANN) utilizând estimatorul DNNClassifier al API-ului.
Vom folosi setul de date MNIST pentru a vă instrui prima rețea neuronală. Antrenarea unei rețele neuronale cu TensorFlow nu este foarte complicat. Pasul de preprocesare arată exact la fel ca în tutorialele anterioare. Veți proceda după cum urmează:
- Importă datele
- Transformă datele
- Construiți tensorul
- Construiți modelul
- Antrenează și evaluează modelul
- Îmbunătățiți modelul
Notă privind versiunea: Codul din această demonstrație vizează API-ul TensorFlow 1.x Estimator. Versiunea finală a pachetului tf-estimator a fost livrată odată cu TensorFlow 2.15, iar tf.estimator a fost eliminat în TensorFlow 2.16. Pentru a executa acești pași pe o versiune curentă, fie fixați TensorFlow 2.15, fie reconstruiți aceeași rețea cu două straturi cu tf.keras.layers.Dense și model.fit().
Pasul 1) Importați datele
În primul rând, trebuie să importați biblioteca necesară. Puteți importa setul de date MNIST folosind scikit-learn așa cum se arată în exemplul de rețea neuronală TensorFlow de mai jos.
Setul de date MNIST este cel mai frecvent utilizat pentru testarea unor tehnici sau algoritmi noi. Este o colecție de imagini de 28×28 pixeli, fiecare prezentând o cifră scrisă de mână de la 0 la 9. Un comitet de rețele convoluționale profunde antrenate cu distorsiuni elastice a redus eroarea de testare la 0.27%.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
Ghidul original a descărcat fișierele MNIST manual și a direcționat fetch_mldata către acel folder.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
Notă API: mldata.org nu mai este online, iar fetch_mldata a fost eliminat în scikit-learn 0.22. La o instalare curentă, înlocuiți apelul de mai sus cu fetch_openml('mnist_784', version=1), care descarcă aceleași 70,000 de cifre și expune atributele identice de date și țintă.
După aceea, împărțiți datele și obțineți forma ambelor seturi de date.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
Pasul 2) Transformați datele
În tutorialul anterior, ați învățat că trebuie să transformați datele pentru a limita efectul valorilor aberante. În acest tutorial despre rețele neuronale, veți transforma datele folosind scalatorul min-max. Formula este:
(X-min_x)/(max_x - min_x)
scikit-learn are deja o funcție pentru asta: MinMaxScaler()
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
Pasul 3) Construiți tensorul
Acum ești familiarizat cu modul de a crea tensori în TensorFlow. Puteți converti setul de trenuri într-o coloană numerică.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
Pasul 4) Construiți modelul
Arhitectura rețelei neuronale conține 2 straturi ascunse, cu 300 de unități pentru primul strat și 100 de unități pentru al doilea. Aceste valori provin din experiență, nu dintr-o formulă. Le puteți ajusta și puteți vedea cum afectează precizia rețelei.
Pentru a construi modelul, utilizați estimatorul DNNClassifier. Trebuie să setați numărul de clase la 10, deoarece există zece clase în setul de antrenament. Sunteți deja familiarizați cu sintaxa obiectului estimator. Argumentele feature_columns, n_classes și model_dir sunt exact aceleași ca în tutorialul anterior. Argumentul hidden_units este cel nou: controlează atât numărul de straturi, cât și câte noduri se conectează fiecare strat la rețeaua neuronală. În codul de mai jos, există două straturi ascunse, primul conectând 300 de noduri, iar al doilea 100 de noduri.
Pentru a construi estimatorul, utilizați tf.estimator.DNNClassifier cu următorii parametri:
- coloane_de_caracteristici: Definiți coloanele de utilizat în rețea
- unități_ascunse: Definiți numărul de neuroni ascunși
- n_clase: Definiți numărul de clase de prezis
- director_model: Definiți calea de TensorBoard
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
Pasul 5) Antrenează și evaluează modelul
Puteți utiliza funcția de intrare NumPy pentru a antrena modelul și a-l evalua.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
ieșire:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
Arhitectura actuală duce la o precizie a setului de evaluare de aproximativ 96%.
Pasul 6) Îmbunătățiți modelul
Puteți încerca să îmbunătățiți modelul adăugând parametri de regularizare.
Aici, estimatorul folosește un optimizator Proximal AdaGrad cu o rată de abandon de 0.3 și ambele intensități L1 și L2 setate la 0.01. Într-o rețea neuronală TensorFlow, se ajunge la optimizator prin intermediul obiectului train urmat de numele optimizatorului. TensorFlow livrează o API încorporată pentru optimizatorul Proximal AdaGrad.
Pentru a adăuga regularizare la rețeaua neuronală profundă, puteți utiliza tf.train.ProximalAdagradOptimizer cu următorii parametri:
- Rata de învățare: rata_de_învățare
- Regularizare L1: l1_regularization_strength
- Regularizare L2: l2_regularization_strength
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
ieșire:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
Valorile alese pentru a reduce supraadaptarea nu au îmbunătățit precizia modelului. Primul model a avut o precizie de 96%, în timp ce modelul cu regularizatorul L2 are o precizie de 95%. Puteți încerca diferite valori și puteți vedea cum influențează precizia.
