
NLTK Tokenize: tokenizador de palavras e frases com exemplo
 Equipe editorial
⚡ Resumo Inteligente
O NLTK Tokenize divide textos longos em unidades menores chamadas tokens, uma etapa fundamental no processamento de linguagem natural. O conjunto de ferramentas fornece o word_tokenize para dividir frases em palavras e o sent_tokenize para dividir o texto em frases individuais.
O que é tokenização?
tokenization é o processo pelo qual uma grande quantidade de texto é dividida em partes menores chamadas tokens. Esses tokens são muito úteis para encontrar padrões e são considerados uma etapa base para lematização e lematização. A tokenização também ajuda a substituir elementos de dados confidenciais por elementos de dados não confidenciais.
O processamento de linguagem natural é usado para construir aplicativos como classificação de texto, chatbot inteligente, análise sentimental, tradução de idiomas, etc. Torna-se vital compreender o padrão do texto para atingir o propósito declarado acima.
Por enquanto, não se preocupe com lematização e lematização, mas trate-as como etapas para limpeza de dados textuais usando PNL (processamento de linguagem natural). Discutiremos lematização e lematização posteriormente neste tutorial. Tarefas como Classificação de texto ou filtragem de spam faz uso de PNL junto com bibliotecas de aprendizagem profunda, como Keras e Tensorflow.
O kit de ferramentas Natural Language possui um módulo NLTK muito importante tokenize frases que compreendem ainda submódulos
- palavra tokenizar
- tokenização de frase
Tokenização de palavras
Usamos o método palavra_tokenize() dividir uma frase em palavras. A saída da tokenização de palavras pode ser convertida em Data Frame para melhor compreensão do texto em aplicativos de aprendizado de máquina. Também pode ser fornecido como entrada para outras etapas de limpeza de texto, como remoção de pontuação, remoção de caracteres numéricos ou lematização. Os modelos de aprendizado de máquina precisam de dados numéricos para serem treinados e fazerem previsões. A tokenização de palavras torna-se uma parte crucial da conversão de texto (string) em dados numéricos. Por favor, leia sobre Saco de palavras ou CountVectorizer. Consulte o exemplo de tokenização de palavras NLTK abaixo para entender melhor a teoria.
from nltk.tokenize import word_tokenize
text = "God is Great! I won a lottery."
print(word_tokenize(text))

Output: ['God', 'is', 'Great', '!', 'I', 'won', 'a', 'lottery', '.']
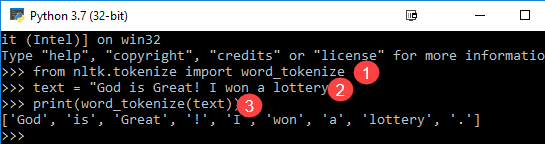
Code Explicação
- O módulo word_tokenize é importado da biblioteca NLTK.
- Uma variável “texto” é inicializada com duas sentenças.
- A variável de texto é passada no módulo word_tokenize e imprime o resultado. Este módulo divide cada palavra com pontuação que você pode ver na saída.
Tokenização de sentenças
O submódulo disponível para o acima é sent_tokenize. Uma pergunta óbvia em sua mente seria por que a tokenização de frases é necessária quando temos a opção de tokenização de palavras. Imagine que você precisa contar a média de palavras por frase, como você irá calcular? Para realizar tal tarefa, você precisa tanto do tokenizer de frase NLTK quanto do tokenizer de palavra NLTK para calcular a proporção. Essa saída serve como um recurso importante para o treinamento da máquina, pois a resposta seria numérica.
Verifique o exemplo do tokenizador NLTK abaixo para saber como a tokenização de frases é diferente da tokenização de palavras.
from nltk.tokenize import sent_tokenize
text = "God is Great! I won a lottery."
print(sent_tokenize(text))

Output: ['God is Great!', 'I won a lottery ']
Nós temos 12 palavras e duas sentenças para a mesma entrada.
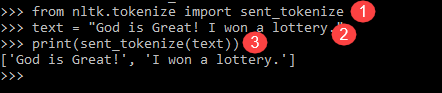
Explicação do programa
- Em uma linha como no programa anterior, importou o módulo sent_tokenize.
- Tomamos a mesma sentença. O tokenizador de frase adicional no módulo NLTK analisou essas frases e mostrou a saída. É claro que esta função quebra cada frase.
Acima do tokenizador de palavra Python exemplos são boas pedras de configuração para entender a mecânica da tokenização de palavras e frases.
