
O que é Star Schema na modelagem de Data Warehouse?
 David Carter
⚡ Resumo Inteligente
O esquema em estrela na modelagem de data warehouse coloca uma tabela de fatos central no núcleo das tabelas de dimensão circundantes, criando um design desnormalizado em forma de estrela que simplifica as consultas analíticas, acelera a geração de relatórios e potencializa os cubos OLAP em plataformas de business intelligence.
O que é um Esquema Estelar?
A cronograma rígido Em um data warehouse, um esquema em estrela é uma estrutura de modelagem na qual uma tabela de fatos central se conecta a várias tabelas de dimensões associadas. É chamado de esquema em estrela porque seu layout se assemelha a uma estrela, com a tabela de fatos no centro e as tabelas de dimensões irradiando para fora como pontas.
O esquema em estrela é o tipo mais simples de esquema de data warehouse, também conhecido como esquema de junção em estrela. Como suas tabelas de dimensão são desnormalizadas, o modelo é otimizado para consultar conjuntos de dados muito grandes, o que o torna uma escolha comum para... modelagem dimensional e relatórios.
O que é um esquema multidimensional?
A esquema multidimensional é projetado especificamente para modelar sistemas de data warehouse. Esses esquemas atendem às necessidades exclusivas de bancos de dados muito grandes, construídos para fins analíticos de OLAP em vez de para processamento de transações de rotina.
Tipos de esquema de data warehouse: Existem três tipos principais de esquemas multidimensionais, e cada um oferece suas próprias vantagens.
- Esquema em estrela – uma tabela de fatos central diretamente ligada a tabelas de dimensões desnormalizadas.
- Esquema de floco de neve – uma extensão do esquema em estrela na qual as dimensões são normalizadas em tabelas de subdimensões adicionais.
- Esquema da galáxia – também chamada de constelação de fatos, utiliza múltiplas tabelas de fatos que compartilham tabelas de dimensões comuns.
Como o esquema em floco de neve se baseia diretamente no esquema em estrela, é útil comparar os dois modelos antes de analisar um exemplo detalhado do esquema em estrela.
Esquema em estrela vs. Esquema em floco de neve
O esquema em estrela e o esquema de floco de neve Ambos os esquemas organizam os dados em torno de tabelas de fatos e dimensões, mas diferem na forma como as dimensões são armazenadas. Um esquema em estrela mantém cada dimensão em uma única tabela desnormalizada, enquanto um esquema em floco de neve normaliza essas dimensões em várias tabelas relacionadas.
- Estrutura: O esquema em estrela é plano e simples; o esquema em floco de neve ramifica as dimensões em subdimensões.
- Velocidade de consulta: Os esquemas em estrela precisam de menos junções, portanto as consultas geralmente são executadas mais rapidamente e o SQL permanece mais simples.
- Armazenamento: Os esquemas em floco de neve eliminam a redundância, utilizando assim menos espaço, mas aumentam a complexidade do projeto.
- Integridade de dados: As dimensões normalizadas dos flocos de neve reforçam melhor a integridade, enquanto as dimensões desnormalizadas das estrelas favorecem o desempenho.
- Facilidade de uso: Um esquema em estrela é mais simples para os analistas entenderem e mais rápido de manter, enquanto um esquema em floco de neve exige um planejamento mais cuidadoso.
Na prática, as equipes costumam escolher um esquema em estrela para data marts e dashboards que exigem relatórios rápidos e diretos, e um esquema em floco de neve quando a economia de armazenamento e a consistência rigorosa são mais importantes.
Exemplo de esquema em estrela
No exemplo de esquema em estrela a seguir, a tabela de fatos está no centro e contém as chaves para todas as tabelas de dimensão, como Dealer_ID, Model_ID, Date_ID, Product_ID e Branch_ID, juntamente com atributos mensuráveis como unidades vendidas e receita.
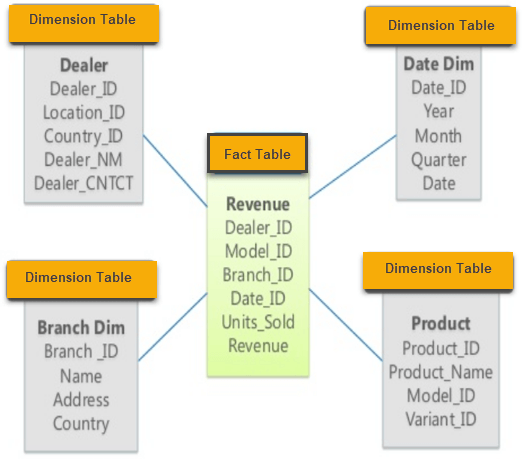
Cada tabela de dimensão adjacente adiciona contexto descritivo a essas medidas, de modo que uma única consulta pode agrupar ou filtrar os dados de vendas por revendedor, modelo, data, produto ou filial, sem a necessidade de unir outras tabelas.
Tabelas de fatos
Uma tabela de fatos em um esquema estrela contém fatos e está conectada às dimensões. Uma tabela de fatos possui dois tipos de colunas:
- Uma coluna que armazena os fatos ou as medidas.
- Chaves estrangeiras que fazem a ligação com cada tabela de dimensão.
Geralmente, a chave primária de uma tabela de fatos é uma chave composta formada por todas as chaves estrangeiras que compõem a tabela.
As tabelas de fatos podem conter fatos detalhados ou fatos agregados. As tabelas de fatos que incluem fatos agregados são frequentemente chamadas de tabelas de resumo e geralmente contêm fatos que já foram agregados em algum nível.
Tabelas Dimensionais
Uma dimensão é uma estrutura que categoriza dados em uma hierarquia. Uma dimensão sem hierarquias e níveis é chamada de dimensão plana ou lista. A chave primária de cada tabela de dimensão faz parte da chave primária composta da tabela de fatos.
Um atributo de dimensão é um atributo descritivo e textual que ajuda a descrever um valor dimensional, como o nome de um produto ou uma cidade. Como as tabelas de dimensão armazenam esse contexto descritivo em vez de eventos transacionais, as tabelas de fatos geralmente são muito maiores do que as tabelas de dimensão.
Como projetar um esquema em estrela
A criação de um esquema em estrela segue a abordagem de modelagem dimensional popularizada por Ralph Kimball. O objetivo é organizar as métricas de negócios em torno de dimensões claras e reutilizáveis, de modo que o modelo final seja fácil de consultar e rápido de gerar relatórios. Os cinco passos a seguir descrevem o processo que a maioria dos projetos de modelagem dimensional segue, partindo da questão de negócios de mais alto nível até as tabelas físicas de fatos e dimensões.
- Identifique o processo de negócio: Escolha a atividade que deseja analisar, como vendas, remessas.pingou inventário. Essa decisão define o que a tabela de fatos irá medir.
- Declare o grão: Defina o nível de detalhe que cada linha de dados representa, por exemplo, uma linha por item, por transação ou por dia. Uma granularidade clara mantém o modelo consistente.
- Identifique as dimensões: Liste o contexto descritivo necessário para segmentar os dados, como produto, cliente, revendedor, filial e data. Cada um deles se torna uma tabela dimensional de atributos.
- Identifique os fatos: Determine as medidas numéricas que a empresa deseja. track, como unidades vendidas, receita ou custo, e coloque-os na tabela de fatos central.
- Construa a estrela: Conecte a tabela de fatos a cada dimensão por meio de chaves estrangeiras, mantenhaping As dimensões foram desnormalizadas de forma que o diagrama forma uma única tabela de fatos central cercada por suas dimensões.
Após a construção da estrutura em estrela, adicione uma chave substituta a cada dimensão, certifique-se de que cada tabela de fatos tenha uma dimensão de data associada e confirme se todos os fatos estão no mesmo nível de granularidade. Também é uma boa prática carregar primeiro os dados atômicos de nível mais baixo, pois as tabelas de resumo podem sempre ser derivadas posteriormente. Seguir essas regras mantém o esquema otimizado para alto desempenho e simplicidade. data warehouse comunicando.
Características do esquema estelar
- Em um esquema em estrela, cada dimensão é representada por apenas uma tabela de dimensões.
- Cada tabela de dimensão contém seu próprio conjunto de atributos.
- A tabela de dimensões é associada à tabela de fatos por meio de uma chave estrangeira.
- As tabelas de dimensões não estão interligadas.
- A tabela de fatos contém chaves e medidas.
- O esquema em estrela é fácil de entender e proporciona uma utilização otimizada do disco.
- As tabelas de dimensão não estão normalizadas. Por exemplo, no exemplo acima, Country_ID não possui uma tabela de pesquisa de país separada, como ocorre com Country_ID. OLTP design seria.
- O esquema é amplamente suportado por ferramentas de BI.
Vantagens do esquema estrela
O esquema em estrela oferece diversas vantagens que o tornam um ponto de partida popular para o projeto de data warehouses:
- Os esquemas em estrela usam uma lógica de junção mais simples do que outros esquemas ao buscar dados de fontes transacionais altamente normalizadas.
- O esquema em estrela simplifica a lógica comum de relatórios empresariais, como relatórios de comparação entre períodos e relatórios data-base.
- Os esquemas em estrela são amplamente utilizados pelos sistemas OLAP para construir cubos de forma eficiente, e um esquema em estrela pode servir como fonte sem a necessidade de projetar uma estrutura de cubo na maioria dos principais sistemas OLAP.
- Ao habilitar ajustes de desempenho específicos que podem ser aplicados às consultas, o processador de consultas pode oferecer melhores planos de execução.
Desvantagens do esquema em estrela
- Como o esquema é altamente desnormalizado, a integridade dos dados não é rigorosamente aplicada.
- Não é flexível em termos de necessidades analíticas avançadas.
- Os esquemas em estrela não reforçam relacionamentos muitos-para-muitos entre entidades de negócios.
Quando usar um esquema em estrela
O esquema em estrela é a escolha certa quando o desempenho rápido e previsível das consultas é mais importante do que a economia de espaço de armazenamento. Como o modelo mantém suas tabelas de dimensão desnormalizadas e o número de junções baixo, ele é adequado para cargas de trabalho analíticas em que os usuários de negócios executam repetidamente relatórios, painéis e agregações semelhantes em grandes volumes de dados históricos.
Situações típicas em que um esquema em estrela é uma boa opção incluem:
- Data marts: Departamental datamarts Relações simples e bem compreendidas se beneficiam de uma estrutura legível.
- Painéis de BI: Inteligência Econômica As ferramentas se integram perfeitamente aos esquemas em estrela, permitindo a criação rápida de relatórios e visualizações.
- Cubos OLAP: Os esquemas em estrela são uma fonte natural para cubos OLAP, agregação e análise de segmentação e segmentação.
Se a prioridade mudar para armazenamento mínimo, integridade de dados rigorosa ou hierarquias profundas e variáveis, um esquema em floco de neve ou um design mais normalizado pode ser mais adequado. Muitas equipes até combinam os dois, começando com um esquema em estrela e normalizando apenas as dimensões que realmente precisam.
