
SQL Server Architextura (explicado)
 Equipe editorial
⚡ Resumo Inteligente
SQL Server ArchiA arquitetura segue um modelo cliente-servidor organizado em três camadas principais: Camada de Protocolo para comunicação em rede, Motor Relacional para processamento de consultas e Motor de Armazenamento para gerenciamento e recuperação de dados.
O MS SQL Server possui uma arquitetura cliente-servidor. O processo do MS SQL Server inicia-se quando a aplicação cliente envia uma solicitação. O SQL Server aceita, processa e responde à solicitação com os dados processados. Vamos discutir em detalhes toda a arquitetura mostrada abaixo:
Conforme ilustrado no diagrama abaixo, o SQL Server possui três componentes principais. Architextura:
- Camada de protocolo
- Motor Relacional
- Motor de Armazenamento
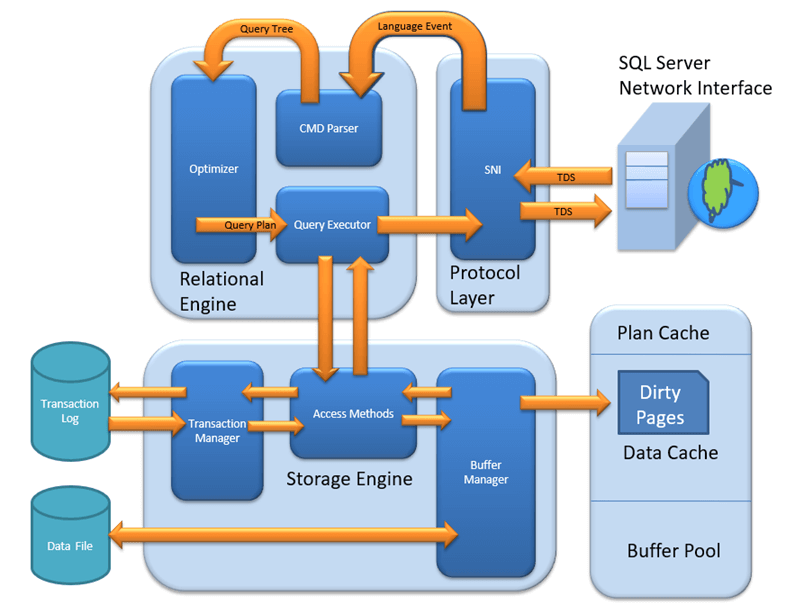
Camada de protocolo – SNI
A camada de protocolo do SQL Server, também conhecida como Interface de Rede do Servidor (SNI), suporta três tipos de arquitetura cliente-servidor. Cada protocolo atende a um cenário de rede diferente. Compreender esses protocolos é essencial antes de explorar como as consultas são processadas internamente.
Memoria compartilhada
Imagine uma conversa matinal. Tom e sua mãe estão no mesmo lugar, em casa. Tom pede um café e a mãe o serve imediatamente. De forma semelhante, o SQL Server oferece o protocolo de Memória Compartilhada quando o cliente e o servidor são executados na mesma máquina. Ambos se comunicam por meio da memória compartilhada, sem qualquer sobrecarga de rede.

Analogia: Tom corresponde ao Cliente, Mom ao SQL Server, Home à Máquina e a comunicação verbal ao protocolo de Memória Compartilhada.

Notas de configuração: In SQL Management StudioA opção “Nome do servidor” para uma conexão local pode ser “.”, “localhost”, “127.0.0.1” ou “Máquina\Instância”.
TCP / IP
Agora imagine que Tom quer um café de uma cafeteria localizada a 10 km de distância. Tom está em casa e a cafeteria fica em um mercado movimentado. Eles se comunicam por meio de uma rede celular. Da mesma forma, o SQL Server fornece a Protocolo TCP / IP quando o cliente e o SQL Server estão em máquinas separadas, conectadas por uma rede.

Analogia: Tom representa o Cliente, a cafeteria representa o SQL Server, a casa e o mercado representam locais remotos e a rede celular representa o protocolo TCP/IP.

Notas de configuração: No SQL Server Management Studio, a opção "Nome do Servidor" para uma conexão TCP/IP deve ser "Máquina\Instância do servidor". O SQL Server usa a porta 1433 por padrão para conexões TCP/IP.

Tubulações nomeadas
Por fim, Tom quer chá verde da sua vizinha Sierra. Eles estão no mesmo local físico, por serem vizinhos, e se comunicam por meio de uma rede interna. Da mesma forma, o SQL Server oferece o protocolo Named Pipe quando o cliente e o servidor estão conectados por meio de uma Rede Local (LAN).

Analogia: Tom corresponde ao Cliente, Sierra corresponde ao SQL Server, ser vizinho corresponde à LAN e a rede interna corresponde ao protocolo Named Pipe.
Notas de configuração: O recurso Named Pipes está desativado por padrão e deve ser ativado por meio do SQL Server Configuration Manager.
O que é TDS?
Agora que os três tipos de arquitetura cliente-servidor estão claros, vejamos o TDS:
- TDS significa Fluxo de Dados Tabulares.
- Todos os três protocolos utilizam pacotes TDS.
- O TDS é encapsulado em pacotes de rede, permitindo a transferência de dados da máquina cliente para a máquina servidora.
- O TDS foi desenvolvido inicialmente pela Sybase e agora pertence à Microsoft.
A tabela a seguir compara os três protocolos de conexão do SQL Server:
| Característica | Memoria compartilhada | TCP / IP | Tubulações nomeadas |
|---|---|---|---|
| Âmbito da rede | Mesma máquina | Remoto (WAN/Internet) | Apenas LAN |
| Porta padrão | N/D | 1433 | 445 |
| Desempenho | Mais rápido (sem sobrecarga de rede) | Bom (otimizado para WAN) | Bom (otimizado para LAN) |
| Ativado por padrão | Sim | Sim | Não |
| Melhor Caso de Uso | Desenvolvimento e testes locais | Acesso remoto à produção | Ambientes de LAN confiáveis |
Com a camada de protocolo lidando com a comunicação de rede, o próximo passo na arquitetura do SQL Server é processar a própria consulta. É aqui que o mecanismo relacional entra em ação.
Motor Relacional
O Mecanismo Relacional também é conhecido como Processador de Consultas. Ele contém os componentes do SQL Server que determinam o que uma consulta precisa fazer e como ela pode ser executada da maneira mais eficiente. É responsável por executar as consultas do usuário, solicitando dados do Mecanismo de Armazenamento e processando os resultados retornados.
Conforme ilustrado no diagrama arquitetônico, o Motor Relacional possui três componentes principais:
Analisador CMD
Os dados recebidos da Camada de Protocolo são passados para o Motor Relacional. O Analisador CMD é o primeiro componente a receber os dados da consulta. Sua principal função é verificar a consulta em busca de erros sintáticos e semânticos e, em seguida, gerar uma árvore de consulta.

Verificação sintática: Assim como qualquer outra linguagem de programação, o SQL Server possui um conjunto predefinido de palavras-chave e regras gramaticais. SELECT, INSERT, UPDATE e muitas outras pertencem à lista de palavras-chave predefinidas. O analisador CMD verifica se a entrada segue essas regras. Se a entrada do usuário se desviar da sintaxe esperada, o analisador retorna um erro.
Exemplo: Imagine um russo entrando em um restaurante japonês e fazendo um pedido em russo. O garçom só entende japonês e não consegue processar o pedido. Da mesma forma, se um usuário digitar “SELECR” em vez de “SELECT”, o analisador de comando (CMD Parser) retorna um erro porque não reconhece a palavra-chave.
Verificação semântica: Essa operação é realizada pelo Normalizador. Ele verifica se os nomes das colunas, nomes das tabelas e outros objetos consultados realmente existem no esquema. Se existirem, o Normalizador os vincula à consulta. Esse processo também é conhecido como Vinculação. Quando as consultas do usuário contêm uma VIEW, o Normalizador a substitui pela definição da view armazenada internamente.
Exemplo: Corrida SELECT * from USER_ID Isso faria com que o analisador gerasse um erro durante a verificação semântica se a tabela USER_ID não existisse no banco de dados.
Criar árvore de consulta: Esta etapa gera diferentes árvores de execução que representam as várias maneiras pelas quais uma consulta pode ser executada. Todas as árvores produzem a mesma saída desejada.
Optimizer
O otimizador cria um plano de execução para a consulta do usuário. Esse plano determina como a consulta será executada. Nem todas as consultas são otimizadas. A otimização se aplica a comandos DML (Linguagem de Modificação de Dados), como SELECT, INSERT, DELETE e UPDATE. Comandos DDL, como CREATE e ALTER, não são otimizados, mas compilados em um formato interno.

O custo da consulta é calculado com base em fatores como uso de CPU, uso de memória e necessidades de entrada/saída. O papel do otimizador é encontrar o plano de execução mais econômico, não necessariamente o melhor em todos os aspectos.
Exemplo: Imagine que você queira abrir uma conta bancária online. Um banco leva no máximo 2 dias. Você também tem uma lista de outros 20 bancos que podem ou não levar menos tempo. Pesquisar em todos os 20 bancos pode não encontrar uma opção mais rápida, e a própria pesquisa consome tempo. Teria sido melhor optar pelo primeiro banco. Da mesma forma, o otimizador de SQL usa algoritmos exaustivos e heurísticos para minimizar o tempo de execução da consulta.
O otimizador realiza buscas em três fases:
Fase 0: Busca por um Plano Trivial
Esta é a fase de pré-otimização. Para algumas consultas, existe apenas um plano prático, conhecido como plano trivial. Não há necessidade de pesquisar mais a fundo, pois qualquer busca adicional encontraria o mesmo plano de execução a um custo extra.
Fase 1: Busca por Planos de Processamento de Transações
Isso inclui a busca por planos simples e complexos. A busca por planos simples utiliza análise estatística de dados de colunas e índices, geralmente restrita a um índice por tabela. Se nenhum plano simples for encontrado, uma busca mais complexa, envolvendo múltiplos índices por tabela, é realizada.
Fase 2: Processamento Paralelo e Otimização
Se as estratégias anteriores não produzirem um plano adequado, o Otimizador busca possibilidades de processamento paralelo com base nas capacidades de processamento da máquina. Se o processamento paralelo não for possível, inicia-se uma fase final de otimização que utiliza todas as opções restantes para encontrar o melhor plano de execução possível.
Executor de Consultas
O Executor de Consultas chama o Método de Acesso no Mecanismo de Armazenamento. Ele fornece um plano de execução contendo a lógica de busca de dados necessária para a execução. Assim que os dados são recebidos do Mecanismo de Armazenamento, o resultado é publicado na Camada de Protocolo e enviado ao usuário final.

Após o mecanismo relacional determinar como executar uma consulta, o mecanismo de armazenamento lida com as operações físicas de dados. Essa camada gerencia como os dados são armazenados, colocados em cache e recuperados do disco.
Motor de Armazenamento
O mecanismo de armazenamento é responsável por armazenar dados em um sistema de armazenamento, como um disco ou SAN, e recuperá-los quando necessário. Antes de examinar os componentes do mecanismo de armazenamento, é importante entender como os dados são armazenados fisicamente.

Arquivos de dados e extensões
Os arquivos de dados armazenam fisicamente os dados na forma de páginas de dados, com cada página tendo um tamanho de 8 KB. Esta é a menor unidade de armazenamento em SQL ServerAs páginas de dados são agrupadas logicamente em extensões. Nenhum objeto é atribuído diretamente a uma página individual; em vez disso, a manutenção é feita por meio de extensões. Cada página possui um cabeçalho de página (96 bytes) contendo metadados como tipo de página, número da página, espaço usado, espaço livre e ponteiros para as páginas seguinte e anterior.
Tipos de arquivo

Arquivo principal: Todo banco de dados contém um arquivo principal. Ele armazena todos os dados importantes relacionados a tabelas, visualizações, gatilhos e outros objetos. A extensão geralmente é .mdf, mas pode ser qualquer outra.
Arquivo secundário: Um banco de dados pode ou não conter vários arquivos secundários. Estes são opcionais e contêm dados específicos do usuário. A extensão normalmente é .ndf, mas pode ser qualquer extensão.
Arquivo de registro: Também conhecidos como Write-Ahead Logs (Logs de Gravação Antecipada). A extensão é .ldf. Os arquivos de log são usados para gerenciamento de transações, recuperação de instâncias indesejadas e reversão de transações não confirmadas.
O mecanismo de armazenamento possui três componentes principais. Cada um desempenha um papel específico no gerenciamento do acesso e da integridade dos dados.
Método de Acesso
O método de acesso atua como uma interface entre o executor de consultas e o Buffer Gerenciador de Logs de Transações. Ele não executa a consulta em si, mas determina o tipo de consulta:
- Se a consulta for uma Instrução SELECT (DML), é passado para o Buffer Gerente para processamento posterior.
- Se a consulta for uma Instruções que não sejam SELECT (DDL e DML), é passado para o Gerenciador de Transações. Isso inclui principalmente instruções UPDATE, INSERT e DELETE.

Buffer Manager
O Buffer O gerenciador administra as funções principais do Cache de Planos, análise de dados e tratamento de páginas modificadas.

Cache do plano
Plano de consulta existente: O Buffer O gerenciador verifica se o plano de execução existe no cache de planos armazenado. Se existir, o plano de consulta em cache e seu cache de dados associado são usados diretamente.
Plano de cache para iniciantes: Se um plano de execução de consulta inicial for complexo, ele será armazenado no Cache de Planos. Isso garante maior disponibilidade na próxima vez que o SQL Server receber a mesma consulta.
Análise de dados: Buffer Armazenamento de cache e dados
O Buffer O gerenciador fornece acesso aos dados necessários. Duas abordagens são possíveis, dependendo da existência de dados no cache:
Buffer Cache – Análise sintática suave
O Buffer O gerente procura dados no Buffer Cache. Se os dados estiverem presentes, o Executor de Consultas os utiliza diretamente. Isso melhora o desempenho, pois buscar dados do cache requer menos operações de E/S em comparação com a busca no armazenamento em disco.

Armazenamento de dados – Análise sintática complexa
Se os dados não estiverem presentes no Buffer Em cache, os dados necessários são pesquisados no armazenamento de dados em disco. Os dados são então armazenados em cache para uso futuro.

Gerente de Transação
O Gerenciador de Transações é invocado quando o Método de Acesso determina que uma consulta não é uma instrução SELECT. Ele garante a consistência e a durabilidade dos dados por meio de vários subcomponentes:

Gerenciador de registros
O Gerenciador de Logs mantém track de todas as atualizações realizadas no sistema por meio de registros armazenados nos Logs de Transações. Cada entrada de log contém um Número de Sequência de Log, juntamente com o ID da Transação e o Registro de Modificação de Dados. Este mecanismo tracks confirmou e reverteu transações.
Gerenciador de bloqueio
Durante uma transação, os dados associados no armazenamento entram em um estado bloqueado. O Gerenciador de Bloqueios lida com esse processo, garantindo a consistência e o isolamento dos dados. Essas propriedades também são conhecidas como ACID (Anti-Integrated, Disclosure and Acids).Atomgelo, consistência, isolamento, durabilidade).
Processo de Execução
O processo de execução segue estes passos:
- O Gerenciador de Logs inicia o registro de logs e o Gerenciador de Bloqueios bloqueia os dados associados.
- Uma cópia dos dados é mantida no Buffer Escondido.
- Uma cópia dos dados a serem atualizados é mantida no Log. Buffere todos os eventos atualizam os dados nos Dados Buffer.
- Páginas que armazenam dados modificados são conhecidas como Páginas sujas.
Registro de ponto de verificação e gravação antecipada
O processo de checkpoint é executado aproximadamente uma vez por minuto e marca todas as páginas sujas para gravação em disco. No entanto, a página é primeiro movida para a página de dados do arquivo de log a partir do Buffer Log. Esse mecanismo é conhecido como Write-Ahead Logging (Logging antecipado). As páginas sujas permanecem no cache mesmo depois de serem gravadas em disco.
Preguiçoso Writer
Quando o SQL Server detecta uma carga elevada e precisa de memória de buffer para novas transações, ele libera páginas sujas do cache. O Lazy Writer Opera com base no algoritmo LRU (Least Recently Used - Menos Recentemente Usado) para limpar páginas do buffer pool e gravá-las em disco.
Como o SQL Server processa uma consulta de ponta a ponta
Compreender cada camada individualmente é valioso, mas ver como elas funcionam em conjunto esclarece o panorama completo. Quando um aplicativo cliente envia uma consulta SQL, a seguinte sequência ocorre:
O Camada de protocolo Recebe a solicitação via memória compartilhada, TCP/IP ou Named Pipes e a encapsula em um pacote TDS. Motor Relacional Em seguida, o processo assume o controle: o analisador CMD verifica a sintaxe e a semântica, o otimizador gera o plano de execução mais econômico e o executor de consultas inicia a recuperação de dados.
O executor de consultas chama o Motor de armazenamento Método de acesso, que encaminha consultas SELECT para o Buffer Consultas de gerenciamento e modificação para o Gerenciador de Transações. Buffer O gerenciador verifica o cache do plano e Buffer Primeiro, o sistema armazena os dados em cache (análise sintática suave). Se os dados não estiverem em cache, realiza uma leitura do disco (análise sintática completa). Para operações de gravação, o Gerenciador de Transações coordena o Gerenciador de Logs, o Gerenciador de Bloqueios e o processo de checkpoint para garantir a conformidade com os protocolos ACID.
Assim que o mecanismo de armazenamento retorna os dados solicitados, o mecanismo relacional formata o conjunto de resultados e a camada de protocolo o entrega de volta ao aplicativo cliente por meio do mesmo protocolo TDS.
Como escolher o protocolo correto para conexões com o SQL Server
A escolha do protocolo correto depende da relação física entre o cliente e o servidor, bem como dos requisitos de desempenho.
Usar memória compartilhada Quando a aplicação cliente é executada na mesma máquina que o SQL Server. Esta é a opção mais rápida, pois elimina toda a sobrecarga de rede. É ideal para desenvolvimento local, testes e implantações em uma única máquina.
Utilizar TCP/IP Quando o cliente e o servidor estão em máquinas diferentes conectadas por uma WAN ou pela internet, este é o protocolo mais comumente usado em ambientes de produção. O SQL Server utiliza a porta 1433 por padrão, e este protocolo suporta conexões criptografadas via TLS.
Use pipes nomeados Quando o cliente e o servidor estão na mesma LAN confiável e o desempenho em redes internas é uma prioridade, o recurso Named Pipes é desativado por padrão e deve ser ativado por meio do SQL Server Configuration Manager. Embora seja menos comum em implantações modernas, continua sendo útil para aplicações legadas de intranet.
