
Algoritmo de ordenação Shell com exemplo
 Sarah Chen
⚡ Resumo Inteligente
O Shell Sort é um algoritmo de comparação in-place que generaliza o Insertion Sort, comparando elementos que estão muito distantes uns dos outros e, em seguida, reduzindo a distância até que os elementos adjacentes estejam ordenados.

O que é Shell Sort?
O Shell Sort, também chamado de método de Shell, é um algoritmo de ordenação eficiente baseado em comparação in-place. Nomeado em homenagem a Donald Shell, que introduziu a ideia em 1959, é uma extensão generalizada do Insertion Sort que supera seu comportamento quadrático em dados dispersos.
A ideia fundamental é agrupar elementos que estejam muito distantes uns dos outros, ordenar cada grupo usando o algoritmo de ordenação por inserção e reduzir a distância entre eles gradualmente até que chegue a um. Nesse ponto, o array estará quase ordenado.
Essa lacuna, o intervalo, segue uma sequência escolhida, como a original de Shell, a de Knuth, a de Hibbard ou a de Sedgewick. A original de Shell é n/2, n/4, ..., 1.
Algoritmo de classificação de shell
Passo 1) Inicialize o valor do intervalo h = n/2, onde n é o tamanho da matriz.
Passo 2) Coloque todos os elementos dentro de uma distância do intervalo h em uma sublista.
Passo 3) Ordene cada sublista usando o método de ordenação por inserção.
Passo 4) Defina um novo intervalo h = h/2.
Passo 5) Se h > 0, retorne ao Passo 2. Caso contrário, vá para o Passo 6.
Passo 6) O array resultante agora está totalmente ordenado.
Como funciona a classificação de shell
Na ordenação por inserção, os elementos se movem apenas uma posição por vez. A ordenação Shell, por sua vez, divide o array em sublistas amplamente espaçadas com base no intervalo e executa a ordenação por inserção em cada sublista.
À medida que o intervalo diminui, o tamanho da sublista aumenta. Como as passagens anteriores deixam os dados parcialmente ordenados, intervalos menores exigem muito menos trocas do que a execução de um intervalo maior. tipo de inserção Do zero. A figura abaixo ilustra uma passagem do Shell Sort.

Funcionamento do algoritmo de ordenação Shell com exemplo
Vamos ordenar a matriz abaixo usando o Shell Sort.

Passo 1) O tamanho da matriz é 8, portanto o valor do intervalo inicial é h = 8/2 = 4.
Passo 2) Agrupe os elementos com quatro posições de distância. Sublistas: {8, 1}, {6, 4}, {7, 5}, {2, 3}.

Passo 3) Ordene cada sublista usando o algoritmo de ordenação por inserção. Uma variável temporária armazena o valor que está sendo inserido enquanto os elementos são deslocados. Após as trocas, o array fica assim.

Passo 4) Diminua o intervalo. O novo intervalo é h = 4/2 = 2.
Passo 5) Como 2 > 0, retorne ao Passo 2 e agrupe os elementos com duas posições de distância: {1, 5, 8, 7} e {4, 2, 6, 3}.

Ordene a primeira sublista. O array ficará assim:
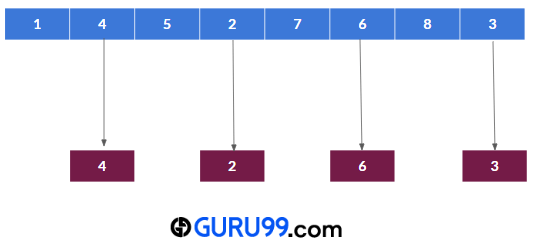
Após ordenar a segunda sublista:

Diminua o intervalo novamente para h = 2/2 = 1. Com uma lacuna de um, o Shell Sort executa uma passagem final de ordenação por inserção em toda a matriz, conforme mostrado abaixo.


Passo 6) Dividindo o intervalo novamente, obtemos 0. O array agora está totalmente ordenado:
Pseudo-Code para Shell Sort
Start
Input array a of size n
for (interval = n / 2; interval > 0; interval /= 2)
    for (i = interval; i < n; i += 1)
        temp = a[i];
        for (j = i; j >= interval && a[j - interval] > temp; j -= interval)
            a[j] = a[j - interval];
        a[j] = temp;
End
Programa de classificação de shell em C/C++
Entrada:
//Shell Sort Program in C/C++
#include <bits/stdc++.h>
using namespace std;
void ShellSort(int data[], int size) {
    for (int interval = size / 2; interval > 0; interval /= 2) {
        for (int i = interval; i < size; i += 1) {
            int temp = data[i];
            int j;
            for (j = i; j >= interval && data[j - interval] > temp; j -= interval) {
                data[j] = data[j - interval];
            }
            data[j] = temp;
        }
    }
}
int main() {
    int data[] = {8, 6, 7, 2, 1, 4, 5, 3};
    int size = sizeof(data) / sizeof(data[0]);
    ShellSort(data, size);
    cout << "Sorted Output: \n";
    for (int i = 0; i < size; i++)
        cout << data[i] << " ";
    cout << "\n";
}
Saída:
Sorted Output:

1 2 3 4 5 6 7 8
Exemplo de classificação de shell em Python
Entrada:
#Shell Sort Example in Python
def ShellSort(data, size):
    interval = size // 2
    while interval > 0:
        for i in range(interval, size):
            temp = data[i]
            j = i
            while j >= interval and data[j - interval] > temp:
                data[j] = data[j - interval]
                j -= interval
            data[j] = temp
        interval //= 2
data = [8, 6, 7, 2, 1, 4, 5, 3]
ShellSort(data, len(data))
print('Sorted Output:')
print(data)
Saída:
Sorted Output:
[1, 2, 3, 4, 5, 6, 7, 8]
Aplicações de Shell Sort
O Shell Sort ainda aparece em sistemas modernos onde o espaço na pilha ou a simplicidade são importantes.
- O Kernel do Linux Utiliza o Shell Sort em locais onde evitar uma pilha de chamadas é importante.
- A biblioteca C incorporada uClibc usa o Shell Sort para manter o uso de memória baixo.
- O bzip2 usa o Shell Sort para evitar recursão profunda durante a ordenação de blocos.
- O firmware embarcado privilegia o Shell Sort para conjuntos de dados pequenos, onde a recursão é restrita.
Vantagens e desvantagens da classificação Shell.
| Vantagens | Desvantagens |
|---|---|
| Não é necessário usar uma pilha de chamadas, o que é ideal para sistemas embarcados. | Não é a opção mais rápida para arrays muito grandes. |
| Fácil de implementar com uma pequena quantidade de código. | O desempenho se degrada em dados com elementos amplamente dispersos. |
| Eficiente para matrizes de tamanho moderado ou parcialmente ordenadas. | A complexidade temporal no pior caso é sensível à sequência de intervalos escolhida. |
| Funciona no mesmo local, portanto utiliza memória auxiliar constante. | Não é um método de ordenação estável, portanto chaves iguais podem alterar a ordem relativa. |
Análise de complexidade de classificação de shell
Complexidade de tempo do Shell Sort
A complexidade temporal do Shell Sort depende da sequência de lacunas utilizada.
Na melhor das hipóteses, quando o array já está quase organizado, cada passagem precisa apenas de um número logarítmico de testes, resultando em O(n log n).
No pior caso, o array é organizado de forma que os elementos necessitem do máximo de comparações, e o incremento final domina em O(n^2) com a sequência original do Shell.
- Complexidade do melhor caso: O(n log n)
- Complexidade no caso médio: O(n log n) a O(n^(4/3)), dependendo da sequência de lacunas.
- Complexidade no pior caso: O(n^2) com a sequência original do Shell.
A melhor sequência de lacunas de uso geral ainda é uma questão de pesquisa em aberto, embora as sequências de Sedgewick e Ciura apresentem bom desempenho na prática.
Complexidade do espaço de classificação de shell
O Shell Sort não requer arrays auxiliares, portanto a complexidade de espaço é O(1) independentemente do tamanho da entrada, o que é uma de suas maiores vantagens práticas.
