
Modelo Seq2seq (Sequência para Sequência) com PyTorch
 Evelyn Clarke
⚡ Resumo Inteligente
Seq2Seq é uma arquitetura codificador-decodificador que mapeia uma sequência de entrada para uma sequência de saída usando duas redes neurais recorrentes, sendo utilizada em tradução automática e outras tarefas de processamento de linguagem natural onde os comprimentos de entrada e saída são diferentes.
O que é PNL?
O Processamento de Linguagem Natural (PLN) é um dos ramos populares da Inteligência Artificial que ajuda os computadores a entender, manipular ou responder a um ser humano em sua linguagem natural. O PLN é o motor por trás... Google Translate que nos ajuda a entender outras línguas.
O que é Seq2Seq?
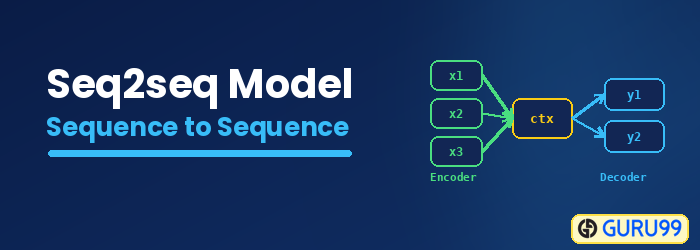
Seq2Seq é um método de tradução automática e processamento de linguagem baseado em codificador-decodificador que mapeia uma entrada de sequência para uma saída de sequência com uma tag e um valor de atenção. A ideia é usar 2 RNNs que trabalharão em conjunto com um token especial e tentarão prever a próxima sequência de estados a partir da sequência anterior.
Como prever a sequência da sequência anterior
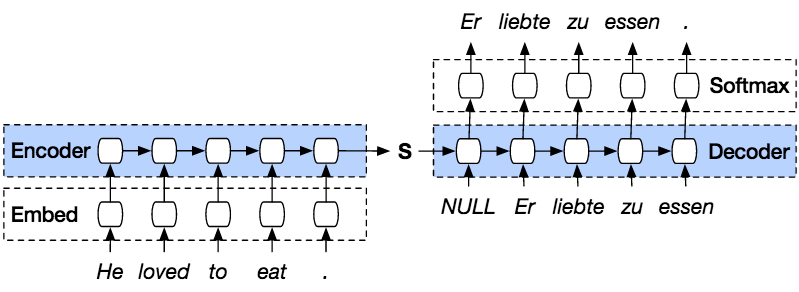
A seguir estão os passos para prever uma sequência a partir da sequência anterior com PyTorcap.
Etapa 1) Carregando nossos dados
Para nosso conjunto de dados, você usará um conjunto de dados de Pares de frases bilíngues delimitados por tabulações. Aqui usarei o conjunto de dados de inglês para indonésio. Você pode escolher o que quiser, mas lembre-se de alterar o nome do arquivo e o diretório no código.
from __future__ import unicode_literals, print_function, division
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F

import numpy as np
import pandas as pd

import os
import re
import random

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
Etapa 2) Preparação de Dados
Você não pode usar o conjunto de dados diretamente. É necessário dividir as frases em palavras e convertê-las em um vetor One-Hot. Cada palavra será indexada exclusivamente na classe Lang para criar um dicionário. A classe Lang armazenará cada frase e a dividirá palavra por palavra com a função addSentence. Em seguida, crie um dicionário indexando cada palavra desconhecida para os modelos de sequência para sequência.
SOS_token = 0
EOS_token = 1
MAX_LENGTH = 20

#initialize Lang Class
class Lang:
   def __init__(self):
       #initialize containers to hold the words and corresponding index
       self.word2index = {}
       self.word2count = {}
       self.index2word = {0: "SOS", 1: "EOS"}
       self.n_words = 2  # Count SOS and EOS

#split a sentence into words and add it to the container
   def addSentence(self, sentence):
       for word in sentence.split(' '):
           self.addWord(word)

#If the word is not in the container, the word will be added to it, else, update the word counter
   def addWord(self, word):
       if word not in self.word2index:
           self.word2index[word] = self.n_words
           self.word2count[word] = 1
           self.index2word[self.n_words] = word
           self.n_words += 1
       else:
           self.word2count[word] += 1
A classe Lang nos ajudará a criar um dicionário. Para cada idioma, cada frase será dividida em palavras e adicionadas a um contêiner. Cada contêiner armazenará as palavras no índice apropriado, contará a palavra e adicionará o índice da palavra para que possamos usá-lo para encontrar o índice de uma palavra ou encontrar uma palavra a partir de seu índice.
Como nossos dados são separados por TAB, você precisa usar pandas como nosso carregador de dados. O Pandas lerá nossos dados como um DataFrame e os dividirá em frases de origem e de destino. Para cada frase, você a normalizará para minúsculas, removerá todos os caracteres não alfanuméricos, converterá de Unicode para ASCII e dividirá as frases para obter todas as palavras.
#Normalize every sentence
def normalize_sentence(df, lang):
   sentence = df[lang].str.lower()
   sentence = sentence.str.replace('[^A-Za-z\s]+', '')
   sentence = sentence.str.normalize('NFD')
   sentence = sentence.str.encode('ascii', errors='ignore').str.decode('utf-8')
   return sentence

def read_sentence(df, lang1, lang2):
   sentence1 = normalize_sentence(df, lang1)
   sentence2 = normalize_sentence(df, lang2)
   return sentence1, sentence2

def read_file(loc, lang1, lang2):
   df = pd.read_csv(loc, delimiter='\t', header=None, names=[lang1, lang2])
   return df

def process_data(lang1,lang2):
   df = read_file('text/%s-%s.txt' % (lang1, lang2), lang1, lang2)
   print("Read %s sentence pairs" % len(df))
   sentence1, sentence2 = read_sentence(df, lang1, lang2)

   source = Lang()
   target = Lang()
   pairs = []
   for i in range(len(df)):
       if len(sentence1[i].split(' ')) < MAX_LENGTH and len(sentence2[i].split(' ')) < MAX_LENGTH:
           full = [sentence1[i], sentence2[i]]
           source.addSentence(sentence1[i])
           target.addSentence(sentence2[i])
           pairs.append(full)

   return source, target, pairs
Outra função útil que você usará é a conversão de pares em tensores. Isso é muito importante porque nossa rede lê apenas dados do tipo tensor. Também é importante porque é nessa parte que, ao final de cada frase, haverá um marcador para indicar à rede que a entrada terminou. Para cada palavra na frase, ela obterá o índice da palavra correspondente no dicionário e adicionará um marcador ao final da frase.
def indexesFromSentence(lang, sentence):
   return [lang.word2index[word] for word in sentence.split(' ')]

def tensorFromSentence(lang, sentence):
   indexes = indexesFromSentence(lang, sentence)
   indexes.append(EOS_token)
   return torch.tensor(indexes, dtype=torch.long, device=device).view(-1, 1)

def tensorsFromPair(input_lang, output_lang, pair):
   input_tensor = tensorFromSentence(input_lang, pair[0])
   target_tensor = tensorFromSentence(output_lang, pair[1])
   return (input_tensor, target_tensor)
Modelo Seq2Seq

PyTorO modelo ch Seq2seq é um tipo de modelo que utiliza um PyTorO codificador e decodificador são aplicados ao modelo. O codificador codifica a frase palavra por palavra em um índice de vocabulário ou palavras conhecidas com um índice, e o decodificador prevê a saída da entrada codificada decodificando a entrada em sequência e tentando usar a última entrada como a próxima, se possível. Com esse método, também é possível prever a próxima entrada para criar uma frase. A cada frase é atribuído um token para marcar o fim da sequência. Ao final da previsão, também haverá um token para marcar o fim da saída. Assim, o codificador passa um estado para o decodificador para prever a saída.

O codificador irá codificar nossa frase de entrada palavra por palavra, em sequência, e ao final haverá um token para marcar o fim da frase. O codificador consiste em uma camada de Embedding e uma camada GRU. A camada de Embedding é uma tabela de consulta que armazena o embedding da nossa entrada em um dicionário de palavras de tamanho fixo. Este embedding será passado para a camada GRU. A camada GRU é uma Unidade Recorrente com Portão (Gated Recurrent Unit) que consiste em um tipo de estrutura de múltiplas camadas. RNN que calculará a entrada sequenciada. Esta camada calculará o estado oculto da anterior e atualizará a redefinição, atualização e novos portões.

O decodificador irá decodificar a entrada a partir da saída do codificador. Ele tentará prever a próxima saída e usá-la como a próxima entrada, se possível. O decodificador consiste em uma camada de incorporação (embedding), uma camada GRU e uma camada linear. A camada de incorporação cria uma tabela de consulta (LOAD) para a saída e a passa para a camada GRU para calcular o estado de saída previsto. Em seguida, a camada linear auxilia no cálculo da função de ativação para determinar o valor real da saída prevista.
class Encoder(nn.Module):
   def __init__(self, input_dim, hidden_dim, embbed_dim, num_layers):
       super(Encoder, self).__init__()

       #set the encoder input dimesion , embbed dimesion, hidden dimesion, and number of layers
       self.input_dim = input_dim
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.num_layers = num_layers

       #initialize the embedding layer with input and embbed dimention
       self.embedding = nn.Embedding(input_dim, self.embbed_dim)
       #intialize the GRU to take the input dimetion of embbed, and output dimention of hidden and
       #set the number of gru layers
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)

   def forward(self, src):
       embedded = self.embedding(src).view(1,1,-1)
       outputs, hidden = self.gru(embedded)
       return outputs, hidden

class Decoder(nn.Module):
   def __init__(self, output_dim, hidden_dim, embbed_dim, num_layers):
       super(Decoder, self).__init__()

#set the encoder output dimension, embed dimension, hidden dimension, and number of layers
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.output_dim = output_dim
       self.num_layers = num_layers

# initialize every layer with the appropriate dimension. For the decoder layer, it will consist of an embedding, GRU, a Linear layer and a Log softmax activation function.
       self.embedding = nn.Embedding(output_dim, self.embbed_dim)
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)
       self.out = nn.Linear(self.hidden_dim, output_dim)
       self.softmax = nn.LogSoftmax(dim=1)

   def forward(self, input, hidden):
# reshape the input to (1, batch_size)
       input = input.view(1, -1)
       embedded = F.relu(self.embedding(input))
       output, hidden = self.gru(embedded, hidden)
       prediction = self.softmax(self.out(output[0]))
       return prediction, hidden

class Seq2Seq(nn.Module):
   def __init__(self, encoder, decoder, device, MAX_LENGTH=MAX_LENGTH):
       super().__init__()

#initialize the encoder and decoder
       self.encoder = encoder
       self.decoder = decoder
       self.device = device

   def forward(self, source, target, teacher_forcing_ratio=0.5):
       input_length = source.size(0) #get the input length (number of words in sentence)
       batch_size = target.shape[1]
       target_length = target.shape[0]
       vocab_size = self.decoder.output_dim

#initialize a variable to hold the predicted outputs
       outputs = torch.zeros(target_length, batch_size, vocab_size).to(self.device)

#encode every word in a sentence
       for i in range(input_length):
           encoder_output, encoder_hidden = self.encoder(source[i])

#use the encoder's hidden layer as the decoder hidden
       decoder_hidden = encoder_hidden.to(device)

#add a token before the first predicted word
       decoder_input = torch.tensor([SOS_token], device=device)  # SOS

#topk is used to get the top K value over a list
#predict the output word from the current target word. If we enable the teaching force, then the next decoder input is the next word, else, use the decoder output highest value.
       for t in range(target_length):
           decoder_output, decoder_hidden = self.decoder(decoder_input, decoder_hidden)
           outputs[t] = decoder_output
           teacher_force = random.random() < teacher_forcing_ratio
           topv, topi = decoder_output.topk(1)
           input = (target[t] if teacher_force else topi)
           if(teacher_force == False and input.item() == EOS_token):
               break

       return outputs
Etapa 3) Treinar o modelo
O processo de treinamento em modelos Seq2seq começa com a conversão de cada par de frases em tensores a partir de seu índice de idioma. Nosso modelo de sequência para sequência usará o SGD como otimizador e a função NLLLoss para calcular as perdas. O processo de treinamento começa com a alimentação do modelo com o par de frases para prever a saída correta. A cada passo, a saída do modelo será calculada com base nas palavras corretas para encontrar as perdas e atualizar os parâmetros. Portanto, como serão usadas 75000 iterações, nosso modelo de sequência para sequência gerará 75000 pares aleatórios a partir do nosso conjunto de dados.
teacher_forcing_ratio = 0.5

def clacModel(model, input_tensor, target_tensor, model_optimizer, criterion):
   model_optimizer.zero_grad()

   input_length = input_tensor.size(0)
   loss = 0
   epoch_loss = 0
   # print(input_tensor.shape)

   output = model(input_tensor, target_tensor)

   num_iter = output.size(0)
   print(num_iter)

#calculate the loss from a predicted sentence with the expected result
   for ot in range(num_iter):
       loss += criterion(output[ot], target_tensor[ot])

   loss.backward()
   model_optimizer.step()
   epoch_loss = loss.item() / num_iter

   return epoch_loss

def trainModel(model, source, target, pairs, num_iteration=20000):
   model.train()

   optimizer = optim.SGD(model.parameters(), lr=0.01)
   criterion = nn.NLLLoss()
   total_loss_iterations = 0

   training_pairs = [tensorsFromPair(source, target, random.choice(pairs))
                     for i in range(num_iteration)]

   for iter in range(1, num_iteration+1):
       training_pair = training_pairs[iter - 1]
       input_tensor = training_pair[0]
       target_tensor = training_pair[1]

       loss = clacModel(model, input_tensor, target_tensor, optimizer, criterion)

       total_loss_iterations += loss

       if iter % 5000 == 0:
           avarage_loss= total_loss_iterations / 5000
           total_loss_iterations = 0
           print('%d %.4f' % (iter, avarage_loss))

   torch.save(model.state_dict(), 'mytraining.pt')
   return model
Etapa 4) Teste o modelo
O processo de avaliação do Seq2seq PyTorO objetivo é verificar a saída do modelo. Cada par de modelos de sequência para sequência será inserido no modelo, que gerará as palavras previstas. Em seguida, você observará o valor mais alto em cada saída para encontrar o índice correto. Por fim, você comparará a previsão do modelo com a frase original.
def evaluate(model, input_lang, output_lang, sentences, max_length=MAX_LENGTH): with torch.no_grad(): input_tensor = tensorFromSentence(input_lang, sentences[0]) output_tensor = tensorFromSentence(output_lang, sentences[1]) decoded_words = [] output = model(input_tensor, output_tensor) # print(output_tensor) for ot in range(output.size(0)): topv, topi = output[ot].topk(1) # print(topi) if topi[0].item() == EOS_token: decoded_words.append('' ) break else: decoded_words.append(output_lang.index2word[topi[0].item()]) return decoded_words def evaluateRandomly(model, source, target, pairs, n=10): for i in range(n): pair = random.choice(pairs) print('source {}'.format(pair[0])) print('target {}'.format(pair[1])) output_words = evaluate(model, source, target, pair) output_sentence = ' '.join(output_words) print('predicted {}'.format(output_sentence))
Agora, vamos começar nosso treinamento com Seq to Seq, com 75000 iterações, 1 camada RNN e tamanho da camada oculta de 512.
lang1 = 'eng'
lang2 = 'ind'
source, target, pairs = process_data(lang1, lang2)

randomize = random.choice(pairs)
print('random sentence {}'.format(randomize))

#print number of words
input_size = source.n_words
output_size = target.n_words
print('Input : {} Output : {}'.format(input_size, output_size))

embed_size = 256
hidden_size = 512
num_layers = 1
num_iteration = 100000

#create encoder-decoder model
encoder = Encoder(input_size, hidden_size, embed_size, num_layers)
decoder = Decoder(output_size, hidden_size, embed_size, num_layers)

model = Seq2Seq(encoder, decoder, device).to(device)

#print model
print(encoder)
print(decoder)

model = trainModel(model, source, target, pairs, num_iteration)
evaluateRandomly(model, source, target, pairs)
Como você pode ver, nossa frase prevista não corresponde muito bem, então, para obter maior precisão, você precisa treinar com muito mais dados e tentar adicionar mais iterações e número de camadas usando Sequence para sequenciar o aprendizado.
random sentence ['tom is finishing his work', 'tom sedang menyelesaikan pekerjaannya']
Input : 3551 Output : 4253
Encoder(
  (embedding): Embedding(3551, 256)
  (gru): GRU(256, 512)
)
Decoder(
  (embedding): Embedding(4253, 256)
  (gru): GRU(256, 512)
  (out): Linear(in_features=512, out_features=4253, bias=True)
  (softmax): LogSoftmax()
)
5000 4.0906
10000 3.9129
15000 3.8171
20000 3.8369
25000 3.8199
30000 3.7957
75000 3.7044
